
Recherche
Filtre actif, cliquez pour en enlever un tag :
Cliquez sur un tag pour affiner votre recherche :
Résultat de la recherche (1 notes) :
Héberger des open weights chez Scaleway et OVH : modèles, serveurs et coûts
Après avoir publié ma note "Qu'est-ce que je dois faire signer à mes clients pour être autorisé à analyser leurs données confidentielles avec un LLM ?" je souhaite maintenant identifier les modèles Open Weights que je peux héberger sur les offres GPU Instances de Scaleway et Cloud GPU d'OVH, et à quel coût.
Note : dans ce document, tous les tarifs sont exprimés hors taxes et ont été relevés le 11 septembre 2026.
Version courte
Pour les lecteurs pressés, voici la version courte :
- MiniMax M2.5 hébergé sur 4x H100 coûte de 7 770 € à 9 322 €/mois en continu, ou de 806 € à 919 €/mois pour 72 h.
- DeepSeek-V4-Flash-Vision-Exp hébergé sur 4x ou 8x H200 ou 8x B300, coûte de 16 877 € à 43 800 €/mois en continu, ou de 1 664 € à 4 320 €/mois pour 72 h.
- Ces environnements peuvent confortablement servir environ 32 utilisateurs simultanés, soit environ 200 utilisateurs actifs.
Comment j'ai fait ma sélection de modèle à analyser ?
Pour faire ma sélection de modèle, je me suis basé sur Browse all vLLM recipes et les cookbooks de SGLang, j'ai parcouru toutes les listes et j'ai sélectionné deux modèles aux profils complémentaires : un petit modèle, léger à héberger et que je trouve utile malgré ses limites, et un modèle plus puissant.
Je suis arrivé à la sélection suivante :
- Pour le modèle peu puissant, j'ai sélectionné MiniMax M2.5, dont les capacités se situent entre Claude Sonnet 4.5 (sorti en septembre 2025) et Sonnet 4.6 (sorti en février 2026)
- DeepSeek-V4-Flash-Vision-Exp avec le support de la vision. Cela correspond à mon modèle préféré du moment, pour cela voir ma note Septembre 2026 - je code avec des open weights pour 10 à 30 € par mois
Et voici les serveurs requis pour les faire tourner, indiqués dans leurs recettes vLLM :
- 4x H100 pour MiniMax M2.5 (recette vLLM)
- 4x H200 ou 8x B300 pour DeepSeek-V4-Flash-Vision-Exp (recette vLLM)
Les offres GPU de Scaleway et OVH retenues
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-2-80G | 6,62 € | 4 832 € |
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| Scaleway | H100-SXM-8-80G | 25,33 € | 18 491 € |
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H100 PCIe (80 Go HBM2e) | 11,2 € | 7 770 € |
| OVH | 4x H200 (141 Go HBM3e) | 23,12 € | 16 877 € |
| OVH | 8x H200 (141 Go HBM3e) | 42 € | 30 660 € |
Pages :
- https://www.scaleway.com/fr/tarifs/gpu/?zone=fr-par-2
- https://www.ovhcloud.com/fr/public-cloud/prices/#cloud-gpu
Offres pour faire tourner DeepSeek-V4-Flash-Vision-Exp ?
Tout d'abord, j'ai observé que DeepSeek-V4-Flash-Vision-Exp (~168 Go, recette vLLM) a pratiquement la même taille que DeepSeek-V4-Flash-0731 (~167 Go, checkpoint fused, recette vLLM), l'écart est de moins de 1 Go pour intégrer les couches vision. Par conséquent, je suppose qu'un serveur qui permet de faire tourner la version DeepSeek-V4-Flash peut faire tourner la version DeepSeek-V4-Flash-Vision-Exp.
J'apporte ici ces précisions car la recette vLLM de DeepSeek-V4-Flash contient plus de hardware validé que celle de vLLM de DeepSeek-V4-Flash-Vision-Exp, qui ne valide un run vision que sur 4xGB200. Le cookbook SGLang documente de son côté un run vérifié sur 4xB200. Toujours dans le cookbook SGLang, l'installation sur 4xH200 est annoncée comme pending, même si des essais communautaires sur cette config existent déjà (avec un bug connu sur les tool calls multi-tours).
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, il est probable que DeepSeek-V4-Flash-Vision-Exp peut charger sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H200 | 23,12 € | 16 877 € |
| OVH | 8x H200 | 42 € | 30 660 € |
Attention : la recette annonce une context window de 1M de tokens, mais elle est explicite sur ce point — cette valeur est annoncée, non mesurée (le run de référence tourne en 32K) et le KV cache d'un contexte 1M réclame bien plus de mémoire que les poids (~202 Go de VRAM avant KV cache). Ces offres garantissent donc le chargement du modèle, pas le service de 1M de tokens ; le contexte réellement tenable reste à mesurer.
J'ai effectué des recherches pour savoir si le modèle pouvait tourner sur 8x H100. D'après les retours, il peut démarrer mais reste instable et bridé en contexte sur cette génération :
| Source | Config | Contexte testé | Statut |
|---|---|---|---|
| #52065 | 8x H100 80G, TP8+EP, fp8 KV, util 0.90 | 65 536 (64K) | Fonctionne sur vLLM 0.26.0, crash sur 0.27.0 avec DSpark |
| #51326 | 8x H100 80G, TP8+EP, util 0.84 | Non précisé | Sortie corrompue sur 0.26.0, correcte sur 0.25.0 |
La variante Vision-Exp stocke ses experts MoE en FP4, un format que seuls les GPU Blackwell accélèrent nativement, et ne publie, côté vLLM, aucun run vision en dehors de GB200 (4x). La recette décrit toutefois une stratégie pour des nœuds 8-GPU H200/B200/B300, mais sans run vision vérifié sur ces machines ; son exécution sur H100 reste donc, au mieux, expérimentale et limitée en contexte.
Offres pour faire tourner MiniMax M2.5 ?
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, je pense que MiniMax M2.5 peut tourner avec une context window de 192K de tokens sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| OVH | 4x H100 (80 Go HBM2) | 11,2 € | 7 770 € |
Tarifs si les serveurs sont loués seulement sur certaines plages horaires
En théorie, si les GPUs sont disponibles dans les stocks des providers, il est possible de les instancier et de les libérer à la demande.
Je pense que si les volumes des disques des VMs sont sauvegardés, une instance doit pouvoir se lancer en quelques minutes, sinon je pense qu'une instance doit pouvoir être provisionnée de zéro en quelques dizaines de minutes.
Je vais faire quelques estimations en fonction des hypothèses de disponibilité suivantes :
- 4 jours par semaine, de 14h à 18h (avec 30 min de démarrage) : 4h30 x 4 x 4 = 72h par mois
- 4 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 4 x 4 = 152h par mois
- 5 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 5 x 4 = 190h par mois
| Provider | Type de serveur | LLM | Prix à l'heure | 72h / mois | 152h / mois | 190h / mois |
|---|---|---|---|---|---|---|
| Scaleway | 4x H100 | MiniMax | 12,77 € | 919 € | 1 941 € | 2 426 € |
| OVH | 4x H100 | MiniMax | 11,2 € | 806 € | 1 702 € | 2 128 € |
| Scaleway | 8x B300 | DeepSeek | 60 € | 4 320 € | 9 120 € | 11 400 € |
| OVH | 4x H200 | DeepSeek | 23,12 € | 1 664 € | 3 514 € | 4 392 € |
| OVH | 8x H200 | DeepSeek | 42 € | 3 024 € | 6 384 € | 7 980 € |
Attention toutefois, il est nécessaire de passer par le support de Scaleway pour accéder aux instances B300 :
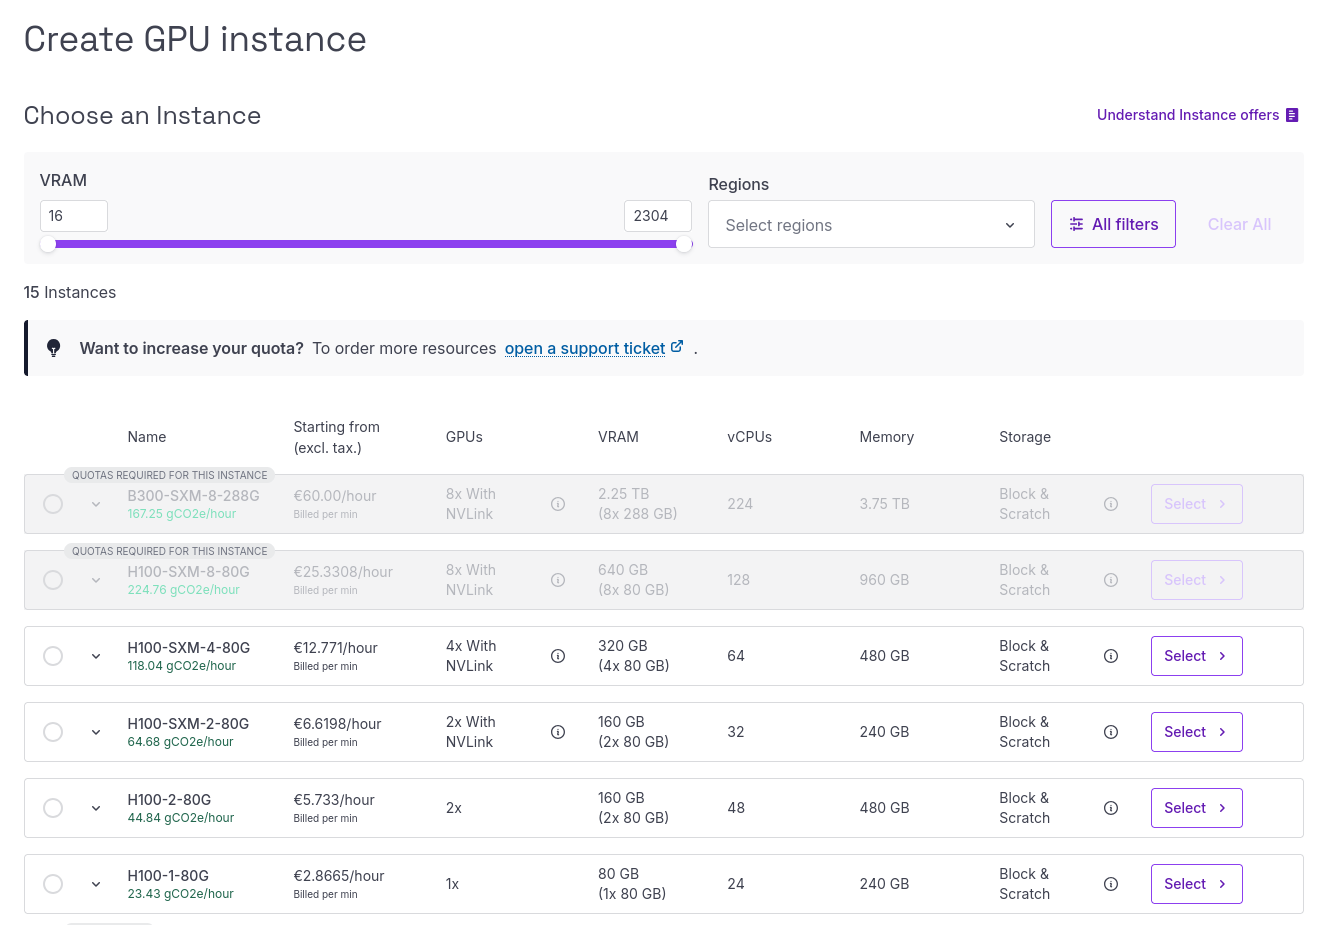
Peut-être qu'il n'est pas possible de louer ce type de machine avec une totale liberté, ce que je pourrais comprendre pour du matériel (8xB300) que Sonnet 5 estime à l'achat entre 300 K€ et 500 K€ pour un serveur complet de 8 GPU.
Estimation du nombre d'utilisateurs simultanés et du débit en tokens par seconde ?
vLLM et SGLang documentent des méthodes de calcul et de benchmark pour faire ce genre d'estimation, par exemple : Parallelism and Scaling, Benchmark CLI, vllm bench serve, Benchmark and Profiling, Bench Serving Guide. Mais je n'ai pas voulu me lancer en profondeur dans ce sujet, d'autant plus que j'ai l'impression que pour obtenir des informations concrètes il est nécessaire de lancer des outils sur l'environnement installé sur le serveur.
À la place, j'ai préféré prendre un raccourci et me baser sur les mesures que j'ai trouvées sur des pages du site Lambda : How to deploy DeepSeek-V4-Flash on Lambda et How to deploy MiniMax M2.5 on Lambda.
Je ne vais pas entrer dans les détails, mais voici les mesures pour DeepSeek-V4-Flash pour 32 utilisateurs en parallèle avec des prompts de 8192 tokens en entrée :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 8x B200 (FP4+FP8 natif) | 38 tok/s | 1 701 ms | 66 ms |
| SGLang | 8x H100 (FP8 quantifié) | 39 tok/s | 2 463 ms | 60 ms |
| vLLM | 8x B200 (FP4+FP8 natif) | 46 tok/s | 1 452 ms | 20 ms |
La même chose pour MiniMax M2.5, toujours pour 32 utilisateurs :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 2x B200 | 28 tok/s | 3 091 ms | 36 ms |
| SGLang | 4x H100 | 27 tok/s | 13 131 ms | 27 ms |
Voici comment je lis ces chiffres :
TTFT(Time To First Token) : délai avant le premier token affiché à l'écran.ITL(Inter-Token Latency) : écart entre deux tokens consécutifs pendant le decode.- Le débit par utilisateur (27 à 46 tok/s) dépasse la lecture humaine (5 à 10 tok/s), donc l'expérience est confortable. Cette vitesse vaut aussi pour les tokens de réflexion.
La config MiniMax 4xH100 est exactement celle que j'ai retenue chez Scaleway et OVH. Le benchmark s'applique donc directement, contrairement à DeepSeek où Lambda mesure du 8-GPU B200/H100 alors que je vise du 4x ou 8x H200.
Conclusion, en me basant sur ces mesures, je peux espérer qu'avec ces serveurs, l'expérience d'utilisation de ces modèles soit agréable pour 32 utilisateurs en simultané.
C'est un ordre de grandeur : avec DeepSeek, j'ai estimé qu'en réalité un nœud peut servir environ 200 utilisateurs actifs, puisque personne n'envoie de requêtes en continu.
Dernière page.