
Scaleway
Article wikipedia : https://fr.wikipedia.org/wiki/Scaleway
Journaux liées à cette note :
Héberger des open weights chez Scaleway et OVH : modèles, serveurs et coûts
Après avoir publié ma note "Qu'est-ce que je dois faire signer à mes clients pour être autorisé à analyser leurs données confidentielles avec un LLM ?" je souhaite maintenant identifier les modèles Open Weights que je peux héberger sur les offres GPU Instances de Scaleway et Cloud GPU d'OVH, et à quel coût.
Note : dans ce document, tous les tarifs sont exprimés hors taxes et ont été relevés le 11 septembre 2026.
Version courte
Pour les lecteurs pressés, voici la version courte :
- MiniMax M2.5 hébergé sur 4x H100 coûte de 7 770 € à 9 322 €/mois en continu, ou de 806 € à 919 €/mois pour 72 h.
- DeepSeek-V4-Flash-Vision-Exp hébergé sur 4x ou 8x H200 ou 8x B300, coûte de 16 877 € à 43 800 €/mois en continu, ou de 1 664 € à 4 320 €/mois pour 72 h.
- Ces environnements peuvent confortablement servir environ 32 utilisateurs simultanés, soit environ 200 utilisateurs actifs.
Comment j'ai fait ma sélection de modèle à analyser ?
Pour faire ma sélection de modèle, je me suis basé sur Browse all vLLM recipes et les cookbooks de SGLang, j'ai parcouru toutes les listes et j'ai sélectionné deux modèles aux profils complémentaires : un petit modèle, léger à héberger et que je trouve utile malgré ses limites, et un modèle plus puissant.
Je suis arrivé à la sélection suivante :
- Pour le modèle peu puissant, j'ai sélectionné MiniMax M2.5, dont les capacités se situent entre Claude Sonnet 4.5 (sorti en septembre 2025) et Sonnet 4.6 (sorti en février 2026)
- DeepSeek-V4-Flash-Vision-Exp avec le support de la vision. Cela correspond à mon modèle préféré du moment, pour cela voir ma note Septembre 2026 - je code avec des open weights pour 10 à 30 € par mois
Et voici les serveurs requis pour les faire tourner, indiqués dans leurs recettes vLLM :
- 4x H100 pour MiniMax M2.5 (recette vLLM)
- 4x H200 ou 8x B300 pour DeepSeek-V4-Flash-Vision-Exp (recette vLLM)
Les offres GPU de Scaleway et OVH retenues
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-2-80G | 6,62 € | 4 832 € |
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| Scaleway | H100-SXM-8-80G | 25,33 € | 18 491 € |
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H100 PCIe (80 Go HBM2e) | 11,2 € | 7 770 € |
| OVH | 4x H200 (141 Go HBM3e) | 23,12 € | 16 877 € |
| OVH | 8x H200 (141 Go HBM3e) | 42 € | 30 660 € |
Pages :
- https://www.scaleway.com/fr/tarifs/gpu/?zone=fr-par-2
- https://www.ovhcloud.com/fr/public-cloud/prices/#cloud-gpu
Offres pour faire tourner DeepSeek-V4-Flash-Vision-Exp ?
Tout d'abord, j'ai observé que DeepSeek-V4-Flash-Vision-Exp (~168 Go, recette vLLM) a pratiquement la même taille que DeepSeek-V4-Flash-0731 (~167 Go, checkpoint fused, recette vLLM), l'écart est de moins de 1 Go pour intégrer les couches vision. Par conséquent, je suppose qu'un serveur qui permet de faire tourner la version DeepSeek-V4-Flash peut faire tourner la version DeepSeek-V4-Flash-Vision-Exp.
J'apporte ici ces précisions car la recette vLLM de DeepSeek-V4-Flash contient plus de hardware validé que celle de vLLM de DeepSeek-V4-Flash-Vision-Exp, qui ne valide un run vision que sur 4xGB200. Le cookbook SGLang documente de son côté un run vérifié sur 4xB200. Toujours dans le cookbook SGLang, l'installation sur 4xH200 est annoncée comme pending, même si des essais communautaires sur cette config existent déjà (avec un bug connu sur les tool calls multi-tours).
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, il est probable que DeepSeek-V4-Flash-Vision-Exp peut charger sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H200 | 23,12 € | 16 877 € |
| OVH | 8x H200 | 42 € | 30 660 € |
Attention : la recette annonce une context window de 1M de tokens, mais elle est explicite sur ce point — cette valeur est annoncée, non mesurée (le run de référence tourne en 32K) et le KV cache d'un contexte 1M réclame bien plus de mémoire que les poids (~202 Go de VRAM avant KV cache). Ces offres garantissent donc le chargement du modèle, pas le service de 1M de tokens ; le contexte réellement tenable reste à mesurer.
J'ai effectué des recherches pour savoir si le modèle pouvait tourner sur 8x H100. D'après les retours, il peut démarrer mais reste instable et bridé en contexte sur cette génération :
| Source | Config | Contexte testé | Statut |
|---|---|---|---|
| #52065 | 8x H100 80G, TP8+EP, fp8 KV, util 0.90 | 65 536 (64K) | Fonctionne sur vLLM 0.26.0, crash sur 0.27.0 avec DSpark |
| #51326 | 8x H100 80G, TP8+EP, util 0.84 | Non précisé | Sortie corrompue sur 0.26.0, correcte sur 0.25.0 |
La variante Vision-Exp stocke ses experts MoE en FP4, un format que seuls les GPU Blackwell accélèrent nativement, et ne publie, côté vLLM, aucun run vision en dehors de GB200 (4x). La recette décrit toutefois une stratégie pour des nœuds 8-GPU H200/B200/B300, mais sans run vision vérifié sur ces machines ; son exécution sur H100 reste donc, au mieux, expérimentale et limitée en contexte.
Offres pour faire tourner MiniMax M2.5 ?
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, je pense que MiniMax M2.5 peut tourner avec une context window de 192K de tokens sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| OVH | 4x H100 (80 Go HBM2) | 11,2 € | 7 770 € |
Tarifs si les serveurs sont loués seulement sur certaines plages horaires
En théorie, si les GPUs sont disponibles dans les stocks des providers, il est possible de les instancier et de les libérer à la demande.
Je pense que si les volumes des disques des VMs sont sauvegardés, une instance doit pouvoir se lancer en quelques minutes, sinon je pense qu'une instance doit pouvoir être provisionnée de zéro en quelques dizaines de minutes.
Je vais faire quelques estimations en fonction des hypothèses de disponibilité suivantes :
- 4 jours par semaine, de 14h à 18h (avec 30 min de démarrage) : 4h30 x 4 x 4 = 72h par mois
- 4 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 4 x 4 = 152h par mois
- 5 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 5 x 4 = 190h par mois
| Provider | Type de serveur | LLM | Prix à l'heure | 72h / mois | 152h / mois | 190h / mois |
|---|---|---|---|---|---|---|
| Scaleway | 4x H100 | MiniMax | 12,77 € | 919 € | 1 941 € | 2 426 € |
| OVH | 4x H100 | MiniMax | 11,2 € | 806 € | 1 702 € | 2 128 € |
| Scaleway | 8x B300 | DeepSeek | 60 € | 4 320 € | 9 120 € | 11 400 € |
| OVH | 4x H200 | DeepSeek | 23,12 € | 1 664 € | 3 514 € | 4 392 € |
| OVH | 8x H200 | DeepSeek | 42 € | 3 024 € | 6 384 € | 7 980 € |
Attention toutefois, il est nécessaire de passer par le support de Scaleway pour accéder aux instances B300 :
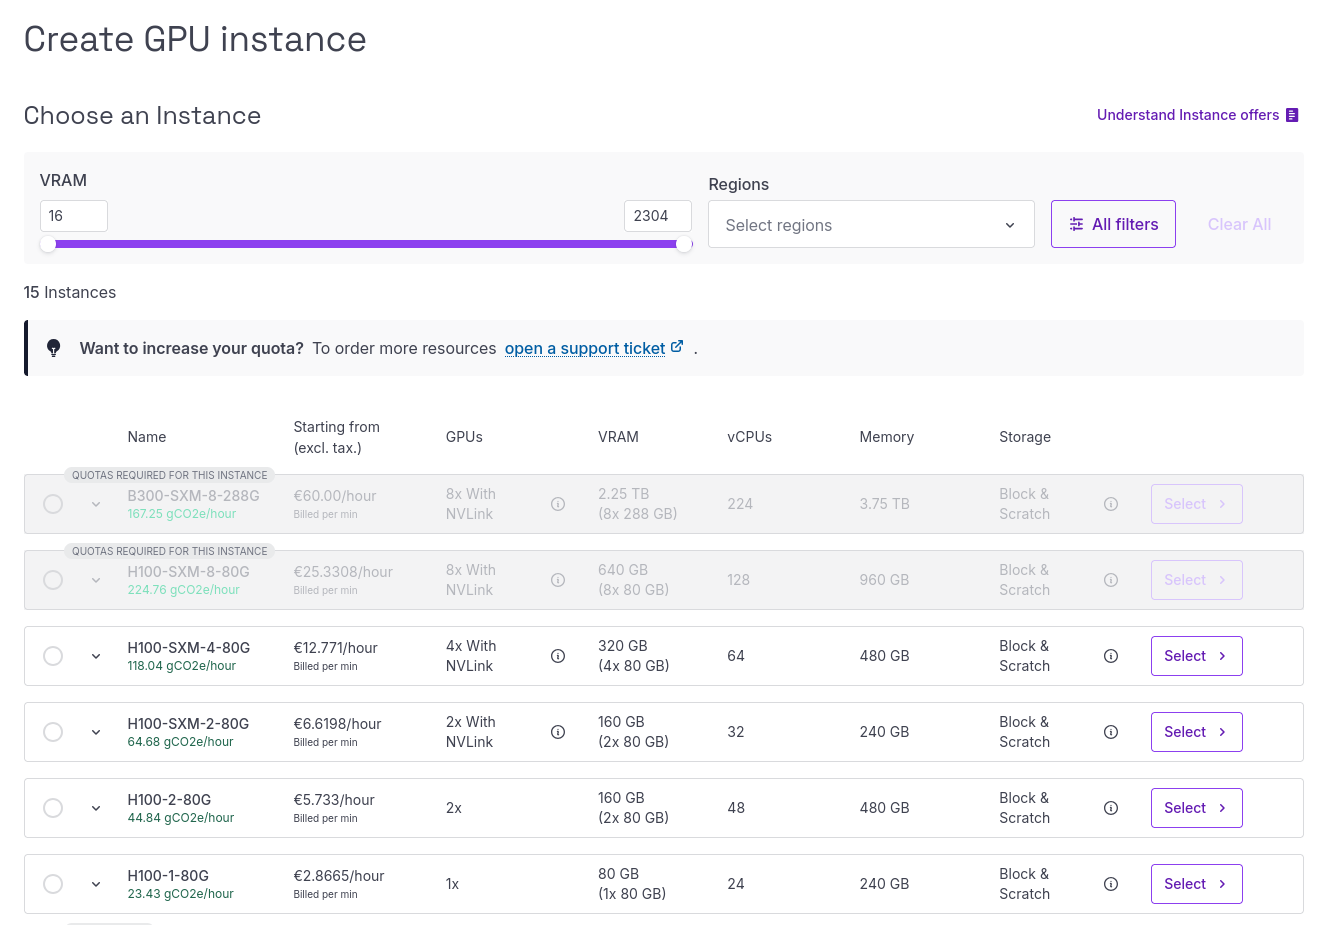
Peut-être qu'il n'est pas possible de louer ce type de machine avec une totale liberté, ce que je pourrais comprendre pour du matériel (8xB300) que Sonnet 5 estime à l'achat entre 300 K€ et 500 K€ pour un serveur complet de 8 GPU.
Estimation du nombre d'utilisateurs simultanés et du débit en tokens par seconde ?
vLLM et SGLang documentent des méthodes de calcul et de benchmark pour faire ce genre d'estimation, par exemple : Parallelism and Scaling, Benchmark CLI, vllm bench serve, Benchmark and Profiling, Bench Serving Guide. Mais je n'ai pas voulu me lancer en profondeur dans ce sujet, d'autant plus que j'ai l'impression que pour obtenir des informations concrètes il est nécessaire de lancer des outils sur l'environnement installé sur le serveur.
À la place, j'ai préféré prendre un raccourci et me baser sur les mesures que j'ai trouvées sur des pages du site Lambda : How to deploy DeepSeek-V4-Flash on Lambda et How to deploy MiniMax M2.5 on Lambda.
Je ne vais pas entrer dans les détails, mais voici les mesures pour DeepSeek-V4-Flash pour 32 utilisateurs en parallèle avec des prompts de 8192 tokens en entrée :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 8x B200 (FP4+FP8 natif) | 38 tok/s | 1 701 ms | 66 ms |
| SGLang | 8x H100 (FP8 quantifié) | 39 tok/s | 2 463 ms | 60 ms |
| vLLM | 8x B200 (FP4+FP8 natif) | 46 tok/s | 1 452 ms | 20 ms |
La même chose pour MiniMax M2.5, toujours pour 32 utilisateurs :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 2x B200 | 28 tok/s | 3 091 ms | 36 ms |
| SGLang | 4x H100 | 27 tok/s | 13 131 ms | 27 ms |
Voici comment je lis ces chiffres :
TTFT(Time To First Token) : délai avant le premier token affiché à l'écran.ITL(Inter-Token Latency) : écart entre deux tokens consécutifs pendant le decode.- Le débit par utilisateur (27 à 46 tok/s) dépasse la lecture humaine (5 à 10 tok/s), donc l'expérience est confortable. Cette vitesse vaut aussi pour les tokens de réflexion.
La config MiniMax 4xH100 est exactement celle que j'ai retenue chez Scaleway et OVH. Le benchmark s'applique donc directement, contrairement à DeepSeek où Lambda mesure du 8-GPU B200/H100 alors que je vise du 4x ou 8x H200.
Conclusion, en me basant sur ces mesures, je peux espérer qu'avec ces serveurs, l'expérience d'utilisation de ces modèles soit agréable pour 32 utilisateurs en simultané.
C'est un ordre de grandeur : avec DeepSeek, j'ai estimé qu'en réalité un nœud peut servir environ 200 utilisateurs actifs, puisque personne n'envoie de requêtes en continu.
Dernièrement, un ami m'a demandé : « qu'est-ce que je dois faire signer à mes clients pour être autorisé légalement à analyser leurs données confidentielles à l'aide d'un LLM, en fonction des types d'hébergement qui s'offrent à moi ? ».
Il travaille dans une entreprise sous-traitante industrielle. Contrairement à ma note du mois de juin, cette fois il ne s'agit pas de Données de santé (DDS), ni de PII, mais de secrets industriels. D'après ce que j'ai compris, le sujet est surtout contractuel.
Pour la suite de cette note, j'appelle Verdier Industries (nom fictif) l'entreprise de mon ami, afin d'incarner mes propos.
Dans cette note, je veux être très pratique : je souhaite générer des exemples de documents légaux à faire signer aux clients de Verdier Industries en fonction des options suivantes :
- a. LLM en SaaS hors UE
- b. LLM en SaaS en Europe hors France
- c. LLM en SaaS en France
- d. LLM installé sur une machine virtuelle avec GPU, louée chez Scaleway, OVH, etc.
- e. LLM installé sur un serveur physique dans ses locaux
Idéalement, je souhaite pouvoir facilement comparer ces documents légaux et analyser l'impact que cela aura sur la relation commerciale.
Lesquels risquent de faire peur à ses clients ou au contraire de les rassurer.
Avant d'entrer dans le détail, une précision sur le terme « accès à un LLM ». Si je simplifie, un LLM s'utilise de deux façons très différentes :
- via une interface de chat, dans un navigateur ou une application : c'est le cas de ChatGPT, Claude, Le Chat (Mistral AI), etc. Une personne écrit un message, le modèle répond. Ces noms désignent des interfaces de chat, pas le modèle qui est derrière. Les modèles portent d'autres noms.
- via une API : une sorte de porte d'entrée technique qui permet à un logiciel d'envoyer des demandes au modèle automatiquement, sans qu'un humain tape dans une fenêtre de chat. Quelques exemples de modèles connus au mois de septembre 2026 : GPT-5.6 Sol, Claude Sonnet 5, DeepSeek 4.1 Flash.
Dans cette note, je ne traite que du second cas, l'accès par API.
La raison : c'est le modèle LLM qui est très difficile à héberger soi-même, pas l'interface de chat.
Un LLM a besoin de serveurs puissants, équipés de GPU coûteux. Une fois qu'on dispose d'un accès au modèle, héberger une interface de chat comme Open WebUI ou LibreChat est plutôt facile, car ces services fonctionnent sur des machines modestes.
Autrement dit, les cinq options ci-dessous décrivent surtout où et comment on accède au modèle, pas comment on l'affiche à l'écran.
Une dernière précision : cette note traite uniquement des questions légales. Je compte publier une autre note pour tout ce qui concerne les estimations de coût d'hébergement pour chacune de ces options.
Je détaille les cinq options d'accès à un LLM
J'ai fait le choix de découper les offres commerciales réellement disponibles pour chacune de ces options par localisation du traitement des données, et non pas par juridiction du fournisseur.
J'ai indiqué la juridiction du fournisseur dans le tableau de synthèse en fin de section. Je tiens à préciser que cette question de juridiction n'est pas anecdotique pour les clients.
Solutions SaaS
Un service SaaS, ici, veut dire que le modèle est fourni et exécuté par un tiers : les données de Verdier Industries et de ses clients partent chez le fournisseur, qui renvoie une réponse. Contrairement aux solutions IaaS, Verdier Industries n'a donc pas besoin d'un administrateur système, interne ou externe, pour gérer le serveur qui fait tourner le modèle, ni pour s'occuper du modèle.
LLM en SaaS hors UE (a)
Lieu de traitement des données : hors de l'Union européenne.
Les offres les plus courantes en API directe chez des producteurs de LLM sont :
On trouve aussi des AI providers comme Deepinfra ou Together AI.
LLM en SaaS en Europe hors France (b)
Lieu de traitement des données : dans l'UE, mais le fournisseur n'est pas français.
Côté américain, l'endpoint européen d'OpenAI traite les données en Irlande (Dublin). Attention, le contrat reste conclu avec une entité américaine : OpenAI reste donc soumis au Cloud Act.
On y trouve aussi des acteurs européens comme :
- IONOS et leur offre AI Model Hub
- ou STACKIT et leur offre AI Model Serving
mais ces deux acteurs offrent un accès seulement à des modèles peu puissants.
LLM en SaaS en France (c)
Lieu de traitement des données : en France.
Les offres portées par une entité française sont :
- Mistral AI
- OVHcloud avec AI Endpoints
- Scaleway avec Generative APIs
En septembre 2026, Mistral AI et OVHcloud ne proposent que des modèles très peu puissants, bien loin derrière GLM-5.2 ou DeepSeek V4 Flash 0731 proposé par Scaleway.
Les acteurs américains peuvent aussi traiter dans des data centers en France, à condition de choisir explicitement un déploiement mono-région :
- AWS avec Bedrock
- Azure avec Azure OpenAI
- Google Cloud avec Vertex AI
- Together AI avec leur offre Dedicated inference, tuned for production
Pour tous ces acteurs, le contrat reste conclu avec une entité américaine : ils restent donc soumis au Cloud Act.
Solutions IaaS en France (d)
Une machine virtuelle avec GPU louée, c'est de l'IaaS : seule l'infrastructure est louée, le modèle LLM est installé et administré par un informaticien administrateur système de Verdier Industries. Le fournisseur n'a donc pas accès à l'OS de la machine virtuelle, donc pas aux données traitées.
Nuance : sur une machine virtuelle, l'hébergeur contrôle l'hyperviseur et pourrait en théorie accéder à la mémoire de la VM, ce qui n'est pas le cas sur un serveur bare metal.
- Quelques acteurs français :
- Scaleway, offres GPU Instances
- OVH, offres Cloud GPU
- Outscale, offres GPU NVIDIA
- Cloud Temple
- Acteurs américains dans leur datacenter en France soumis au Cloud Act :
- Together AI, offres GPU clusters
- AWS, offres Accelerated computing Amazon EC2 instance types
- Azure, offres GPU accelerated VM size series
- Google Cloud, offres accelerator-optimized
Sur site, un serveur dans les locaux de Verdier Industries (e)
Le serveur est dans les locaux de Verdier Industries : aucun tiers n'intervient, ni pour la machine, ni pour le modèle.
L'informaticien administrateur système de Verdier Industries doit prendre en charge l'installation, sur ce serveur, de logiciels comme vLLM, Ollama ou llama.cpp permettant d'instancier des LLM.
À ce coût matériel, DeepSeek V4 Flash me dit qu'il faut ajouter la facture d'électricité : un serveur 8x H100 ou H200 consomme de l'ordre de 10 kW au niveau informatique et 14 kW au niveau de l'installation, refroidissement inclus, soit de l'ordre de 15 000 à 30 000 € par an à pleine charge selon le prix du kWh.
Concrètement, un tel serveur ne peut pas être placé dans une pièce de bureaux : il faut une alimentation électrique dédiée, un refroidissement dimensionné et une pièce isolée acoustiquement.
Tableau de synthèse
| Option | Fournisseur | Pays de l'entité | Datacenter | Résidence UE | Exposition CLOUD Act |
|---|---|---|---|---|---|
| SaaS hors UE | OpenAI | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | Anthropic | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | États-Unis | États-Unis | Non | Oui | |
| SaaS hors UE | Deepinfra | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | Together AI | États-Unis | États-Unis | Non | Oui |
| SaaS Europe hors France | OpenAI | États-Unis | UE (Irlande) | Oui | Oui |
| SaaS Europe hors France | IONOS | Allemagne | UE | Oui | Non |
| SaaS Europe hors France | STACKIT | Allemagne | UE | Oui | Non |
| SaaS en France | Mistral AI | France | France | Oui | Non |
| SaaS en France | Scaleway | France | France | Oui | Non |
| SaaS en France | OVHcloud | France | France | Oui | Non |
| SaaS en France | AWS | États-Unis | France | Oui | Oui |
| SaaS en France | Microsoft | États-Unis | France | Oui | Oui |
| SaaS en France | États-Unis | France | Oui | Oui | |
| SaaS en France | Together AI | États-Unis | France | Oui | Oui |
| IaaS | Scaleway | France | France | Oui | Non |
| IaaS | OVHcloud | France | France | Oui | Non |
| IaaS | Outscale | France | France | Oui | Non |
| IaaS | Cloud Temple | France | France | Oui | Non |
| IaaS | Together AI | États-Unis | France | Oui | Oui |
| IaaS | AWS | États-Unis | France | Oui | Oui |
| IaaS | Microsoft | États-Unis | France | Oui | Oui |
| IaaS | États-Unis | France | Oui | Oui | |
| Sur site | — | Auto-hébergé | Locaux de Verdier Industries | Oui | Non |
Les 6 situations contractuelles
À partir de toutes les options d'hébergement d'un LLM listées précédemment, voici la liste de toutes les situations contractuelles.
Le classement va du plus simple à opérer (SaaS hors UE) au plus difficile (serveur sur site).
| Cas | Option | Exposition des données à un tiers | Transfert hors UE | Cloud Act |
|---|---|---|---|---|
| 1 | (a) SaaS hors UE | Oui | Oui | Oui |
| 2 | (b/c) SaaS datacenter en UE ou FR, entité US | oui | Non | Oui |
| 3 | (b/c) SaaS datacenter en UE ou FR, entité UE | oui | Non | Non |
| 4 | (d) IaaS US avec datacenter en FR | non | Non | Oui |
| 5 | (d) IaaS FR avec data center en FR | non | Non | Non |
| 6 | (e) sur site | aucun tiers | Non | Non |
Liste des démarches administratives à effectuer pour chaque situation contractuelle
Je pars de la situation suivante : Verdier Industries a déjà 50 clients sous contrat, il décide de réaliser les démarches légales auprès de ses clients afin d'être autorisé à envoyer des données confidentielles de ses clients à son LLM à travers la solution qu'il a retenue. Quels sont les documents à produire, envoyer au client, faire signer, etc.
Hypothèse générale : les contrats clients interdisent la divulgation des données confidentielles à un tiers sans accord écrit. Un avenant signé est donc nécessaire.
J'ai dressé la liste des étapes de ces procédures administratives avec l'aide de DeepSeek V4.1 Flash.
Cas 1 - SaaS hors UE
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple OpenAI) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- ses CCT (Clauses Contractuelles Types), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD) et annexe des CCT.
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Selon ce que prévoit le contrat client pour le RGPD :
- Si le contrat contient une autorisation générale, par exemple : « Le client autorise Verdier Industries à recourir à des sous-traitants ultérieurs. Verdier Industries informe le client par écrit au moins 30 jours à l'avance, et le client peut s'opposer à cette modification. » Alors, pour le RGPD, Verdier envoie une simple notification, et si le client ne s'oppose pas dans les 30 jours, le nouveau sous-traitant est accepté, sans signature.
- Si le contrat contient une autorisation spécifique, par exemple : « Verdier Industries ne peut confier les données à un sous-traitant ultérieur qu'après accord écrit préalable du client. » Alors Verdier doit faire signer l'avenant pour le RGPD aussi.
- Dans les deux cas, ces clauses ne couvrent ni les secrets industriels ni le risque Cloud Act : pour ces deux points, l'avenant doit être signé.
Cas 2 - SaaS datacenter en UE ou FR, entité US
Les données sont traitées dans l'UE, mais le fournisseur est une entité américaine : il reste soumis au Cloud Act. Comme il n'y a pas de transfert hors UE, les CCT ne sont pas nécessaires.
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple l'endpoint européen d'OpenAI) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels et le risque Cloud Act imposent une signature.
Cas 3 - SaaS datacenter en UE ou FR, entité UE
Les données sont traitées dans l'UE par une entité européenne : ni transfert hors UE, ni exposition au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple Scaleway) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels impose une signature.
Cas 4 - IaaS US avec datacenter en FR
L'infrastructure est louée chez un hébergeur américain. L'hébergeur n'accède pas au contenu des données, mais il reste soumis au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son hébergeur (par exemple AWS) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-accès au contenu des données hébergées : mémoire vive, volumes de stockage et snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017 et 27018.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation d'héberger les données sur une infrastructure tierce ;
- article 2 : Verdier Industries garantit que l'hébergeur n'a pas accès au contenu des données, son accès étant limité à l'infrastructure nécessaire à l'hébergement, hors réquisition d'une autorité judiciaire ou administrative compétente ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels et le risque Cloud Act imposent une signature.
L'engagement de non-accès demandé à l'hébergeur peut être rédigé ainsi :
L'hébergeur s'engage à ne pas accéder au contenu des données hébergées, en particulier à la mémoire vive, aux volumes de stockage et aux snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente. En cas de réquisition, l'hébergeur en informe Verdier Industries dans les meilleurs délais, sauf si la loi lui interdit de le faire.
Cas 5 - IaaS FR avec data center en FR
L'infrastructure est louée chez un hébergeur français ou européen : ni transfert hors UE, ni exposition au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son hébergeur (par exemple Scaleway) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-accès au contenu des données hébergées : mémoire vive, volumes de stockage et snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017 et 27018, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation d'héberger les données sur une infrastructure tierce ;
- article 2 : Verdier Industries garantit que l'hébergeur n'a pas accès au contenu des données, son accès étant limité à l'infrastructure nécessaire à l'hébergement, hors réquisition d'une autorité judiciaire ou administrative compétente ;
- article 3, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels impose une signature.
L'engagement de non-accès demandé à l'hébergeur peut être rédigé ainsi :
L'hébergeur s'engage à ne pas accéder au contenu des données hébergées, en particulier à la mémoire vive, aux volumes de stockage et aux snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente. En cas de réquisition, l'hébergeur en informe Verdier Industries dans les meilleurs délais, sauf si la loi lui interdit de le faire.
Cas 6 - Hébergement sur site
Le serveur est dans les locaux de Verdier Industries : aucun tiers n'intervient.
- Aucun document à obtenir d'un tiers.
- Aucun avenant à faire signer : les données ne quittent pas les locaux et ne sont divulguées à personne.
- Pour rassurer le client, Verdier Industries peut l'informer que le traitement se fait en interne, sans sous-traitant ultérieur.
Liste des différences entre les situations contractuelles
Différences entre cas 2 et cas 1
- Les données restent dans l'UE : les CCT ne sont plus nécessaires.
- Le reste est identique, notamment le risque Cloud Act.
Différences entre cas 3 et cas 2
- Le fournisseur est une entité européenne : plus de risque Cloud Act.
- L'article 3 de l'avenant (acceptation du risque Cloud Act) disparaît.
- Le reste est identique.
Différences entre cas 4 et cas 3
- Le fournisseur ne traite plus les données : l'hébergeur n'accède pas au contenu, et l'avenant le garantit (article 2).
- L'engagement de non-entraînement et de rétention zéro disparaît.
- L'article 1 de l'avenant devient une autorisation d'héberger, et non plus une autorisation de divulgation.
- Le risque Cloud Act réapparaît, car l'hébergeur est américain.
Différences entre cas 5 et cas 3
- Le fournisseur ne traite plus les données : l'hébergeur n'accède pas au contenu, et l'avenant le garantit (article 2).
- L'engagement de non-entraînement et de rétention zéro disparaît, remplacé par un engagement de non-accès au contenu.
- L'article 1 de l'avenant devient une autorisation d'héberger, et non plus une autorisation de divulgation.
- Les certifications attendues sont allégées : plus de 27701 ni 42001, qui n'ont plus de sens quand le fournisseur ne traite pas les données.
- Le reste est identique : ni transfert hors UE, ni risque Cloud Act.
Différences entre cas 5 et cas 4
- L'hébergeur est français ou européen : plus de risque Cloud Act.
- L'article 3 de l'avenant (acceptation du risque Cloud Act) disparaît.
- Le reste est identique.
Différences entre cas 6 et cas 5
- Aucun tiers n'intervient : plus de documents à obtenir ni d'avenant à signer.
- Il ne reste qu'une information au client, sans sous-traitant ultérieur.
Ce que je retiens
En travaillant cette note, je m'attendais, naïvement, à ce que le cas 5 — un LLM installé sur une machine virtuelle avec GPU louée chez un hébergeur français, dans un data center français — soit indolore contractuellement, c'est-à-dire qu'il n'exige aucun avenant aux contrats clients, mais ce n'est pas le cas.
En réalité, l'infrastructure reste louée à un tiers. Les contrats clients interdisent la divulgation des données confidentielles à un tiers sans accord écrit, et même si l'hébergeur n'accède pas au contenu, le fait de lui confier l'infrastructure qui porte les données déclenche quand même la signature.
Gagner en souveraineté réduit le nombre d'articles et la gravité du risque, mais ne ramène pas le travail contractuel à zéro.
Mon regard de praticien de terrain
Comme dans ma note du mois de juin sur les données de santé, je termine cette note avec un sentiment partagé.
Je suis un praticien de terrain : j'administre les serveurs, je gère les données de mes propres mains. En lisant tout cet édifice contractuel, je sais qu'il s'agit d'une convention humaine — ce que l'on nomme le constructivisme juridique, il me semble — souvent assez éloignée de la logique et de la pratique du terrain.
C'est un exercice d'analyse que j'aime beaucoup, mais qui m'est difficile. Il me crée une dissonance cognitive. D'un côté, je pense en praticien : je vois ce qu'on pourrait faire techniquement, concrètement, physiquement, pour renforcer la sécurité des données. De l'autre, ces protections juridiques sanctionnent devant un juge, mais ne protègent pas la donnée physiquement. C'est une protection par la sanction, pas une protection réelle. Ma culture hacker est de protéger pour de vrai, pas par le droit. Je crois que c'est là la source de ma dissonance, et parfois de mon énervement.
J'y trouve régulièrement de l'incohérence, parfois une forme d'hypocrisie, un peu comme un jeu de théâtre. Je ne dis pas que cela ne sert à rien — sans doute que ce cadre protège. Peut-être que mon regard de praticien me rend trop sensible à ce qui sépare la théorie juridique du terrain.
Certification HDS : ce que j'ai appris en creusant pour un ami
Un ami, professionnel libéral de santé, a vibe codé une application de gestion pour ses patients actuellement hébergée sur Supabase. Il souhaite migrer vers un Hébergeur de Données de Santé — il a notamment vu que Scaleway propose des services certifiés HDS — et m'a demandé si je connaissais un développeur pour l'accompagner dans ce projet.
J'ai croisé la notion de HDS pour la première fois en 2016, chez Tech-Angels. Depuis, j'ai suivi le sujet de loin sans jamais creuser.
Je profite de sa demande pour étudier le sujet en profondeur avant de lui répondre, et publier une note de ce que j'aurai appris.
Hébergeur de Données de Santé, c'est quoi ?
Toute personne physique ou morale qui héberge des données de santé à caractère personnel recueillies à l’occasion d’activités de prévention, de diagnostic, de soins ou de suivi médico-social pour le compte de personnes physiques ou morales à l'origine de la production ou du recueil de ces données ou pour le compte du patient lui-même, doit être agréée ou certifiée à cet effet.
Texte de loi : article L.1111-8 du Code de la santé publique
Qu'est-ce qu'une donnée de santé (DDS) ?
Avant d'aller plus loin, j'ai eu besoin de comprendre précisément ce qu'est une "donnée de santé".
La CNIL distingue trois catégories (source) :
- Les données de santé par nature : antécédents médicaux, diagnostics, traitements, résultats d'examens, ordonnances, comptes-rendus d'hospitalisation.
- Les données qui deviennent des données de santé par croisement : le poids ou le nombre de pas seuls ne le sont pas, mais croisés avec d'autres mesures (tension artérielle, apports caloriques), ils le deviennent.
- Les données qui deviennent des données de santé par leur usage : un rendez-vous chez un médecin, à lui seul, n'est pas une donnée de santé — mais le motif de la consultation, si.
Concrètement, dans l'application de mon ami, cela inclut probablement les noms des patients, leurs comptes-rendus, leurs ordonnances, les notes de suivi, et potentiellement les créneaux de rendez-vous liés à des actes de soins. Ce n'est pas seulement la « base médicale » au sens strict — c'est tout ce qui, relié à une personne identifiée, révèle qu'elle a reçu ou consulté pour des soins.
Un document médical sans identifiant, est-ce encore une donnée de santé ?
Une question qui m'est tout de suite venue à l'esprit : un document médical sans identifiant — pas de nom, pas de numéro de patient — est-ce encore une donnée de santé ?
La réponse dépend de la possibilité de ré-identification. Si le document est véritablement anonymisé, qu'il n'existe aucun moyen raisonnable de le relier à une personne, alors ce n'est plus une donnée de santé à caractère personnel — ça sort du périmètre du RGPD et du HDS.
Mais en pratique, c'est très difficile de le rendre vraiment anonyme. Un diagnostic rare, une date de traitement, ou un hôpital spécifique croisés avec d'autres sources, peuvent permettre de ré-identifier la personne.
La CNIL considère qu'une donnée est « personnelle » dès qu'il existe des « moyens raisonnablement susceptibles » de ré-identification.
Je pense qu'une bonne méthode pour estimer si c'est une DDS ou non, est de se mettre dans la peau d'un détective privé : si on me donnait ce document et tous les indices disponibles (date, hôpital, pathologie rare…), est-ce que je pourrais remonter à la personne ? Si la réponse est oui, c'est une donnée de santé. La question n'est donc pas « y a-t-il un nom dans le document ? » mais « quelqu'un, avec les moyens raisonnables, pourrait-il retrouver à qui ça appartient ? ».
Quels liens entre PII et DDS ?
Pour faire le lien avec les PII : toute Données de santé (DDS) est une PII, mais l'inverse n'est pas vrai. Un nom, une adresse email ou une adresse IP sont des PII parce qu'ils permettent d'identifier une personne.
Une donnée de santé est une PII qui révèle en plus quelque chose sur l'état de santé de cette personne. La distinction importe parce que le régime juridique n'est pas le même : les DDS sont soumises au RGPD comme les PII, mais avec des protections supplémentaires — secret médical, consentement explicite, obligation d'hébergement certifié HDS.
Qui est le "responsable de traitement" ?
Pour comprendre à qui s'applique la certification HDS, j'ai eu besoin de creuser la notion de "responsable de traitement" au sens du RGPD. Je croise ce terme régulièrement, je pense le comprendre dans les grandes lignes, mais j'ai voulu comprendre précisément où se situent les frontières.
D'après ce que j'ai compris, le responsable de traitement est la personne morale (ou la personne physique en entreprise individuelle) qui décide quoi faire avec les données personnelles. C'est elle qui détermine pourquoi on collecte les données et comment on les traite. Ce n'est pas l'individu (le médecin, l'infirmière) — c'est la structure juridique qui a la relation de soin avec le patient.
Concrètement :
| Situation | Responsable de traitement | Pourquoi ? |
|---|---|---|
| Médecin salarié à l'hôpital | L'hôpital (personne morale) | C'est l'hôpital qui a la relation avec le patient, pas le médecin individuellement |
| Médecin dans un cabinet en SARL | La SARL (personne morale) | C'est la SARL qui signe les contrats et est responsable en cas de fuite |
| Médecin libéral en entreprise individuelle | Le médecin (personne physique) | Il n'y a pas de structure intermédiaire |
| Cabinet médical | Le cabinet (personne morale) | Le cabinet détermine les règles de gestion du système d'information |
| Doctolib | Non — c'est un sous-traitant | Doctolib est un moyen de communication entre le médecin et le patient, comme un téléphone amélioré |
| Scaleway | Non — c'est un hébergeur | Scaleway fournit l'infrastructure, il ne traite pas les données pour ses propres fins |
| Un développeur freelance qui maintient le serveur | Non — c'est un sous-traitant | Il administre l'infrastructure pour le compte du responsable de traitement |
Cette distinction est cruciale pour comprendre la certification HDS. La loi dit que l'hébergement doit être certifié quand il est fait "pour le compte de" un responsable de traitement. Si tu es toi-même le responsable de traitement, tu n'héberges pas pour un tiers — tu héberges pour toi-même alors pas besoin de certification HDS (mais tu restes soumis au RGPD).
C'est pour ça qu'un médecin qui gère son propre dossier patient n'a pas besoin de HDS, mais qu'un hébergeur qui stocke les données pour le compte de ce médecin doit être certifié.
Un cas limite : les services médicaux numériques
Le cas des services médicaux numériques comme Poppins — "le dispositif médical numérique à domicile pour les enfants dyslexiques" — est compliqué. Qui est le responsable de traitement ?
La réponse dépend de qui décide quoi faire avec les données :
- Si Poppins décide quelles données collecter et comment les utiliser (recherche, amélioration du produit) alors Poppins est responsable de traitement
- Si l'orthophoniste décide quelles données utiliser pour le suivi du patient alors l'orthophoniste est responsable de traitement
- Si les deux ont un rôle de décision → co-responsabilité (article 26 RGPD)
Où est la documentation officielle HDS ?
La documentation officielle est trouvable sur le site https://esante.gouv.fr/ => "Produits et services" => "HDS" => "Les référentiels de la procédure de certification".
La documentation HDS est nommée "référentiel de certifications HDS", elle est disponible au format PDF à cette adresse https://esante.gouv.fr/sites/default/files/media_entity/documents/referentiel_certification_hds---fr--v2.pdf.
Je n'ai pas trouvé de version HTML de ce document.
D'après ce que j'ai compris, ce sont des personnes de l'Agence du Numérique en Santé (ANS) qui ont rédigé les 29 pages du référentiel de certifications HDS.
Ce référentiel a été officialisé dans le Journal Officiel le 16 mai 2024 https://www.legifrance.gouv.fr/jorf/id/JORFTEXT000049537692 par un ministre délégué à la santé. Ce document remplace la version précédente de 2018.
Et voici le communiqué de presse de l'ANS : Publication au Journal Officiel du référentiel de certification HDS : souveraineté des données et améliorations du référentiel.
Je suis ravi de lire la section Focus sur l’ajout d’exigences relatives à la souveraineté des données qui indique :
L’hébergement physique des données de santé doit être réalisé exclusivement sur le territoire d’un pays situé au sein de l’Espace Economique Européen.
🙂
Les 6 activités du référentiel HDS
Est considérée comme une activité d'hébergement de données de santé à caractère personnel sur support numérique ... des activités suivantes :
- La mise à disposition et le maintien en condition opérationnelle de sites physiques permettant d'héberger l'infrastructure matérielle du système d'information utilisé pour le traitement des données de santé ;
- La mise à disposition et le maintien en condition opérationnelle de l'infrastructure matérielle du système d'information utilisé pour le traitement de données de santé ;
- La mise à disposition et le maintien en condition opérationnelle de l'infrastructure virtuelle du système d'information utilisé pour le traitement des données de santé ;
- La mise à disposition et le maintien en condition opérationnelle de la plateforme d'hébergement d'applications du système d'information ;
- L'administration et l'exploitation du système d'information contenant les données de santé ;
- La sauvegarde des données de santé
Cette liste, reformulée en activités concrètes :
| # | Activité |
|---|---|
| 1 | Gestion des sites physiques : datacenters, baies serveurs, climatisation, alimentation électrique, sécurité des locaux |
| 2 | Gestion de l'infrastructure matérielle : serveurs physiques, stockage, câblage réseau, commutation |
| 3 | Gestion de l'infrastructure virtuelle : machines virtuelles, réseaux virtuels, stockage virtuel, hyperviseurs |
| 4 | Gestion de la plateforme applicative : bases de données managées, conteneurs, serveurs d'application |
| 5 | Gestion des sauvegardes : sauvegardes automatisées, stockage hors site, restauration |
| 6 | Administration et exploitation du SI : supervision, mises à jour, gestion des accès, support technique, astreinte |
Il y a un point important que j'ai mis du temps à saisir : l'obligation de certification ne s'applique qu'à l'hébergement de données de santé pour un tiers qui est responsable de traitement.
Par conséquent, un professionnel de santé qui auto-héberge ses propres données n'a pas besoin de certification HDS pour les activités de cette liste qu'il administre lui-même.
Un exemple concret
Imaginons un cabinet de médecin, qui développe une application web qui contient des données de santé. Cette application est à destination de ses utilisateurs finaux, ses patients.
L'application web est codée en JavaScript avec PostgreSQL pour la persistance des données.
Pour le déploiement, le développeur employé directement par le cabinet de médecin fait le choix de déployer le tout sur une Virtual machine Scaleway.
D'après la version du 18 juin 2026 de la page "L’hébergement des données de santé et la certification HDS" de la documentation Scaleway, voici la liste des services certifiés HDS :
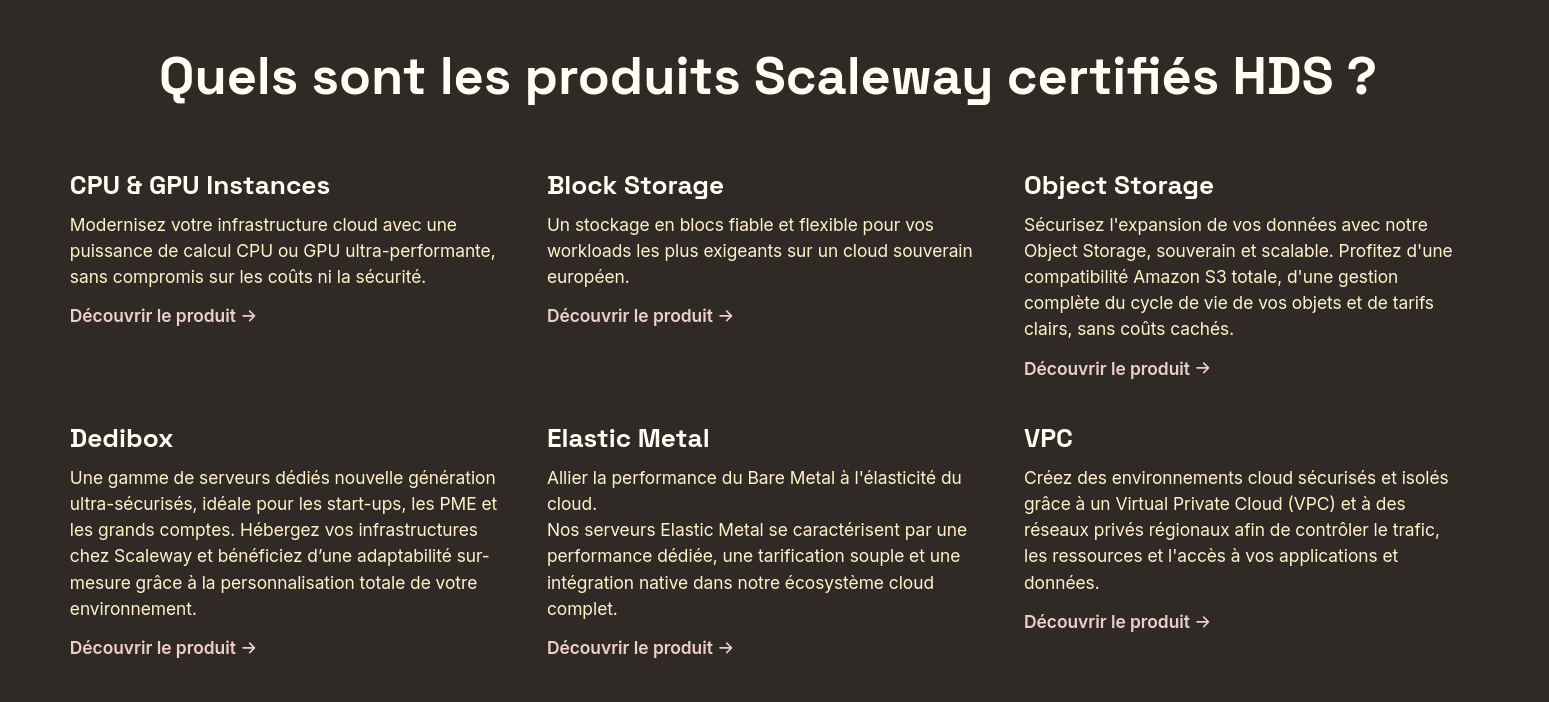
Les composants de fondations les plus importants sont bien certifiés. Je note au passage que l'offre "Managed Database for PostgreSQL and MySQL" n'est pas certifiée pour le moment.
Ceci n'est pas grave dans mon exemple si je déploie directement une image Docker de PostgreSQL directement sur la Virtual machine. Les sauvegardes peuvent être déposées dans Scaleway Object Storage qui lui est certifié.
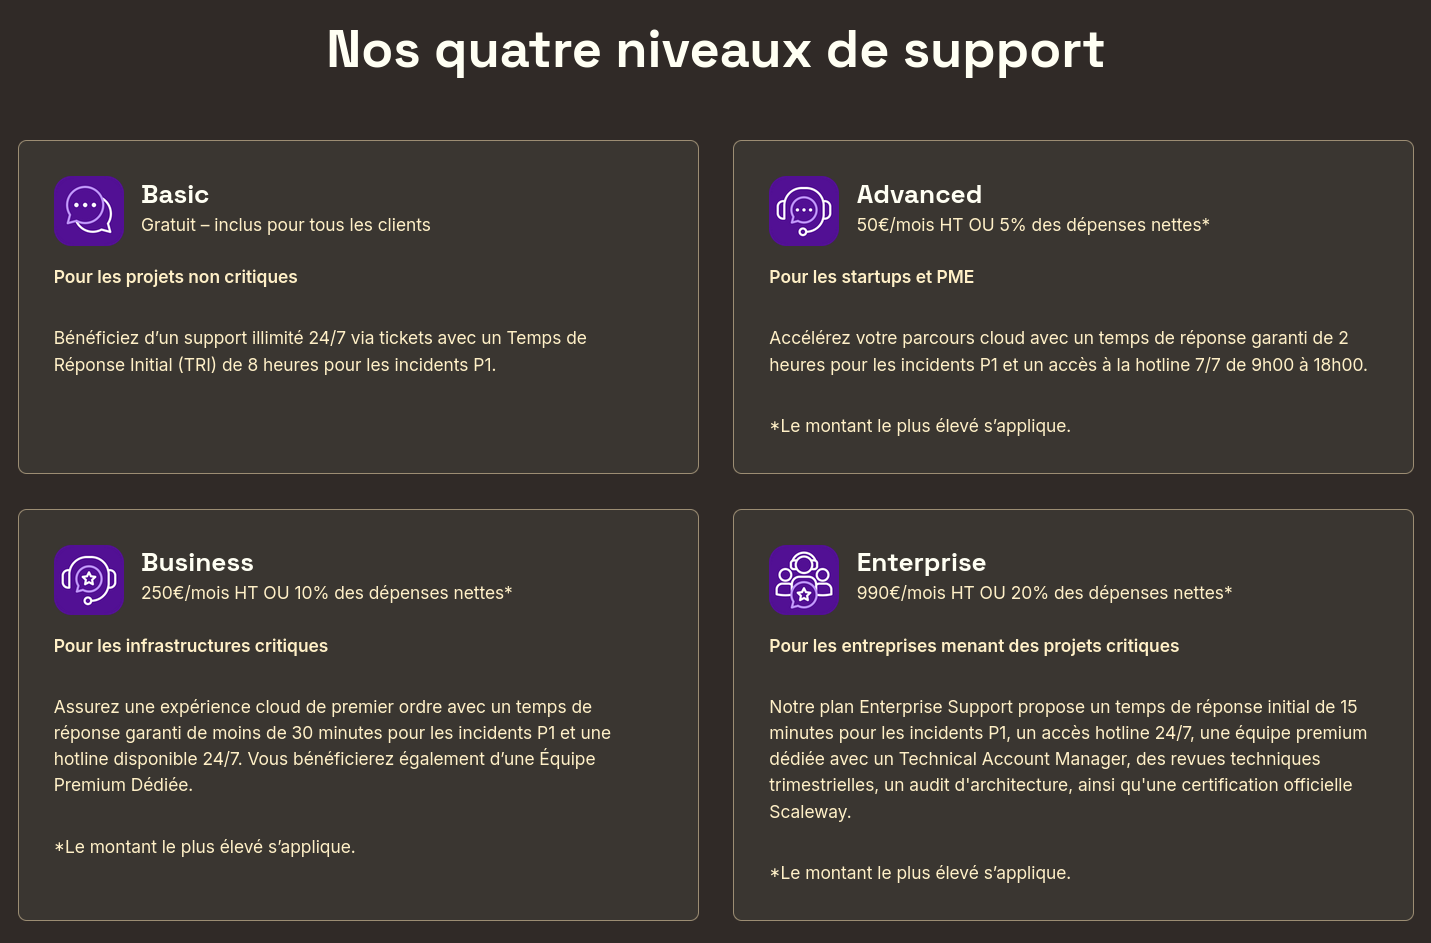
Le cabinet de médecin devra souscrire un plan de support niveau Business à 250 € par mois pour pouvoir ensuite signer un contrat HDS :
Ensuite, Scaleway remettra au cabinet de médecin (son client) un document de garantie HDS, conformément au chapitre 8 du référentiel :
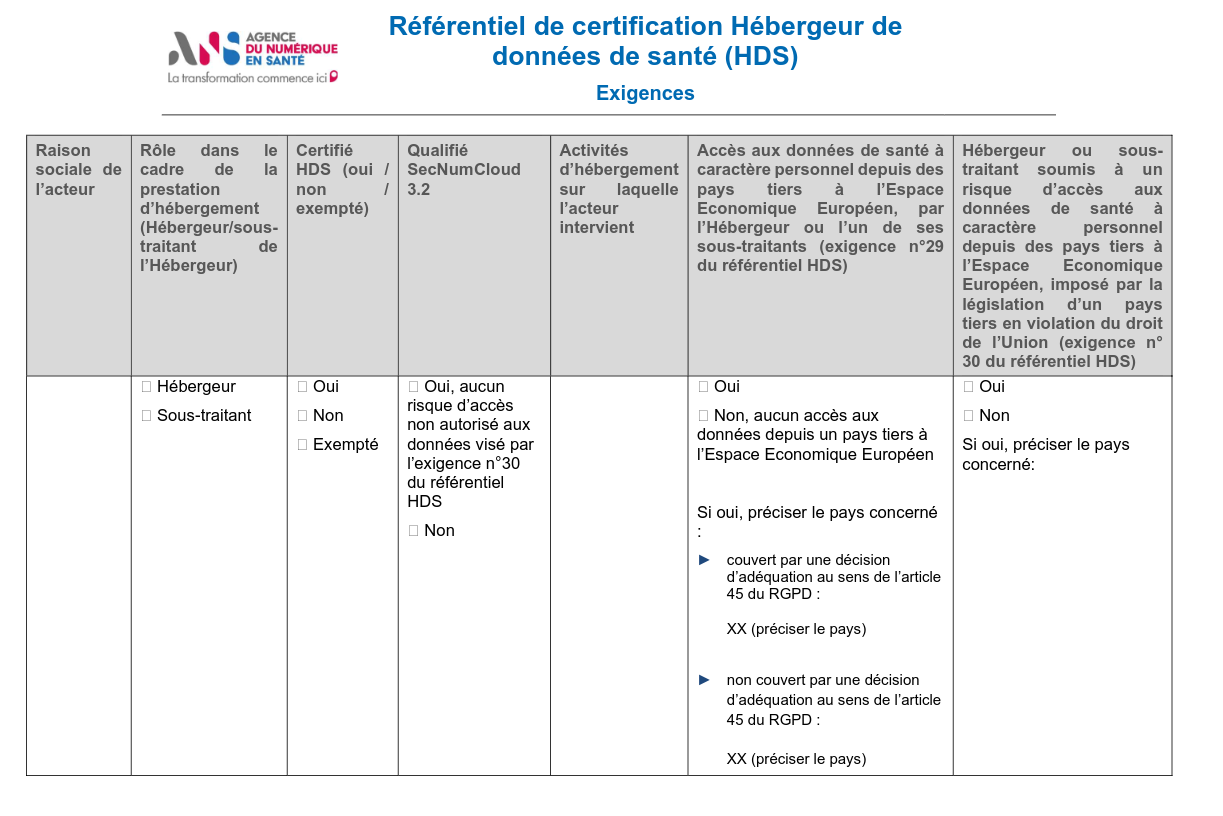
Voici à quoi pourrait ressembler ce document : "Exemple fictif d'une garantie de certification HDS de Scaleway".
Ensuite, les DevOps salariés directement du cabinet de santé déploient, maintiennent, administrent l'application sur les Virtual machine de Scaleway sans que le cabinet de médecin n'ait besoin de certification HDS car il n'est pas un hébergeur de données parce qu'il ne vend pas son service à d'autres professionnels. Seuls les patients directs utilisent son service.
Employé vs freelance : une distinction absurde mais légale
Il y a un point que j'ai mis du temps à saisir, et qui me paraît absurde mais qui est juridiquement cohérent.
Un employé (CDD ou CDI) du cabinet de santé qui gère le serveur, fait les mises à jour et les sauvegardes n'a pas besoin de certification HDS. Il fait partie de l'organisation du responsable de traitement — il n'est pas un sous-traitant.
Le même développeur, faisant exactement le même travail (SSH, mises à jour, sauvegardes), mais en freelance vendant 5 heures de prestation, a besoin de la certification HDS pour l'activité 5 (administration et exploitation). Pourquoi ? Parce qu'il est une entité séparée, un sous-traitant au sens RGPD, qui assure une activité d'hébergement pour le compte d'un tiers responsable de traitement.
La distinction ne se fait pas sur la nature du travail, mais sur le statut juridique de la personne qui le fait :
- Employé du cabinet (CDD/CDI) avec accès SSH → pas de HDS, il fait partie du responsable de traitement
- Freelance avec accès SSH permanent → HDS requis, il est sous-traitant et assure l'activité 5
Le cas du freelance qui livrerait uniquement du code
Si le freelance se contente de fournir du code — application, scripts d'infrastructure, configs de déploiement — et qu'il push tout dans un repo Git sans jamais avoir accès au serveur, à la base de données ni aux données, alors il n'assure aucune des 6 activités d'hébergement. Il livre un produit (du code), il n'opère pas un service.
Le test légal reste le même : "le fait d'assurer pour le compte du responsable de traitement tout ou partie des activités suivantes." Le verbe clé est "assurer" — c'est-à-dire exécuter, opérer, maintenir en condition opérationnelle. Les 6 activités décrivent des opérations sur l'infrastructure et le système, pas de la production de code.
La frontière se joue sur un point précis : qui appuie sur le bouton "déployer" ?
- Si c'est un employé du cabinet de santé qui contrôle l'outil de déploiement (par exemple ArgoCD) et déclenche les déploiements → freelance = livreur de code → pas de HDS
- Si le freelance a accès à cet outil et déclenche lui-même les déploiements → il participe à l'exploitation (activité 5) → HDS requis
Combien coûte une certification HDS pour les activités 4, 5 et 6 ?
J'ai cherché le processus officiel pour obtenir la certification HDS, voici ce que j'ai retenu :
- Mettre en place un Système de Management de la Sécurité de l'Information (SMSI) conforme à ISO 27001 (politique de sécurité, analyse de risques, gestion des accès, plan de continuité) — prérequis obligatoire.
- Choisir un organisme certificateur accrédité Comité français d'accréditation (Cofrac) (BSI, AFNOR, Bureau Veritas, LRQA…).
- Audit sur site en deux volets : conformité ISO 27001, puis exigences HDS spécifiques.
- Correction des non-conformités relevées.
- Obtention du certificat (valable 3 ans, avec audit de surveillance annuel).
J'ai volontairement laissé de côté le contenu concret du SMSI et de la norme ISO 27001 — je les connais mal. Cette note m'a donné envie d'explorer le sujet en profondeur, mais je le ferai dans une note séparée pour ne pas allonger encore celle-ci.
Les coûts typiques pour une TPE (< 10 personnes) :
| Poste | Estimation |
|---|---|
| Mise en place SMSI (conseil externe) | 2 000 – 6 000 € |
| Audit initial COFRAC (ISO 27001 + HDS) | 8 000 – 15 000 € |
| Audits de surveillance annuels (×2) | 2 000 – 5 000 € |
| Sous-total coûts externes | 12 000 – 26 000 € |
| Coût interne du salarié (100 – 200 h à 500 €/j soit ~70 €/h super brut) | 7 000 – 14 000 € |
| Total sur 3 ans | 19 000 – 40 000 € |
Estimation en temps humain (pour une personne seule, en charge de tout) :
| Étape | Effort humain estimé | Durée calendrier estimée |
|---|---|---|
| Mise en place SMSI (rédaction, procédures, analyse de risques, choix des outils) | 40 – 100 heures | 2 – 4 mois |
| Choix du certificateur et préparation du dossier | 15 – 30 heures | 3 – 6 semaines |
| Audit initial (sur site + préparation) | 15 – 30 heures | 1 – 2 semaines |
| Correction des non-conformités | 20 – 60 heures | 2 – 6 semaines |
| Obtention du certificat + 1er audit de surveillance | 10 – 30 heures | 1 – 2 mois |
| Total (avec SMSI ou maturité existante) | 100 – 250 heures | 6 – 9 mois |
| Total (sans SMSI préalable) | 200 – 400 heures | 12 – 18 mois |
Sources
Les fourchettes de coûts et de durées ci-dessus sont des estimations de Fermi calculées par MiMO-V2-Pro, recalibrées pour coller aux données publiées :
- Legiscope — Certification HDS hébergeur de données de santé 2026 (Dr. Thiébaut Devergranne, 23 mai 2026) : fourchette de 20 000 à 35 000 € sur 3 ans pour une TPE. Durée de 6 à 9 mois si l'organisation dispose déjà d'un SMSI ou d'une maturité ISO 27001 ; 12 à 18 mois sans SMSI préalable (dont 9-12 mois pour la certification ISO 27001 seule).
- Galeon — Certification HDS en 2026 (21 avril 2026) : « Les audits représentent généralement plusieurs dizaines de milliers d'euros, auxquels s'ajoutent les coûts internes de préparation et de mise en conformité. »
Je pense que des outils de service d'automatisation de conformité du type Oneleet que j'ai testés, peuvent accélérer le processus de mise en place d'un SMSI pour obtenir une certification ISO 27001.
Le risque sécurité du code vibe codé
Ça me fait un peu peur, honnêtement. Mon ami a vibe codé une application qui contient des données de santé. Et payer les frais importants d'une agence de développeur certifiée HDS n'aurait aucun sens dans ce contexte d'une application amateur sur mesure.
Qu'est-ce que je vais répondre à mon ami ?
D'abord, son idée d'hébergement chez Scaleway va coûter cher ! Déjà 250 € par mois rien que pour le plan de support Business.
Pour éviter cela, une solution serait d'auto-héberger l'application chez soi, dans son bureau, sur un petit serveur. Tant qu'on n'héberge pas pour un tiers, il n'y a pas besoin de certification HDS.
Mais il ne pourra pas demander à un développeur freelance d'administrer ce serveur. Dès qu'un freelance intervient sur l'infrastructure (accès SSH, mises à jour, sauvegardes), il assure l'activité 5 du référentiel HDS — et il devrait être certifié ! Et le coût de la certification pour administrer ce serveur, pour une seule instance, sera bien trop élevé.
Autre solution : embaucher un développeur en CDD pour toute intervention. C'est légalement possible sans HDS, mais c'est lourd à gérer et coûteux.
Réflexion sur le Vibe coding : libération ou prolétarisation ?
En tant qu'artisan développeur, je trouve amusant d'observer plusieurs de mes amis vibe coder des applications sur mesure pour leur besoin.
Pour le moment je n'ai pas cherché à savoir s'ils essaient de comprendre le code produit, ou si le code reste une boîte noire dont ils se fichent tant que ça marche. Mais c'est un phénomène socialement intéressant, et je ne sais pas si c'est une bonne nouvelle ou non.
Si le vibe coding reste un outil d'appropriation, si la personne comprend ce qu'elle fait, peut modifier, adapter, expliquer — alors c'est un acte de déprolétarisation : il reprend le contrôle sur ses outils de travail.
Mais si le code reste opaque, s'il ne s'agit que de produire sans comprendre, alors le vibe coding n'est qu'une nouvelle forme de prolétarisation. Le savoir ne passe plus par la machine au sens de Bernard Stiegler — il passe par l'IA, et la personne reste aussi démunie que devant si l'outil disparaît ou change, c'est de la désindividuation au sens de Bernard Stiegler. La personne n'a pas acquis de savoir, elle a acquis un résultat, elle "consomme".
C'est ce qui fait de ces outils des pharmakons : ils peuvent désindividuer autant qu'ils peuvent aider à s'individuer, selon l'usage qu'on en fait.
J'ai développé cette réflexion dans "J'utilise les LLMs comme des amis experts et jamais comme des écrivains fantômes" et dans "Ma lutte contre mon affaiblissement cognitif". En résumé, j'essaie personnellement d'éviter cette prolétarisation : plutôt que de consommer l'IA pour produire des choses, j'essaie de groker — comprendre en profondeur, pas seulement obtenir un résultat.
Anthropic sous-vend-il ses abonnements ou surtaxe-t-il son API ?
Comme je l'ai mentionné dans cette note, les abonnements Claude sont beaucoup plus économiques que l'offre par API :
- L'offre Pro à $20 est 8 fois moins chère que l'offre API (pay as you go) : $163
- L'offre Max 5x à $100 est 13,5 fois moins chère que l'offre API (pay as you go) : $1354
- L'offre Max 20x à $200 est 13,5 fois moins chère que l'offre API (pay as you go) : $2708
Un ami me demande à ce sujet :
Est-ce qu'ils sous-vendent leur abonnement (Claude Pro, Max…) ou est-ce qu'ils arnaquent en pay as you go (via l'API) ?
Je n'ai fait aucune recherche à ce sujet, mais voici les explications qui me viennent à l'esprit.
Toute organisation opérant un service numérique gourmand en ressources — qu'il s'agisse de puissance de calcul ou de stockage — doit trouver un équilibre pour rentabiliser une infrastructure coûteuse sur un usage moyen, tout en absorbant des pics de charge qu'il serait trop onéreux de provisionner en permanence, même lorsqu'ils sont prévisibles.
Par exemple, Twitter dans ses premières années (2007-2012) était célèbre pour sa page "Fail Whale" — une baleine affichée aux utilisateurs en lieu et place du service quand les serveurs saturaient. Les événements mondiaux en temps réel (élections, Coupe du monde) suffisaient à faire tomber la plateforme. Je n'ai aucune information interne de Twitter de cette époque, mais clairement, Twitter n'avait pas trouvé de bonne stratégie pour garantir une qualité de service qui puisse suivre sa croissance.
Une stratégie classique sur Internet pour maîtriser cette croissance est l'ouverture par invitation, comme Gmail en 2004 et Dropbox en 2008. Elle permet à l'organisation de contrôler le rythme d'adoption en distribuant des invitations au fur et à mesure qu'elle déploie de nouveaux serveurs.
L'inférence des services d'agent conversationnel est surtout consommatrice de computation — les GPU — et tous les utilisateurs souhaitent utiliser à fond leur limite de tokens, surtout avec les AI code assistant. Anthropic souhaite lisser l'usage de leurs GPU dans le temps, dans le mois. C'est pour cela qu'elle définit des quotas sur 5h et par semaine. Ces quotas leur permettent de lisser et de contrôler davantage l'usage de leur infrastructure.
Estimation de Fermi du coût d'un abonnement Claude Max 5x
Je me suis lancé dans une estimation de Fermi pour estimer le coût brut d'un abonnement Claude Max 5x.
Mon estimation s'appuie sur le modèle Qwen3-235B-A22B comme point de comparaison, faute de données publiques sur l'architecture interne de Claude Sonnet. Précision méthodologique importante : les benchmarks officiels de Qwen (SGLang) mesurent (tokens_input + tokens_output) / temps — c'est donc un throughput mixte, pas uniquement de la génération.
En croisant ces benchmarks avec les résultats de GPUStack sur H100, et avec l'aide de Sonnet 4.6, j'estime qu'un serveur Scaleway "H100-SXM-8-80G — 128 vCPUs — 8 GPUs — 960 GB" loué à 16 810 € / mois peut traiter environ 20 à 40 milliards de tokens d'entrée par mois selon la longueur moyenne des prompts, soit approximativement 30 000 millions de tokens.
Si j'estime qu'un abonnement Claude Max 5x permet de traiter environ 400 millions de tokens d'entrée par mois pour Sonnet, un seul serveur H100-SXM-8-80G peut alors servir :
30 000 M tokens / 400 M tokens = 75 utilisateurs
Si je pars du principe que Scaleway marge à 20% le prix du serveur, cela donne un coût infrastructure par utilisateur de :
16 810 € × 0,8 / 75 = ~179 € par utilisateur par mois
Ce qui fait presque le double du prix d'un abonnement Max 5x.
Je suppose que la majorité des abonnés n'utilisent pas leur quota à fond, et qu'Anthropic optimise son infrastructure bien au-delà de ce qu'on peut estimer depuis des benchmarks publics. Partant de là, j'ai l'impression que le prix des abonnements couvre à peu près le coût de leur infrastructure.
L'offre API oblige Anthropic à provisionner des serveurs supplémentaires pour absorber les pics de charge et garantir une bonne qualité de service, et je pense que c'est pour cela que le prix au token est plus élevé via l'API.
Ceci n'est bien sûr que mon estimation personnelle. Si l'un d'entre vous dispose d'une meilleure approche ou de données plus fiables, n'hésitez pas à me la partager : contact@stephane-klein.info.
Setup Fedora CoreOS avec LUKS et Tang
Il y a quelques jours, dans ma note "Setup Fedora CoreOS avec LUKS et TPM", je disais :
Une solution pour traiter ce point faible est d'utiliser un pin éloigné physiquement du serveur qui l'utilise.
Le framework Clevis utilise le terme "pins" pour désigner les différents méthodes de déverrouillage d'un volume LUKS.
Origine du mot "pin" ?
Claude Sonnet 4.5 m'a expliqué que le terme "pin", qui se traduit par "goupille" en français, désigne la pièce mécanique qui bloque l'ouverture d'un cadenat.
Par exemple, dans un contexte self hosting dans un homelab, je peux héberger physiquement un serveur dans mon logement et le connecter à un pin sur un serveur Scaleway ou sur un serveur dans le homelab d'un ami.
Les pins distants, accessibles via réseau, sont appelés serveurs Network-Bound Disk Encryption.
Si le serveur Network-Bound Disk Encryption est configuré pour répondre uniquement aux requêtes provenant de l'IP de mon réseau homelab, en cas de vol du serveur, le voleur ne pourra pas récupérer le secret permettant de déchiffrer le volume LUKS.
Dans le playground install-coreos-iso-on-qemu-with-luks-and-tang, j'ai testé avec succès le déverrouillage d'un volume LUKS avec un serveur Network-Bound Disk Encryption nommé tang.
Pour être précis, dans la configuration de ce playground, deux pins sont obligatoires pour déverrouiller automatiquement le volume : un pin tang et un pin TPM2. Le nombre minimum de pins requis pour le déverrouillage est défini par le paramètre threshold.
clevis, qui permet de configurer les pins et de gérer la récupération de la passphrase à partir des pins, utilise l'algorithme Shamir's secret sharing (SSS) pour répartir le secret à plusieurs endroits.
Voici quelques scénarios de conditions de déverrouillage que clevis permet de configurer grâce à SSS :
- TPM2 ou Tang serveur 1
- TPM2 et Tang serveur 1
- Tang serveur 1 ou Tang serveur 2
- 2 parmi Tang serveur 1, Tang serveur 2, Tang serveur 3
- ...
Si les conditions ne sont pas remplies, systemd-ask-password demande à l'utilisateur de saisir sa passphrase au clavier.
Je n'ai pas trouvé d'image docker officielle de tang. Toutefois, j'ai trouvé ici l'image non officielle padhihomelab/tang (son dépôt GitHub : https://github.com/padhi-homelab/docker_tang).
Dans mon playground, je l'ai déployé dans ce docker-compose.yml.
J'ai trouvé la configuration butane de tang simple à définir (lien vers le fichier) :
  luks:
    - name: var
      device: /dev/disk/by-partlabel/var
      wipe_volume: true
      key_file:
        inline: password
      clevis:
        tpm2: true
        tang:
          - url: "http://10.0.2.2:1234"
            # $ docker compose exec tang jose jwk thp -i /db/pLWwUuLhqqFb-Mgf5iVkwuV4BehG9vzd2SXGMyGroNw.jwk
            # pLWwUuLhqqFb-Mgf5iVkwuV4BehG9vzd2SXGMyGroNw
            thumbprint: dx9dNzgs-DeXg0SCBQW5rb7WQkSIN1B8MIgcO6WxJfI
        threshold: 2 # TMP2 + Tang (or passphrase keyboard input)
La seule complexité que j'ai rencontrée est la méthode pour récupérer le paramètre thumbprint de l'instance tang.
Voici la méthode que j'ai utilisée :
$ docker compose exec tang jose jwk thp -i /db/pLWwUuLhqqFb-Mgf5iVkwuV4BehG9vzd2SXGMyGroNw.jwk
pLWwUuLhqqFb-Mgf5iVkwuV4BehG9vzd2SXGMyGroNw
Autre difficulté, il faut ajouter les arguments kernel suivants pour activer l'accès réseau dès le début du process de boot afin de permettre à clevis d'accéder au serveur tang :
variant: fcos
version: 1.6.0
kernel_arguments:
  should_exist:
    - ip=dhcp
    - rd.neednet=1
J'ai intégré au README.md du playground une section nommée "How to switch from 2 required ping to 1 or the opposite?", pour documenter comment modifier à chaud la configuration clevis.
Par exemple pour changer de serveur tang ou modifier le nombre de pins nécessaires pour déverrouiller la partition chiffrée.
Il est conseillé d'activer le pin TPM2 en complément de tang pour éviter ce type d'attaque décrit par Claude Sonnet 4.5 :
Imaginons un admin malveillant dans ton entreprise :
- Il a accès physique aux serveurs
- Il a accès au réseau (donc au serveur Tang)
- Il clone un disque pendant la nuit
- Il essaie de le monter sur sa propre machine pour extraire des données
Tang seul : ❌ Il réussit
TPM + Tang : ✅ Il échoue
À noter que l'instance tang ne contient pas la passphrase et ne voit jamais passer la passphrase via son API.
Voici les explications que m'a données Claude Sonnet 4.5 :
Tang ne stocke pas la passphrase secrète de chiffrement LUKS. C'est justement tout l'intérêt de cette solution !
Voici comment ça fonctionne :
Le principe de Tang + Clevis
- Génération de clé dérivée : Clevis (le client) contacte le serveur Tang et récupère sa clé publique
- Chiffrement avec la clé de Tang : Clevis utilise cette clé publique pour chiffrer la passphrase LUKS
- Stockage local : La passphrase chiffrée est stockée localement dans l'en-tête LUKS du disque (pas sur le serveur Tang)
- Déchiffrement au boot :
- La machine contacte Tang
- Tang utilise sa clé privée pour aider à déchiffrer
- La passphrase LUKS est reconstituée
- Le disque est déverrouillé
Ce que Tang sait et ne sait pas
- ❌ Tang ne connaît jamais votre passphrase LUKS
- ❌ Tang ne stocke rien concernant vos clés
- ✅ Tang fournit juste un service cryptographique (un oracle de déchiffrement)
- ✅ C'est un serveur sans état (stateless)
C'est du chiffrement asymétrique avec un mécanisme appelé "network-bound disk encryption" : le disque ne peut être déchiffré que si la machine peut contacter le serveur Tang sur le réseau.
Voici quelques ressources supplémentaires au sujet des techniques de déverrouillage automatique des volumes LUKS :
J'ai découvert ContainerLab, un projet qui permet de simuler des réseaux
Pendant mon travail d'étude pratique de IPv6, #JaiDécouvert le projet Containerlab :
Containerlab was meant to be a tool for provisioning networking labs built with containers. It is free, open and ubiquitous. No software apart from Docker is required! As with any lab environment it allows the users to validate features, topologies, perform interop testing, datapath testing, etc. It is also a perfect companion for your next demo. Deploy the lab fast, with all its configuration stored as a code -> destroy when done.
Projet qui a commencé en 2020 et semble principalement développé par un développeur de chez Nokia.
D'après ce que j'ai compris, Containerlab me permet de facilement créer des réseaux dans un simulateur.
Je me souviens que je cherchais ce type d'outil en 2018, quand je travaillais sur un projet baremetal as service chez Scaleway.
Voici un exemple de fichier créé par Claude.ai pour simuler un environnement composé de deux réseaux IPv6 connectés entre eux : 3 serveurs sur le premier réseau et 2 serveurs sur le second.
Je précise que je n'ai pas encore testé ce fichier. J'ignore donc s'il fonctionne correctement.
name: dual-network-ipv6-lab
topology:
  nodes:
    # Routeur avec IPv6
    router:
      kind: linux
      image: alpine:latest
      exec:
        # Activer IPv6
        - sysctl -w net.ipv6.conf.all.disable_ipv6=0
        - sysctl -w net.ipv6.conf.all.forwarding=1
        # Adresses IPv6 sur les interfaces
        - ip -6 addr add 2001:db8:1::1/64 dev eth1
        - ip -6 addr add 2001:db8:2::1/64 dev eth2
        # IPv4 en parallèle (dual-stack)
        - ip addr add 192.168.1.1/24 dev eth1
        - ip addr add 192.168.2.1/24 dev eth2
        - echo 1 > /proc/sys/net/ipv4/ip_forward

    # Réseau A (2001:db8:1::/64)
    vm-a1:
      kind: linux
      image: alpine:latest
      exec:
        - sysctl -w net.ipv6.conf.all.disable_ipv6=0
        - ip -6 addr add 2001:db8:1::10/64 dev eth1
        - ip -6 route add default via 2001:db8:1::1
        - ip addr add 192.168.1.10/24 dev eth1
        - ip route add default via 192.168.1.1

    vm-a2:
      kind: linux
      image: alpine:latest
      exec:
        - sysctl -w net.ipv6.conf.all.disable_ipv6=0
        - ip -6 addr add 2001:db8:1::11/64 dev eth1
        - ip -6 route add default via 2001:db8:1::1
        - ip addr add 192.168.1.11/24 dev eth1
        - ip route add default via 192.168.1.1

    vm-a3:
      kind: linux
      image: alpine:latest
      exec:
        - sysctl -w net.ipv6.conf.all.disable_ipv6=0
        - ip -6 addr add 2001:db8:1::12/64 dev eth1
        - ip -6 route add default via 2001:db8:1::1
        - ip addr add 192.168.1.12/24 dev eth1
        - ip route add default via 192.168.1.1

    # Réseau B (2001:db8:2::/64)
    vm-b1:
      kind: linux
      image: alpine:latest
      exec:
        - sysctl -w net.ipv6.conf.all.disable_ipv6=0
        - ip -6 addr add 2001:db8:2::10/64 dev eth1
        - ip -6 route add default via 2001:db8:2::1
        - ip addr add 192.168.2.10/24 dev eth1
        - ip route add default via 192.168.2.1

    vm-b2:
      kind: linux
      image: alpine:latest
      exec:
        - sysctl -w net.ipv6.conf.all.disable_ipv6=0
        - ip -6 addr add 2001:db8:2::11/64 dev eth1
        - ip -6 route add default via 2001:db8:2::1
        - ip addr add 192.168.2.11/24 dev eth1
        - ip route add default via 192.168.2.1

  links:
    # Réseau A
    - endpoints: ["router:eth1", "vm-a1:eth1"]
    - endpoints: ["router:eth1", "vm-a2:eth1"]
    - endpoints: ["router:eth1", "vm-a3:eth1"]

    # Réseau B
    - endpoints: ["router:eth2", "vm-b1:eth1"]
    - endpoints: ["router:eth2", "vm-b2:eth1"]
Faut-il encore configurer du swap en 2025, même sur des serveurs avec beaucoup de RAM ?
Aujourd'hui, j'ai implémenté des tests de montée en charge à l'aide de Grafana k6. En ciblant un site web hébergé sur un petit serveur Scaleway DEV1-M, j'ai constaté que le serveur est devenu inaccessible à la fin des tests. Aucun swap n'était configuré sur cette Virtual machine de 4Go de RAM.
Je me suis souvenu qu'en 2019, j'ai rencontré aussi des problèmes de freeze sur une VM AWS EC2 que j'ai corrigés en ajoutant un peu de swap au serveur. Après cela, je n'ai constaté plus aucun freeze de VM pendant 4 ans.
Ce sujet de swap m'a fait penser à la question qu'un ami m'a posée en octobre 2024 :
Désactiver le swap sur une Debian, recommandé ou pas ?
Alors que j'ai 29Go utilisé sur 64, le swap était plein (3,5Go occupé à 100%), les 12 cœurs du serveur partaient dans les tours. J'ai désactivé le swap et me voilà gentiment avec un load average raisonnable, pour les tâches de cette machine.
C'est une très bonne question que je me pose depuis longtemps. J'ai enfin pris un peu de temps pour creuser ce sujet.
Sept mois plus tard, voici ma réponse dans cette note 😉.
#JaiDécouvert le paramètre kernel nommé Swappiness.
swappiness
This control is used to define how aggressive the kernel will swap memory pages. Higher values will increase aggressiveness, lower values decrease the amount of swap. A value of 0 instructs the kernel not to initiate swap until the amount of free and file-backed pages is less than the high water mark in a zone.
The default value is 60.
Dans la documentation SwapFaq d'Ubuntu j'ai lu :
The swappiness parameter controls the tendency of the kernel to move processes out of physical memory and onto the swap disk. Because disks are much slower than RAM, this can lead to slower response times for system and applications if processes are too aggressively moved out of memory.
- swappiness can have a value of between
0and100swappiness=0tells the kernel to avoid swapping processes out of physical memory for as long as possibleswappiness=100tells the kernel to aggressively swap processes out of physical memory and move them to swap cacheThe default setting in Ubuntu is
swappiness=60. Reducing the default value of swappiness will probably improve overall performance for a typical Ubuntu desktop installation. A value ofswappiness=10is recommended, but feel free to experiment. Note: Ubuntu server installations have different performance requirements to desktop systems, and the default value of60is likely more suitable.
D'après ce que j'ai compris, plus swappiness tend vers zéro, moins le swap est utilisé.
J'ai lu ici :
vm.swappiness = 60: Valeur par défaut de Linux : à partir de 40% d’occupation de Ram, le noyau écrit sur le disque.
Cependant, je n'ai pas trouvé d'autres sources qui confirment cette correspondance entre la valeur de swappiness et un pourcentage précis d'utilisation de la RAM.
J'ai ensuite cherché à savoir si c'était encore pertinent de configurer du swap en 2025, sur des serveurs qui disposent de beaucoup de RAM.
#JaiLu ce thread : "Do I need swap space if I have more than enough amount of RAM?", et voici un extrait qui peut servir de conclusion :
In other words, by disabling swap you gain nothing, but you limit the operation system's number of useful options in dealing with a memory request. Which might not be, but very possibly may be a disadvantage (and will never be an advantage).
Je pense que ceci est d'autant plus vrai si le paramètre swappiness est bien configuré.
Concernant la taille du swap recommandée par rapport à la RAM du serveur, la documentation de Ubuntu conseille les ratios suivants :
       RAM      Swap    Maximum Swap
      256MB    256MB           512MB
      512MB    512MB          1024MB
     1024MB   1024MB          2048MB
        1GB      1GB             2GB
        2GB      1GB             4GB
        3GB      2GB             6GB
        4GB      2GB             8GB
        5GB      2GB            10GB
        6GB      2GB            12GB
        8GB      3GB            16GB
       12GB      3GB            24GB
       16GB      4GB            32GB
       24GB      5GB            48GB
       32GB      6GB            64GB
       64GB      8GB           128GB
      128GB     11GB           256GB
      256GB     16GB           512GB
      512GB     23GB             1TB
        1TB     32GB             2TB
        2TB     46GB             4TB
        4TB     64GB             8TB
        8TB     91GB            16TB
#JaiDécouvert aussi que depuis le kernel 2.6, les fichiers de swap sont aussi rapides que les partitions de swap :
Definitely not. With the 2.6 kernel, "a swap file is just as fast as a swap partition."
Suite à ces apprentissages, j'ai configuré et activé un swap de 2G sur la VM Scaleway DEV1-L équipée de 4G de RAM, avec le paramètre swappiness réglé à 10.
J'ai relancé mon test Grafana k6 et je n'ai constaté plus aucun freeze, je n'ai pas perdu l'accès au serveur.
De plus, probablement grâce au paramètre swappiness fixé à 10, j'ai observé que le swap n'a pas été utilisé pendant le test.
Suite à ces lectures et à cette expérience concluante, j'ai décidé de désormais configurer systématiquement du swap sur tous mes serveurs de la manière suivante :
if swapon --show | grep -q "^/swapfile"; then
    echo "Swap is already configured"
else
    get_swap_size() {
        local ram_gb=$(free -g | awk '/^Mem:/ {print $2}')

        # Why this values? See https://help.ubuntu.com/community/SwapFaq#How_much_swap_do_I_need.3F
        if [ $ram_gb -le 1 ]; then
            echo "1G"
        elif [ $ram_gb -le 2 ]; then
            echo "1G"
        elif [ $ram_gb -le 6 ]; then
            echo "2G"
        elif [ $ram_gb -le 12 ]; then
            echo "3G"
        elif [ $ram_gb -le 16 ]; then
            echo "4G"
        elif [ $ram_gb -le 24 ]; then
            echo "5G"
        elif [ $ram_gb -le 32 ]; then
            echo "6G"
        elif [ $ram_gb -le 64 ]; then
            echo "8G"
        elif [ $ram_gb -le 128 ]; then
            echo "11G"
        else
            echo "11G"
        fi
    }

    SWAP_SIZE=$(get_swap_size)
    fallocate -l $SWAP_SIZE /swapfile
    chmod 600 /swapfile
    mkswap /swapfile
    swapon /swapfile

    if ! grep -q "^/swapfile.*swap" /etc/fstab; then
        echo "/swapfile none swap sw 0 0" >> /etc/fstab
    fi
fi

# Why 10 instead default 60? see https://help.ubuntu.com/community/SwapFaq#:~:text=a%20value%20of%20swappiness%3D10%20is%20recommended
echo 10 | tee /proc/sys/vm/swappiness
echo "vm.swappiness=10" | tee -a /etc/sysctl.conf
Avril 2025, quelle est mon expérience Kubernetes ?
J'ai commencé à utiliser Kubernetes pour la première fois en janvier 2016. C'était dans un cadre professionnel, quand je travaillais chez Tech-Angels / Gemnasium.
Mes deux premiers projets étaient les suivants :
- Opérer et continuer à améliorer un cluster de 3 nodes basé sur OpenShift (surcouche Kubernetes de Red Hat) qui permettait d'héberger les services web de nos clients.
L'objectif était de fournir un service un peu comme Heroku, c'est-à-dire permettre un déploiement via un simple "git push".
Avec le recul, l'objectif ressemblait à ce que propose actuellement Clever Cloud. - Implémenter une version OnPremise de Gemnasium propulsée par Kubernetes.
En janvier 2016, Kubernetes était un projet très jeune, avec seulement 20 mois d'existence depuis la sortie de la première version 0.2.
L'écosystème était bien plus petit que maintenant. Par exemple, Helm n'était pas encore populaire.
J'ai commencé par installer la version 1.1 de Kubernetes avec les playbooks officiels Ansible.
Ce fut une expérience difficile, avec de nombreux crashs de clusters, tout particulièrement lors des montées en version.
L'expérience fut très enrichissante. Cela m'a permis de monter en compétence avec Docker, Kubernetes, Ceph…
J'ai ensuite utilisé Kubernetes de novembre 2018 à avril 2019, dans la team Kubernetes Kapsule de Scaleway.
La mission de cette équipe était de créer un produit qui permettait de déployer des clusters Kubernetes managés.
Je suis arrivé dans cette équipe 10 mois après le début du projet. J'ai contribué au projet pendant 5 mois, jusqu'au lancement du produit en production.
Cette fois encore, une partie du travail était de déployer des clusters Kubernetes from "scatch".
Expérience intéressante : j'ai appris à déployer des clusters Kubernetes via Kubernetes !
L'implémentation était inspirée de la méthode présentée dans cet article : Gardener - The Kubernetes Botanist.
Depuis avril 2019, je n'ai plus opéré de cluster Kubernetes. J'ai seulement continué à suivre de loin les actualités de cet écosystème. Je n'ai plus eu d'expérience pratique.
Maintenant que j'ai rejoint une mission dont le produit est déployé sur Kubernetes, je souhaite mettre à jour mes compétences pratiques dans ce domaine.
Voici quelques sujets sur lesquels je souhaite monter en compétence ces prochains mois :
- M'entrainement à utiliser et à créer des Helm Charts
- Déployer un ArgoCD pour apprendre à bien l'utiliser
- Jouer avec k3s
- Tester Postgres Operator
- Étudier et tester https://tilt.dev/
- kind (https://kind.sigs.k8s.io/)
- Grafana Tanka
- kustomize (https://github.com/kubernetes-sigs/kustomize)
Object Storage append-only backup playground
Pour un projet, je dois mettre en place un système de sauvegarde sécurisé (WORM).
Ici, "sécurisé" signifie :
- qui empêche la suppression accidentelle ou intentionnelle des données ;
- une protection contre les ransomwares.
Pour cela, j'ai décidé de sauvegarder ces données chez deux fournisseurs d'Object Storage :
Je viens de publier le playground append-only-backup-playground qui m'a permis de tester la configuration de bucket Backblaze et Scaleway.
Object Storage append-only backup playground
In this "playground" repository, I explore different methods to configure object storage services in append-only or write-once-read-many (WORM) mode.
J'ai testé deux méthodes qui interdisent la suppression des données :
1.La première, basée sur une clé d'accès avec des droits limités : l'interdiction de supprimer des fichiers. Si un attaquant parvient à s'infiltrer sur un serveur qui effectue des sauvegardes, la clé ne lui permettra pas d'effacer les anciennes sauvegardes.2.La seconde méthode plus stricte utilise la fonctionnalité object lock en modeGOVERNANCEouCOMPLIANCE.
Je vous recommande d'être vigilant avec le mode COMPLIANCE, car il vous sera impossible de supprimer les fichiers avant leur date de rétention, sauf si vous décidez de supprimer entièrement votre compte client !
Personnellement, je recommande d'utiliser la méthode 1 pour tous les environnements de développement.
En général, je pense que la méthode 1 est suffisante, même pour les environnements de production. Mais si les données sont vraiment critiques, alors je conseille le mode GOVERNANCE ou COMPLIANCE.
Le repository append-only-backup-playground contient 4 playgrounds :
- Pour tester la méthode
1:/scaleway/: configuration d'un bucket Scaleway Object Storage et une clé qui ne peut pas supprimer de fichier. L'option de versionning est activée./backblaze/: configuration d'un bucket Backblaze et une clé qui ne peut pas supprimer de fichier. L'option de versionning est activée.
- Pour tester la méthode
2:/scaleway-object-lock/: la même chose que/scaleway/avec en plus la configuration de object lock en modeGOVERNANCEavec une durée de rétention définie à 1 jour./backblaze-object-lock/: la même chose que/backblaze/avec en plus la configuration de object lock en modeGOVERNANCEavec une durée de rétention définie à 1 jour.
Journal du vendredi 17 janvier 2025 à 12:03
Suite de ma note 2025-01-15_1350.
Voici la réponse que j'ai reçu :
Notre équipe produit est revenue vers nous pour nous indiquer qu’en effet il y a un défaut de documentation.
Ce process alternatif ne fonctionne que sur la racine des domaines pas sur un sous domaine.
C’était pour les tlds qui ne donnent pas de DNS par défaut aux clients.