
Recherche
Filtre actif, cliquez pour en enlever un tag :
Cliquez sur un tag pour affiner votre recherche :
Résultat de la recherche (10 notes) :
Journal du vendredi 03 janvier 2025 à 15:45
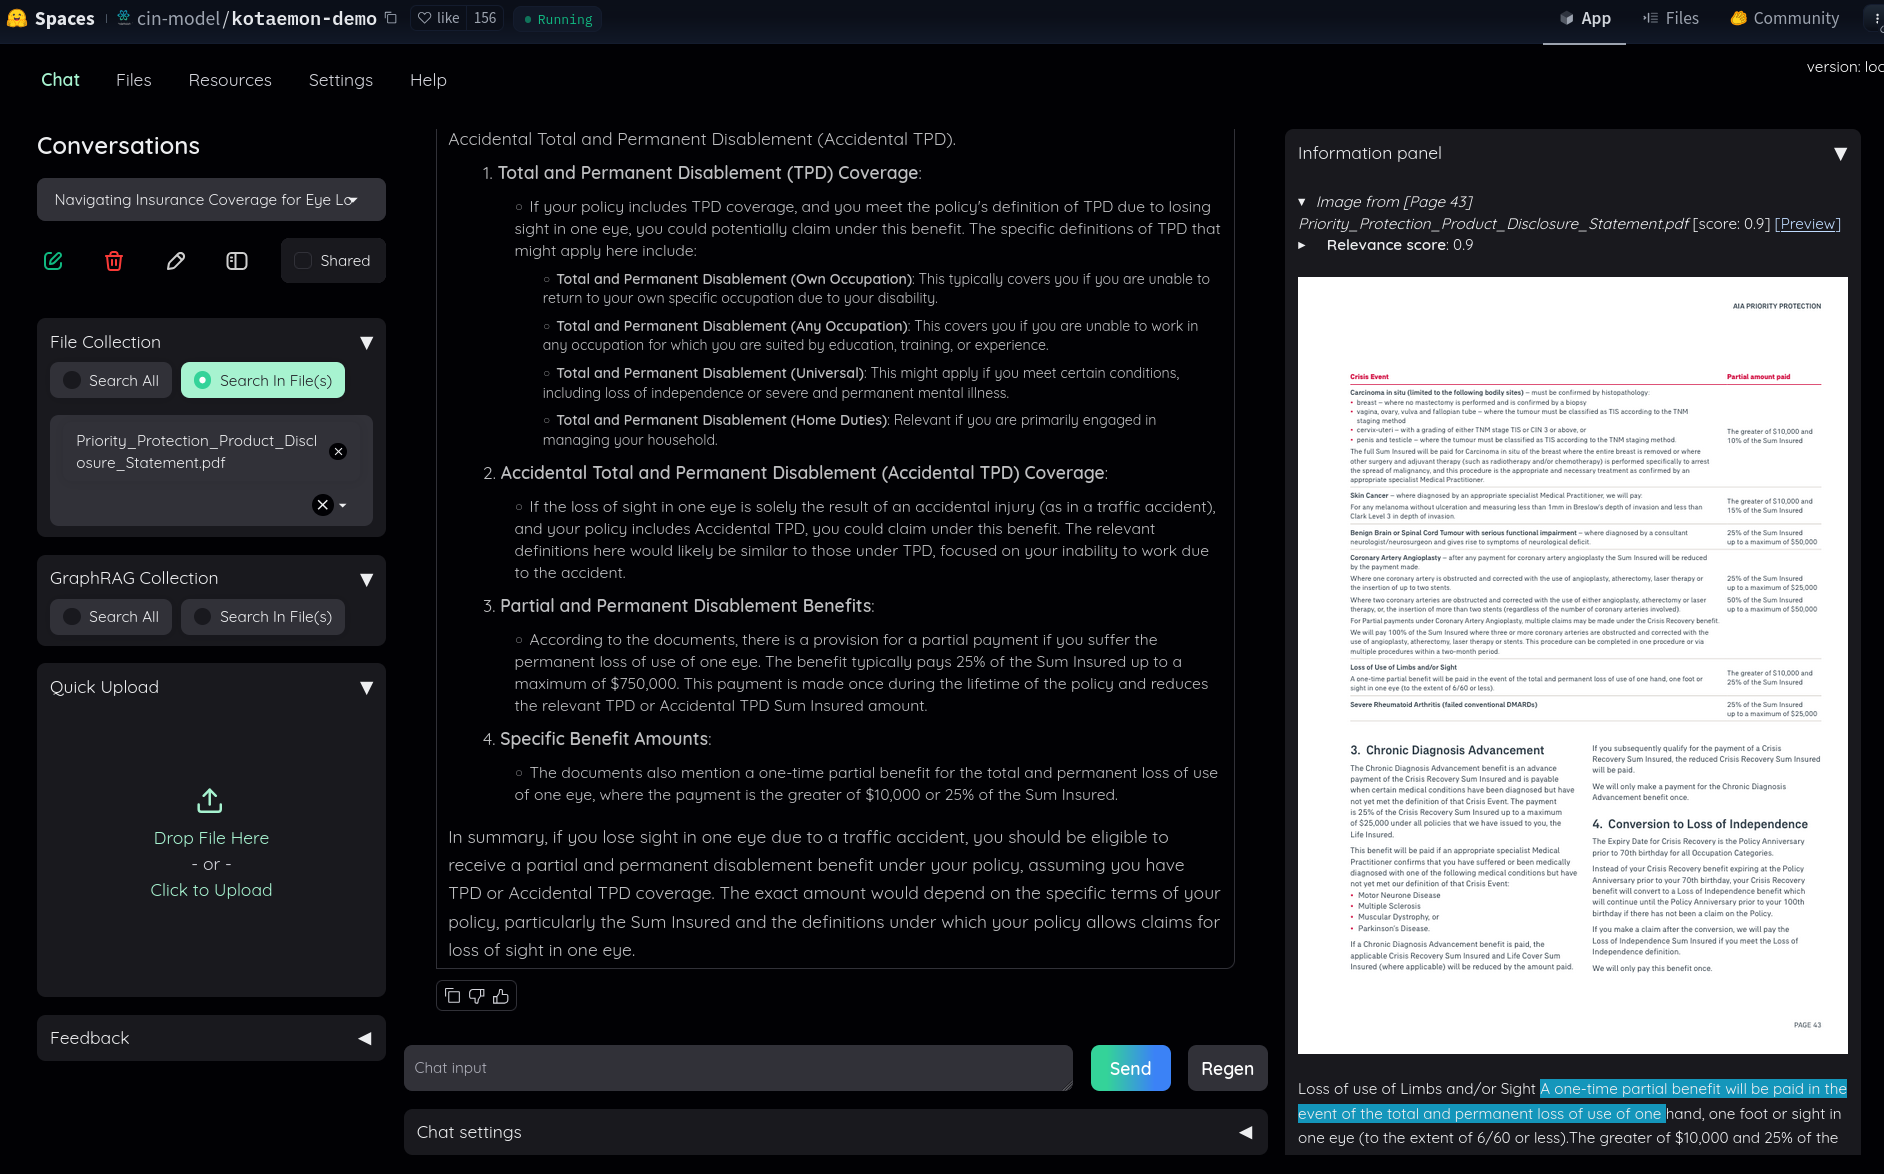
Dans ce thread Hacker News, #JaiDécouvert le RAG kotaemon (https://github.com/Cinnamon/kotaemon).
J'ai fait un simple test sur "Live Demo", j'ai trouvé le résultat très intéressant :
Dans le README, #JaiDécouvert GraphRAG (https://github.com/microsoft/graphrag), nano-graphrag (https://github.com/gusye1234/nano-graphrag) et LightRAG (https://github.com/HKUDS/LightRAG).
J'ai compris que kotaemon peut fonctionner avec nano-graphrag, LightRAG et GraphRAG et que nano-graphrag était recommandé.
J'ai lu :
Support for Various LLMs: Compatible with LLM API providers (OpenAI, AzureOpenAI, Cohere, etc.) and local LLMs (via
ollamaandllama-cpp-python).
J'ai l'impression que kotaemon est un outil de RAG complet, prêt à l'emploi, contrairement à llama_index qui se positionne davantage comme une bibliothèque de plus bas niveau.
Dans le Projet 20 - "Créer un POC d'un RAG", je pense commencer par tester kotaemon.
Journal du jeudi 26 décembre 2024 à 15:03
J'ai partagé Projet 20 - "Créer un POC d'un RAG" à un ami, il m'a dit « Pourquoi ne pas entraîner directement un modèle ? ».
Voici ma réponse sous forme de note.
Je tiens à préciser que je ne suis pas un expert du domaine.
Dans le manuscrit de l'épisode Augmenter ChatGPT avec le RAG de Science4All, je lis :
Quatre grandes catégories de solutions ont été proposées pour faire en sorte qu'un algorithme de langage apprenne une information.
Voici cette liste :
-
- le pré-entraînement, ou "pre-training" en anglais
-
- "peaufinage", qu'on appelle "fine-tuning" en anglais
Concernant le pre-training, je lis :
En pratique, ce pré-entraînement est toutefois très insuffisant pour que les algorithmes de langage soient capables de se comporter de manière satisfaisante.
Ensuite, je lis au sujet du fine-tuning :
Pour augmenter la fiabilité de l'algorithme, on peut alors effectuer un "peaufinage", qu'on appelle "fine-tuning" en anglais, et qui consiste typiquement à demander à des humains d'évaluer différentes réponses de l'algorithme.
...
Cependant, cette approche de peaufinage est coûteuse, à la fois en termes de ressources humaines et de ressources en calculs, et son efficacité est loin d'être suffisante pour une tâche aussi complexe que le langage.
Notez qu'on parle aussi de "peaufinage" pour la poursuite du pré-entraînement, mais cette fois sur des données proches du cas d'usage de l'algorithme. C'est typiquement le cas quand on part d'un algorithme open-weight comme Llama, et qu'on cherche à l'adapter aux contextes d'utilisation d'une entreprise particulière. Mais là encore, le coût de cette approche est important, et son efficacité est insuffisante.
Ensuite, au sujet du pré-prompting, je lis :
si cette approche est la plus efficace et la moins coûteuse, elle demeure encore très largement non-sécurisée ; et il faut s'attendre à ce que le chatbot déraille. Mais surtout, le pré-prompting est nécessairement limité car il ne peut pas être trop long.
Et, pour finir, je lis :
Je trouve que le paragraphe suivant donne une bonne explication du fonctionnement d'un RAG :
L'idée du RAG est la suivante : on va indexer tout un tas de documents qu'on souhaite enseigner à l'algorithme, et on va définir des méthodes pour lui permettre d'identifier, étant donné une requête d'un utilisateur, les bouts de documents qui sont les plus pertinents pour répondre à la requête de l'utilisateur. Ces bouts de documents sont ainsi "récupérés", et ils seront alors ajoutés à un preprompt fourni à l'algorithme, d'où "l'augmentation". Enfin, on va demander à l'algorithme de générer une réponse avec ce préprompt, d'où le nom de "Retrieval Augmented Generation". La boucle est bouclée !
Après lecture de ces informations, je pense qu'entrainer directement un modèle est une solution moins efficace qu'utiliser un RAG pour les objectifs décrits dans le Projet 20 - "Créer un POC d'un RAG".
Journal du vendredi 17 mai 2024 à 11:05
Dans l'article "Qu'est-ce que la génération augmentée de récupération (RAG, retrieval-augmented generation) ?" je découvre l'acronyme Génération Augmentée de Récupération.
Je constate qu'il existe un paragraphe à ce sujet sur Wikipedia.
The initial phase utilizes dense embeddings to retrieve documents.
Je tombe encore une fois sur "embeddings", #JaimeraisUnJour prendre le temps de comprendre correctement cette notion.
Prenez l'exemple d'une ligue sportive qui souhaite que les fans et les médias puisse utiliser un chat pour accéder à ses données et obtenir des réponses à leurs questions sur les joueurs, les équipes, l'histoire et les règles du sport, ainsi que les statistiques et les classements actuels. Un LLM généralisé pourrait répondre à des questions sur l'histoire et les règles ou peut-être décrire le stade d'une équipe donnée. Il ne serait pas en mesure de discuter du jeu de la nuit dernière ou de fournir des informations actuelles sur la blessure d'un athlète, parce que le LLM n'aurait pas ces informations. Étant donné qu'un LLM a besoin d'une puissance de calcul importante pour se réentraîner, il n'est pas possible de maintenir le modèle à jour.
Le contenu de ce paragraphe m'intéresse beaucoup, parce que c'était un de mes objectifs lorsque j'ai écrit cette note en juin 2023.
Sans avoir fait de recherche, je pensais que la seule solution pour faire apprendre de nouvelles choses — injecter de nouvelle données — dans un modèle était de faire du fine-tuning.
En lisant ce paragraphe, je pense comprendre que le fine-tuning n'est pas la seule solution, ni même, j'ai l'impression, la "bonne" solution pour le use-case que j'aimerais mettre en pratique.
En plus du LLM assez statique, la ligue sportive possède ou peut accéder à de nombreuses autres sources d'information, y compris les bases de données, les entrepôts de données, les documents contenant les biographies des joueurs et les flux d'actualités détaillées concernant chaque jeu.
#JaimeraisUnJour implémenter un POC pour mettre cela en pratique.
Dans la RAG, cette grande quantité de données dynamiques est convertie dans un format commun et stockée dans une bibliothèque de connaissances accessible au système d'IA générative.
Les données de cette bibliothèque de connaissances sont ensuite traitées en représentations numériques à l'aide d'un type spécial d'algorithme appelé modèle de langage intégré et stockées dans une base de données vectorielle, qui peut être rapidement recherchée et utilisée pour récupérer les informations contextuelles correctes.
Intéressant.
Il est intéressant de noter que si le processus de formation du LLM généralisé est long et coûteux, c'est tout à fait l'inverse pour les mises à jour du modèle RAG. De nouvelles données peuvent être chargées dans le modèle de langage intégré et traduites en vecteurs de manière continue et incrémentielle. Les réponses de l'ensemble du système d'IA générative peuvent être renvoyées dans le modèle RAG, améliorant ses performances et sa précision, car il sait comment il a déjà répondu à une question similaire.
Ok, si je comprends bien, c'est la "kill feature" du RAG versus du fine-tuning.
bien que la mise en oeuvre de l'IA générative avec la RAG est plus coûteux que l'utilisation d'un LLM seul, il s'agit d'un meilleur investissement à long terme en raison du réentrainement fréquent du LLM
Ok.
Bilan de cette lecture, je dis merci à Alexandre de me l'avoir partagé, j'ai appris RAG et #JePense que c'est une technologie qui me sera très utile à l'avenir 👌.
Dépôt GitHub : https://github.com/microsoft/graphrag
Dépot GitHub : https://github.com/HKUDS/LightRAG
Dépôt GitHub : https://github.com/gusye1234/nano-graphrag
Dépôt GitHub : https://github.com/Cinnamon/kotaemon
Projet 20 - "Créer un POC d'un RAG"
Date de la création de cette note : 2024-12-20.
Quel est l'objectif de ce projet ?
Je souhaite réaliser un POC qui setup un Retrieval-augmented generation (RAG) qui permet d'aller chercher des informations dans des documents.
Fonctionnalités que j'aimerais arriver à implémenter :
- Le LLM doit pouvoir indiquer précisément ses sources pour chaque réponse.
- Le LLM devrait être en mesure de s’inspirer du style des documents importés dans le RAG.
- Les informations importées dans le RAG doivent avoir une priorité absolue sur les connaissances préexistantes du moteur LLM.
Je souhaite me baser sur LLaMa.
Dans ce projet, je souhaite aussi étudier les coûts d'hébergement d'un RAG.
Documents à importer dans le RAG ?
Mes critères de sélection sont les suivants :
- Des documents récents, contenant de préférence des informations inconnues des modèles LLaMa.
- Des documents en français.
- Des documents en libre accès.
- Si possible, avec peu de tableaux.
J’avais envisagé d’importer des threads de Hacker News via https://hnrss.github.io/, mais je préfère réaliser mes tests en français.
J’ai également exploré https://fr.wikinews.org, mais le projet contient malheureusement trop peu d’articles.
Finalement, je pense importer les 10 derniers articles disponibles sur https://www.projets-libres.org/interviews/.
Autres projets en lien avec celui-ci
Pourquoi je souhaite réaliser ce projet ?
Je souhaite implémenter un RAG depuis que j'ai commencé à utiliser ChatGPT — début 2023 (par exemple, ici ou ici).
Alexandre souhaite aussi réaliser ce type de POC : https://github.com/Its-Alex/backlog/issues/25.
Je pense qu'un RAG me serait utile pour interroger mon Personal knowledge management. Un RAG m'aurait été utile quand j'étais président du club de Tennis de Table d'Issy-les-Moulineaux.
De plus, j'ai plusieurs projets professionnels qui pourraient bénéficier d'un RAG.
Repository de ce projet :
rag-poc(je n'ai pas encore créé ce repository)
Liste de tâches
- [ ] Étudier kotaemon. Après cette étude, à moins d'avoir découvert des éléments bloquants :
- [ ] Réaliser un POC de kotaemon
- [ ] Étudier llama_index
Ressources :
- Augmenter ChatGPT avec le RAG de Science4All (version texte)
- https://github.com/topics/rag
- https://github.com/run-llama/llama_index
- https://github.com/run-llama/llama_parse
- https://www.youtube.com/watch?v=u5Vcrwpzoz8
- https://ollama.com/blog/embedding-models
- https://github.com/Cinnamon/kotaemon (voir note 2025-01-03_1545)
Date de la création de cette note : 9 septembre 2026.
Quel est l'objectif de ce projet ?
Je souhaite créer un POC pour tester et apprendre à construire un pipeline Retrieval-augmented generation (RAG) complet en NodeJS, avec des briques de base comme pgvector, pg_search (BM25), le reranking et AI SDK.
Je souhaite tester mon RAG avec les documents suivants :
- Système national d'économie politique (1841) de Friedrich List
- Sophismes économiques (1845-1848) de Frédéric Bastiat
Ces deux livres sont disponibles en Creative Commons sur Wikisource.
Ce projet sera découpé en 4 composants :
- la préparation des documents sources et la génération des résumés hiérarchiques
- le découpage en paragraphes, la génération des sidecars JSONL et des embeddings, et leur versionnement dans git
- le chargement en base et l'indexation (modèle de données PostgreSQL)
- le service de recherche MCP du RAG
Composant 1 : Préparation des documents et génération des résumés hiérarchiques
Je connaissais RAPTOR, mais en creusant le sujet avec Sonnet 5, j'ai compris que RAPTOR n'est pas une technique concurrente de la hierarchical summarization : c'est un type de hierarchical summarization, qui construit son arbre par clustering.
RAPTOR prépare les embeddings avant de les regrouper : avec Uniform Manifold Approximation and Projection (UMAP), il rapproche les contenus similaires dans un espace simplifié ; avec Gaussian Mixture Model (GMM), il identifie des groupes de contenus proches ; il fait résumer chaque groupe par un LLM, puis recommence récursivement. Cette approche est bien adaptée à un corpus dont on ignore la structure.
Or mes sources sont des livres : des documents dont la structure (livres, chapitres) est connue d'avance et reflète l'organisation des idées. Plutôt que de redécouvrir cette structure par clustering, je pense qu'il est plus simple, plus fiable, plus rapide et moins gourmand en ressources de s'appuyer directement dessus. J'ai découvert avec DeepSeek que cette technique se nomme hierarchical summarization structurel (structure-driven).
Une indexation de type hierarchical summarization structurel consistera à construire un arbre de nœuds : le niveau 0 est le contenu source découpé en paragraphes — il n'est pas résumé — et un LLM génère les résumés des niveaux 1 à 3 :
- Niveau 0 : le contenu source, tel qu'extrait des fichiers sources, découpé en paragraphes — ce sont les feuilles de l'arbre, pas des résumés (aucun LLM ici)
- Niveau 1 : un résumé par section de premier niveau — chapitre, ou pièce liminaire rattachée directement à l'ouvrage (préface, introduction) —, généré par défaut à partir des nœuds de niveau 0 de cette section
- Niveau 2 : un résumé par partie de l'ouvrage — nommée « livre » chez List, « série » chez Bastiat —, généré par défaut à partir des résumés de niveau 1
- Niveau 3 : un résumé de l'ouvrage entier, généré par défaut à partir des résumés de niveau 2 des parties et des résumés de niveau 1 des pièces liminaires
Le niveau d'un nœud décrit sa position dans l'arbre de résumés (son degré d'abstraction), pas l'origine de sa génération.
Par défaut, chaque résumé est donc construit à partir des résumés du niveau précédent. Je souhaite pouvoir configurer un algorithme alternatif, plus gourmand en ressources LLM, mais rendu techniquement possible par les modèles LLM qui supportent de très grandes context windows, où certains résumés sont construits à partir d'une source plus directe :
- le niveau 2 est construit à partir du contenu de tous les chapitres de la partie, sans passer par les résumés du niveau 1
- le niveau 3 est construit à partir des résumés de niveau 1, sans passer par les résumés du niveau 2
Je pense que l'un de mes défis sera de concevoir un bon prompt pour générer les résumés : le résumé doit être fidèle au contenu tout en servant mon angle d'analyse, et le prompt devra sans doute s'adapter à la thématique du livre et au niveau du résumé (section, partie, œuvre).
corpus/
├── list-systeme-national-economie-politique/
│   ├── summary.md                            # résumé de l'œuvre (niveau 3)
│   ├── preface/                              # préface de l'auteur (le paratexte du traducteur est exclu du corpus)
│   │   ├── source.md                         # texte de la préface
│   │   └── summary.md                        # résumé de la préface (niveau 1)
│   ├── introduction/
│   │   ├── source.md
│   │   └── summary.md                        # résumé de l'introduction (niveau 1)
│   ├── livre-1-l-histoire/
│   │   ├── summary.md                        # résumé du "Livre premier" (niveau 2)
│   │   ├── chapitre-01-les-italiens/
│   │   │   ├── source.md
│   │   │   └── summary.md                    # résumé du chapitre (niveau 1)
│   │   ├── chapitre-02-les-anseates/
│   │   │   ├── source.md
│   │   │   └── summary.md
│   │   └── ...
│   ├── livre-2-la-theorie/
│   │   ├── summary.md
│   │   ├── chapitre-01-l-economie-politique-et-l-economie-cosmopolite/
│   │   │   ├── source.md
│   │   │   └── summary.md
│   │   └── ...
│   ├── livre-3-les-systemes/
│   │   ├── summary.md
│   │   ├── chapitre-01-les-economistes-italiens/
│   │   │   ├── source.md
│   │   │   └── summary.md
│   │   └── ...
│   └── livre-4-la-politique/
│       ├── summary.md
│       ├── chapitre-01-la-suprematie-insulaire-et-les-puissances-continentales/
│       │   ├── source.md
│       │   └── summary.md
│       └── ...
└── bastiat-sophismes-economiques/
    ├── summary.md                            # résumé de l'œuvre (niveau 3)
    ├── premiere-serie/
    │   ├── summary.md                        # résumé de la première série (niveau 2)
    │   ├── chapitre-01-abondance-disette/
    │   │   ├── source.md
    │   │   └── summary.md                    # résumé du chapitre (niveau 1)
    │   └── ...
    └── deuxieme-serie/
        ├── summary.md                        # résumé de la deuxième série (niveau 2)
        ├── chapitre-01-physiologie-de-la-spoliation/
        │   ├── source.md
        │   └── summary.md
        └── ...
Je pense ajouter dans le frontmatter des documents sources Markdown un indicateur pour marquer explicitement les documents à vectoriser ou non.
Chaque fichier source.md ou summary.md du corpus porte aussi dans son frontmatter le champ parent_source_file : le chemin, relatif au corpus, du fichier du nœud parent dans l'arbre de résumés. Ce champ suit la règle de génération des résumés : un source.md a pour parent le summary.md de sa section (celui du même dossier) ; un summary.md de chapitre a pour parent le summary.md de la partie qui le contient ; un summary.md de pièce liminaire (préface, introduction) ou de partie a pour parent le summary.md de l'œuvre ; le summary.md de l'œuvre, racine de l'arbre, n'a pas de parent.
Composant 2 : Génération des sidecars et versionnement des embeddings
La fonction de ce composant est de découper en paragraphes le contenu des fichiers Markdown du composant 1, de vectoriser les fichiers que le frontmatter marque à vectoriser, et d'enregistrer le résultat dans des fichiers sidecar à côté des fichiers sources, pour les versionner dans git. Un sidecar est généré pour chaque fichier, qu'il soit vectorisé ou non ; le sidecar d'un fichier non vectorisé contient les paragraphes sans embeddings (voir l'exemple plus bas). Le composant 2 recopie aussi dans le manifest de chaque sidecar le champ parent_source_file lu dans le frontmatter du fichier .md (renseigné par le composant 1).
Voici l'équivalent de la précédente arborescence de fichiers avec en plus les fichiers sidecars :
# Sidecars *.md.jsonl : un sidecar est généré pour chaque fichier, vectorisé ou non.
# Chaque paragraphe du fichier donne une ligne ; les fichiers vectorisés contiennent des
# champs embeddings, les autres non (cas « tout vectorisé » illustré ici — voir exemple JSONL plus bas).
corpus/
├── list-systeme-national-economie-politique/
│   ├── summary.md                            # résumé de l'œuvre (niveau 3)
│   ├── summary.md.jsonl
│   ├── preface/                              # préface de l'auteur (le paratexte du traducteur est exclu du corpus)
│   │   ├── source.md
│   │   ├── source.md.jsonl
│   │   ├── summary.md
│   │   └── summary.md.jsonl
│   ├── introduction/
│   │   ├── source.md
│   │   ├── source.md.jsonl
│   │   ├── summary.md
│   │   └── summary.md.jsonl
│   ├── livre-1-l-histoire/
│   │   ├── summary.md                        # résumé du "Livre premier" (niveau 2)
│   │   ├── summary.md.jsonl
│   │   ├── chapitre-01-les-italiens/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md                    # résumé du chapitre (niveau 1)
│   │   │   └── summary.md.jsonl
│   │   ├── chapitre-02-les-anseates/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md
│   │   │   └── summary.md.jsonl
│   │   └── ...
│   ├── livre-2-la-theorie/
│   │   ├── summary.md
│   │   ├── summary.md.jsonl
│   │   ├── chapitre-01-l-economie-politique-et-l-economie-cosmopolite/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md
│   │   │   └── summary.md.jsonl
│   │   └── ...
│   ├── livre-3-les-systemes/
│   │   ├── summary.md
│   │   ├── summary.md.jsonl
│   │   ├── chapitre-01-les-economistes-italiens/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md
│   │   │   └── summary.md.jsonl
│   │   └── ...
│   └── livre-4-la-politique/
│       ├── summary.md
│       ├── summary.md.jsonl
│       ├── chapitre-01-la-suprematie-insulaire-et-les-puissances-continentales/
│       │   ├── source.md
│       │   ├── source.md.jsonl
│       │   ├── summary.md
│       │   └── summary.md.jsonl
│       └── ...
└── bastiat-sophismes-economiques/
    ├── summary.md                            # résumé de l'œuvre (niveau 3)
    ├── summary.md.jsonl
    ├── premiere-serie/
    │   ├── summary.md                        # résumé de la première série (niveau 2)
    │   ├── summary.md.jsonl
    │   ├── chapitre-01-abondance-disette/
    │   │   ├── source.md
    │   │   ├── source.md.jsonl
    │   │   ├── summary.md                    # résumé du chapitre (niveau 1)
    │   │   └── summary.md.jsonl
    │   └── ...
    └── deuxieme-serie/
        ├── summary.md                        # résumé de la deuxième série (niveau 2)
        ├── summary.md.jsonl
        ├── chapitre-01-physiologie-de-la-spoliation/
        │   ├── source.md
        │   ├── source.md.jsonl
        │   ├── summary.md
        │   └── summary.md.jsonl
        └── ...
Voici ci-dessous un exemple de fichier sidecar JSONL pour un fichier Markdown source vectorisé. Le découpage s'effectue par paragraphes : chaque paragraphe devient un chunk, sauf si un paragraphe dépasse le seuil de tokens défini (voir composant 2), auquel cas il est subdivisé. Le champ source_file_hash est abrégé ici pour la lisibilité ; il porte en réalité le SHA-256 complet du fichier. Chaque manifest porte aussi parent_source_file, le chemin relatif au corpus du fichier du nœud parent ; ce champ est absent (NULL) pour la racine de l'arbre — le summary.md de l'œuvre.
{
  "type": "manifest",
  "source_file": "corpus/list-systeme-national-economie-politique/livre-1-l-histoire/chapitre-01-les-italiens/source.md",
  "source_file_hash": "sha256:2cf24d…",
  "parent_source_file": "corpus/list-systeme-national-economie-politique/livre-1-l-histoire/chapitre-01-les-italiens/summary.md",
  "heading_path": "Système national d'économie politique > Livre I > Chapitre I (Les Italiens)",
  "level": 0,
  "node_type": "source",
  "embedding_model": "text-embedding-3-small",
  "dimension": 1536,
  "chunk_count": 3
}
{
  "chunk_index": 0,
  "content_token_count": 782,
  "text": "…texte exact du premier chunk embeddé…",
  "embedding": [-0.013, 0.022, 0.107, -0.041, …]
}
{
  "chunk_index": 1,
  "content_token_count": 756,
  "text": "…texte exact du deuxième chunk embeddé…",
  "embedding": [0.041, -0.017, 0.094, 0.002, …]
}
{
  "chunk_index": 2,
  "content_token_count": 803,
  "text": "…texte exact du troisième chunk embeddé…",
  "embedding": [-0.007, 0.011, -0.052, 0.018, …]
}
Voici l'exemple d'un fichier non vectorisé : le sidecar est bien généré, avec le même découpage par paragraphes, mais le manifest ne porte ni embedding_model ni dimension et aucune ligne ne contient d'embedding. Ces paragraphes ne sont retrouvables qu'en BM25.
{
  "type": "manifest",
  "source_file": "corpus/bastiat-sophismes-economiques/premiere-serie/chapitre-01-abondance-disette/source.md",
  "source_file_hash": "sha256:f53b7d…",
  "parent_source_file": "corpus/bastiat-sophismes-economiques/premiere-serie/chapitre-01-abondance-disette/summary.md",
  "heading_path": "Sophismes économiques > Première série > Chapitre I (Abondance, disette)",
  "level": 0,
  "node_type": "source",
  "chunk_count": 2
}
{
  "chunk_index": 0,
  "content_token_count": 612,
  "text": "…texte exact du premier paragraphe…"
}
{
  "chunk_index": 1,
  "content_token_count": 538,
  "text": "…texte exact du deuxième paragraphe…"
}
Composant 3 : Chargement en base et indexation (pgvector + pg_search)
Je souhaite importer tout cela dans une base de données PostgreSQL configurée avec les extensions suivantes : pgvector pour la recherche sémantique vectorielle et pg_search pour la recherche BM25.
Exemple de schéma de modèle de données :
CREATE TABLE hierarchical_content_nodes (
  id SERIAL PRIMARY KEY,

  -- Profondeur dans la hiérarchie, du contenu source vers les résumés les plus abstraits.
  -- Convention générale (adaptable selon la profondeur réelle de chaque ouvrage) :
  --   0 = contenu source (un paragraphe extrait du fichier source)
  --   1 = résumé d'une section de premier niveau (chapitre, ou pièce liminaire comme
  --       la préface ou l'introduction), généré par défaut à partir des nœuds de niveau 0
  --       de cette section
  --   2 = résumé d'une partie de l'ouvrage (livre chez List, série chez Bastiat), généré
  --       par défaut à partir des résumés de niveau 1
  --   3 = résumé de l'ouvrage entier, généré par défaut à partir des résumés de niveau 2
  --       des parties et des résumés de niveau 1 des pièces liminaires
  level INT NOT NULL,

  -- Chemin relatif au corpus du fichier du nœud parent dans l'arbre de résumés
  -- (champ `parent_source_file` du manifest, recopié du frontmatter du .md).
  -- Un nœud = un fichier : toutes les lignes d'un même `source_file` (les
  -- paragraphes d'un résumé éventuellement multi-paragraphes) forment un seul
  -- nœud, et les lignes d'un même nœud partagent donc le même parent. NULL pour
  -- la racine (summary.md de l'œuvre, niveau 3). Pas de contrainte de clé
  -- étrangère possible : `source_file` n'est pas unique dans cette table ;
  -- l'intégrité (existence du sidecar du fichier parent) est vérifiée à l'import.
  parent_source_file TEXT,

  node_type TEXT NOT NULL CHECK (node_type IN ('source', 'summary')),

  -- Fichier Markdown (source.md ou summary.md) dont est issu ce nœud (sortie du
  -- composant 1), chemin relatif au corpus. Identique au champ `source_file` du manifest
  -- du sidecar JSONL du composant 2.
  source_file TEXT NOT NULL,

  -- Hash SHA-256 du fichier Markdown au moment de la génération du sidecar
  -- (champ `source_file_hash` du manifest). Détecte un .md modifié
  -- depuis sa dernière indexation → re-génération des lignes correspondantes.
  source_file_hash TEXT NOT NULL,

  -- Index du paragraphe dans son fichier source (champ `chunk_index` du JSONL),
  -- de 0 à chunk_count-1. Un paragraphe est un chunk ; un paragraphe trop long
  -- est subdivisé en plusieurs chunks successifs.
  chunk_index INT NOT NULL,

  -- Chemin hiérarchique lisible du nœud (champ `heading_path` du manifest),
  -- constant pour toutes les lignes issues d'un même fichier.
  -- Exemples (conformes à la convention de niveau ci-dessus) :
  --   'Sophismes économiques > Première série > Chapitre I'                      (level 0, source)
  --   'Sophismes économiques > Première série > Chapitre I (résumé)'             (level 1, summary)
  --   'Sophismes économiques > Première série (résumé)'                          (level 2, summary)
  --   'Sophismes économiques (résumé)'                                           (level 3, summary)
  --   'Système national d'économie politique > Préface'                          (level 0, source)
  --   'Système national d'économie politique > Préface (résumé)'                 (level 1, summary)
  heading_path TEXT,

  -- Contenu du nœud = champ `text` de la ligne JSONL correspondante :
  --   - nœud `summary` → un paragraphe du résumé généré par le LLM ;
  --   - nœud `source` → un paragraphe du fichier source (ou un fragment si le
  --     paragraphe a dû être subdivisé).
  content TEXT NOT NULL,

  -- Nombre de tokens de `content` (champ `content_token_count` du JSONL),
  -- calculé une fois à l'ingestion pour éviter de re-tokenizer à chaque requête.
  -- Sert de garde-fou au moment du retrieval : décider si un nœud peut être
  -- chargé tel quel dans le prompt, ou s'il faut charger ses enfants à la place
  -- (limite de contexte du LLM, limite de tokens par document du reranker).
  -- Un nœud pouvant couvrir plusieurs lignes (résumé multi-paragraphes), son
  -- total se calcule en sommant `content_token_count` sur les lignes de son
  -- `source_file`. « Charger les enfants » d'un nœud = lire les lignes dont
  -- `parent_source_file` pointe vers ce fichier.
  content_token_count INT,

  -- Nom du modèle d'embedding utilisé (champ `embedding_model` du manifest).
  -- Modèle unique pour tout le corpus à un instant donné (cf. dimension 1536) ;
  -- la politique par fichier porte sur le choix de vectoriser ou non, pas sur le modèle.
  -- Un changement de modèle global invalide tous les vecteurs : le source_file_hash ne
  -- changeant pas dans ce cas, l'import doit comparer le modèle lu dans le sidecar à
  -- celui stocké pour déclencher la re-génération par le composant 2.
  embedding_model TEXT,

  -- Embedding du paragraphe, NULL si le fichier n'est pas vectorisé
  -- (politique d'embedding par fichier, exprimée dans le frontmatter du .md).
  -- Un nœud sans embedding n'est retrouvable qu'en BM25 (pg_search) sur `content`.
  embedding vector(1536),

  created_at TIMESTAMPTZ DEFAULT now(),

  -- Import = lecture d'un sidecar JSONL (sortie du composant 2), un sidecar par fichier,
  -- vectorisé ou non. Le manifest (1re ligne) porte les champs communs au fichier
  -- (source_file, source_file_hash, parent_source_file, heading_path, level, node_type ; embedding_model et
  -- dimension si le fichier est vectorisé) ; chaque ligne suivante (un paragraphe) devient
  -- une ligne de cette table, héritant des champs de son manifest.
  -- L'import est rejouable : à la re-génération d'un fichier, ses lignes sont d'abord
  -- supprimées (DELETE WHERE source_file = …) puis réinsérées, car la contrainte UNIQUE
  -- (source_file, chunk_index) ne suffit pas si le découpage change le nombre de chunks.
  UNIQUE (source_file, chunk_index)
);
Par défaut, je vectorise l'ensemble des documents — contenus sources et résumés — pour permettre la recherche sémantique vectorielle, tout en les indexant aussi en BM25 (pg_search) pour la recherche lexicale. Un fichier .md.jsonl est généré pour chaque fichier ; le sidecar d'un fichier non vectorisé contient les paragraphes sans embeddings, retrouvables uniquement en BM25.
Pour réduire le coût de génération des embeddings et accélérer le traitement, une variante économique consiste à ne pas vectoriser certains niveaux et à ne laisser sur ceux-ci que la recherche BM25. Par exemple : pas d'embedding sur le contenu brut des chapitres, recherche BM25 au niveau des paragraphes, recherche vectorielle réservée aux résumés (sections, parties, œuvre), quitte à charger ensuite les enfants d'un nœud retenu plutôt que le nœud entier.
Composant 4 : Service de recherche MCP du RAG
Après cela, je compte m'inspirer de mes projets sveltekit-ssr-ai-sdk-poc et toggl-pg-mirror pour implémenter le service MCP de recherche d'information dans le RAG.
Contrairement à ces deux exemples de service MCP, cette fois, je pense que je ne pourrai pas laisser l'agent IA générer en autonomie le code SQL pour faire ses recherches étant donné que la recherche devra vectoriser des chaînes de recherche et effectuer optionnellement du reranking en sortie.
La recherche s'effectue sur les paragraphes (lignes de la table, BM25 et/ou vectorielle selon la politique). Quand un paragraphe est retenu, je prévois de remonter à son nœud parent pour fournir au LLM un contexte élargi plutôt qu'un paragraphe isolé : le nœud parent est le fichier parent_source_file de la ligne retenue — résumé de section, de partie ou de l'œuvre selon la position — et la remontée consiste à charger toutes les lignes dont le source_file correspond à ce chemin. Un paragraphe du nœud racine (résumé de l'œuvre, niveau 3) n'a pas de parent.
Le choix du modèle de reranking (et sa limite de tokens par document) reste à définir.
Pourquoi je souhaite réaliser ce projet ?
Tout d'abord, je veux grok ce sujet.
Ensuite, je souhaite intégrer un RAG à mon projet sklein-convarchive.
Enfin, je souhaite l'utiliser pour générer des RAG pour divers livres pour permettre à mes agent IA de m'assister avec davantage de rigueur quand je travaille sur des sujets de science sociale.
Repository de ce projet
Dernière page.