
Claude Sonnet
Différentes version de Claude Sonnet :
Journaux liées à cette note :
Héberger des open weights chez Scaleway et OVH : modèles, serveurs et coûts
Après avoir publié ma note "Qu'est-ce que je dois faire signer à mes clients pour être autorisé à analyser leurs données confidentielles avec un LLM ?" je souhaite maintenant identifier les modèles Open Weights que je peux héberger sur les offres GPU Instances de Scaleway et Cloud GPU d'OVH, et à quel coût.
Note : dans ce document, tous les tarifs sont exprimés hors taxes et ont été relevés le 11 septembre 2026.
Version courte
Pour les lecteurs pressés, voici la version courte :
- MiniMax M2.5 hébergé sur 4x H100 coûte de 7 770 € à 9 322 €/mois en continu, ou de 806 € à 919 €/mois pour 72 h.
- DeepSeek-V4-Flash-Vision-Exp hébergé sur 4x ou 8x H200 ou 8x B300, coûte de 16 877 € à 43 800 €/mois en continu, ou de 1 664 € à 4 320 €/mois pour 72 h.
- Ces environnements peuvent confortablement servir environ 32 utilisateurs simultanés, soit environ 200 utilisateurs actifs.
Comment j'ai fait ma sélection de modèle à analyser ?
Pour faire ma sélection de modèle, je me suis basé sur Browse all vLLM recipes et les cookbooks de SGLang, j'ai parcouru toutes les listes et j'ai sélectionné deux modèles aux profils complémentaires : un petit modèle, léger à héberger et que je trouve utile malgré ses limites, et un modèle plus puissant.
Je suis arrivé à la sélection suivante :
- Pour le modèle peu puissant, j'ai sélectionné MiniMax M2.5, dont les capacités se situent entre Claude Sonnet 4.5 (sorti en septembre 2025) et Sonnet 4.6 (sorti en février 2026)
- DeepSeek-V4-Flash-Vision-Exp avec le support de la vision. Cela correspond à mon modèle préféré du moment, pour cela voir ma note Septembre 2026 - je code avec des open weights pour 10 à 30 € par mois
Et voici les serveurs requis pour les faire tourner, indiqués dans leurs recettes vLLM :
- 4x H100 pour MiniMax M2.5 (recette vLLM)
- 4x H200 ou 8x B300 pour DeepSeek-V4-Flash-Vision-Exp (recette vLLM)
Les offres GPU de Scaleway et OVH retenues
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-2-80G | 6,62 € | 4 832 € |
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| Scaleway | H100-SXM-8-80G | 25,33 € | 18 491 € |
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H100 PCIe (80 Go HBM2e) | 11,2 € | 7 770 € |
| OVH | 4x H200 (141 Go HBM3e) | 23,12 € | 16 877 € |
| OVH | 8x H200 (141 Go HBM3e) | 42 € | 30 660 € |
Pages :
- https://www.scaleway.com/fr/tarifs/gpu/?zone=fr-par-2
- https://www.ovhcloud.com/fr/public-cloud/prices/#cloud-gpu
Offres pour faire tourner DeepSeek-V4-Flash-Vision-Exp ?
Tout d'abord, j'ai observé que DeepSeek-V4-Flash-Vision-Exp (~168 Go, recette vLLM) a pratiquement la même taille que DeepSeek-V4-Flash-0731 (~167 Go, checkpoint fused, recette vLLM), l'écart est de moins de 1 Go pour intégrer les couches vision. Par conséquent, je suppose qu'un serveur qui permet de faire tourner la version DeepSeek-V4-Flash peut faire tourner la version DeepSeek-V4-Flash-Vision-Exp.
J'apporte ici ces précisions car la recette vLLM de DeepSeek-V4-Flash contient plus de hardware validé que celle de vLLM de DeepSeek-V4-Flash-Vision-Exp, qui ne valide un run vision que sur 4xGB200. Le cookbook SGLang documente de son côté un run vérifié sur 4xB200. Toujours dans le cookbook SGLang, l'installation sur 4xH200 est annoncée comme pending, même si des essais communautaires sur cette config existent déjà (avec un bug connu sur les tool calls multi-tours).
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, il est probable que DeepSeek-V4-Flash-Vision-Exp peut charger sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | B300-SXM-8-288G | 60 € | 43 800 € |
| OVH | 4x H200 | 23,12 € | 16 877 € |
| OVH | 8x H200 | 42 € | 30 660 € |
Attention : la recette annonce une context window de 1M de tokens, mais elle est explicite sur ce point — cette valeur est annoncée, non mesurée (le run de référence tourne en 32K) et le KV cache d'un contexte 1M réclame bien plus de mémoire que les poids (~202 Go de VRAM avant KV cache). Ces offres garantissent donc le chargement du modèle, pas le service de 1M de tokens ; le contexte réellement tenable reste à mesurer.
J'ai effectué des recherches pour savoir si le modèle pouvait tourner sur 8x H100. D'après les retours, il peut démarrer mais reste instable et bridé en contexte sur cette génération :
| Source | Config | Contexte testé | Statut |
|---|---|---|---|
| #52065 | 8x H100 80G, TP8+EP, fp8 KV, util 0.90 | 65 536 (64K) | Fonctionne sur vLLM 0.26.0, crash sur 0.27.0 avec DSpark |
| #51326 | 8x H100 80G, TP8+EP, util 0.84 | Non précisé | Sortie corrompue sur 0.26.0, correcte sur 0.25.0 |
La variante Vision-Exp stocke ses experts MoE en FP4, un format que seuls les GPU Blackwell accélèrent nativement, et ne publie, côté vLLM, aucun run vision en dehors de GB200 (4x). La recette décrit toutefois une stratégie pour des nœuds 8-GPU H200/B200/B300, mais sans run vision vérifié sur ces machines ; son exécution sur H100 reste donc, au mieux, expérimentale et limitée en contexte.
Offres pour faire tourner MiniMax M2.5 ?
D'après mon analyse à l'aide de Sonnet 5 des pages recettes vLLM, des issues GitHub vLLM et d'autres articles trouvés plus largement sur Internet, je pense que MiniMax M2.5 peut tourner avec une context window de 192K de tokens sur les offres suivantes :
| Provider | Nom de l'instance | Prix à l'heure | Prix par mois |
|---|---|---|---|
| Scaleway | H100-SXM-4-80G | 12,77 € | 9 322 € |
| OVH | 4x H100 (80 Go HBM2) | 11,2 € | 7 770 € |
Tarifs si les serveurs sont loués seulement sur certaines plages horaires
En théorie, si les GPUs sont disponibles dans les stocks des providers, il est possible de les instancier et de les libérer à la demande.
Je pense que si les volumes des disques des VMs sont sauvegardés, une instance doit pouvoir se lancer en quelques minutes, sinon je pense qu'une instance doit pouvoir être provisionnée de zéro en quelques dizaines de minutes.
Je vais faire quelques estimations en fonction des hypothèses de disponibilité suivantes :
- 4 jours par semaine, de 14h à 18h (avec 30 min de démarrage) : 4h30 x 4 x 4 = 72h par mois
- 4 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 4 x 4 = 152h par mois
- 5 jours par semaine, de 9h à 18h (avec 30 min de démarrage) : 9h30 x 5 x 4 = 190h par mois
| Provider | Type de serveur | LLM | Prix à l'heure | 72h / mois | 152h / mois | 190h / mois |
|---|---|---|---|---|---|---|
| Scaleway | 4x H100 | MiniMax | 12,77 € | 919 € | 1 941 € | 2 426 € |
| OVH | 4x H100 | MiniMax | 11,2 € | 806 € | 1 702 € | 2 128 € |
| Scaleway | 8x B300 | DeepSeek | 60 € | 4 320 € | 9 120 € | 11 400 € |
| OVH | 4x H200 | DeepSeek | 23,12 € | 1 664 € | 3 514 € | 4 392 € |
| OVH | 8x H200 | DeepSeek | 42 € | 3 024 € | 6 384 € | 7 980 € |
Attention toutefois, il est nécessaire de passer par le support de Scaleway pour accéder aux instances B300 :
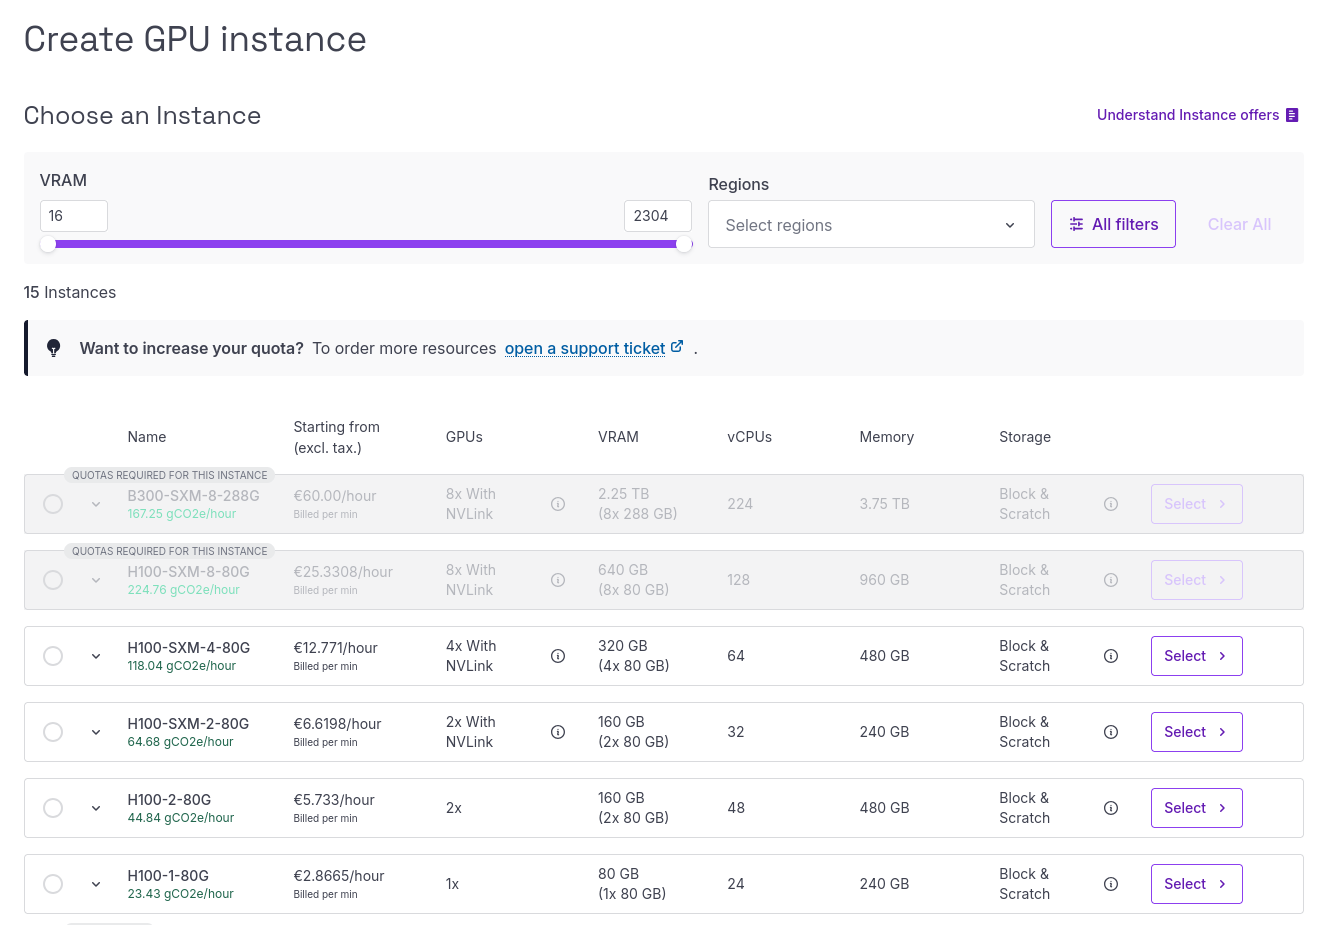
Peut-être qu'il n'est pas possible de louer ce type de machine avec une totale liberté, ce que je pourrais comprendre pour du matériel (8xB300) que Sonnet 5 estime à l'achat entre 300 K€ et 500 K€ pour un serveur complet de 8 GPU.
Estimation du nombre d'utilisateurs simultanés et du débit en tokens par seconde ?
vLLM et SGLang documentent des méthodes de calcul et de benchmark pour faire ce genre d'estimation, par exemple : Parallelism and Scaling, Benchmark CLI, vllm bench serve, Benchmark and Profiling, Bench Serving Guide. Mais je n'ai pas voulu me lancer en profondeur dans ce sujet, d'autant plus que j'ai l'impression que pour obtenir des informations concrètes il est nécessaire de lancer des outils sur l'environnement installé sur le serveur.
À la place, j'ai préféré prendre un raccourci et me baser sur les mesures que j'ai trouvées sur des pages du site Lambda : How to deploy DeepSeek-V4-Flash on Lambda et How to deploy MiniMax M2.5 on Lambda.
Je ne vais pas entrer dans les détails, mais voici les mesures pour DeepSeek-V4-Flash pour 32 utilisateurs en parallèle avec des prompts de 8192 tokens en entrée :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 8x B200 (FP4+FP8 natif) | 38 tok/s | 1 701 ms | 66 ms |
| SGLang | 8x H100 (FP8 quantifié) | 39 tok/s | 2 463 ms | 60 ms |
| vLLM | 8x B200 (FP4+FP8 natif) | 46 tok/s | 1 452 ms | 20 ms |
La même chose pour MiniMax M2.5, toujours pour 32 utilisateurs :
| Backend | Hardware | Par utilisateur | TTFT moyen | ITL moyen |
|---|---|---|---|---|
| SGLang | 2x B200 | 28 tok/s | 3 091 ms | 36 ms |
| SGLang | 4x H100 | 27 tok/s | 13 131 ms | 27 ms |
Voici comment je lis ces chiffres :
TTFT(Time To First Token) : délai avant le premier token affiché à l'écran.ITL(Inter-Token Latency) : écart entre deux tokens consécutifs pendant le decode.- Le débit par utilisateur (27 à 46 tok/s) dépasse la lecture humaine (5 à 10 tok/s), donc l'expérience est confortable. Cette vitesse vaut aussi pour les tokens de réflexion.
La config MiniMax 4xH100 est exactement celle que j'ai retenue chez Scaleway et OVH. Le benchmark s'applique donc directement, contrairement à DeepSeek où Lambda mesure du 8-GPU B200/H100 alors que je vise du 4x ou 8x H200.
Conclusion, en me basant sur ces mesures, je peux espérer qu'avec ces serveurs, l'expérience d'utilisation de ces modèles soit agréable pour 32 utilisateurs en simultané.
C'est un ordre de grandeur : avec DeepSeek, j'ai estimé qu'en réalité un nœud peut servir environ 200 utilisateurs actifs, puisque personne n'envoie de requêtes en continu.
Depuis mars 2026 - je code avec des open weights pour 10 à 30 € par mois
Depuis mi-mars 2026, je suis passé des modèles Anthropic aux modèles Open Weights proposés par OpenCode Go au quotidien.
- En mars j'ai commencé par MiniMax M2.5
- En avril, principalement Kimi K2.5
- En mai, Kimi K2.6
- En juin et juillet DeepSeek-V4-Flash preview
- En août DeepSeek-V4-Flash 0731
- En septembre DeepSeek-V4.1-Flash
Comme le montre la liste ci-dessus, j'utilise les modèles Flash de DeepSeek depuis juin. Je les utilise soit via l'AI provider DeepSeek, soit à travers OpenCode Go.
OpenCode Go plafonne à 10 $ par compte. Fin août, face à la hausse soudaine des tarifs de DeepSeek Flash (annonce du 13 août 2026, discussion sur Hacker News), j'ai ouvert un second compte pour dépasser ce plafond : j'utilise donc deux comptes OpenCode Go à 10 $ par mois (soit 2 × 10 $). Au-delà de 20 $, ou si OpenCode Go est indisponible, je bascule sur le provider DeepSeek direct avec ces tarifs en mode Pay-As-You-Go.
Ces modèles me satisfont pleinement, tant pour le coding que pour l'analyse de texte, la réflexion ou l'aide à l'écriture. Et tout cela à un prix beaucoup plus compétitif que les offres OpenAI ou Anthropic : sur toute cette période, je suis resté entre 10 et 30 € par mois pour du coding.
Je précise tout de même qu'à côté de ces LLM, je possède toujours un abonnement Claude Pro à 18 € HT par mois, que j'utilise principalement sur mon smartphone. Je compte clôturer cet abonnement et à la place, utiliser sur mon smartphone OpenChamber connecté à OpenCode, connecté à DeepSeek V4.1-Flash, mais à ce jour, ce n'est toujours pas fait.
Mon impression de performance des modèles DeepSeek Flash est corroborée par les benchmarks.
Je ne veux pas me lancer, dans cet article, dans une analyse rigoureuse des différents modèles, ce que synthétise de toute façon bien mieux que moi Artificial Analysis.
Je me contenterai ici de partager seulement le benchmark Artificial Analysis Intelligence Index: Score :

Avec Opus 4.5, sorti en novembre 2025, un tournant reconnu dans la communauté s'est produit, et la pratique du coding agentique s'est diffusée (par exemple l'avis du créateur de Redis). Dans cette liste, j'ai sélectionné volontairement ce modèle comme mon jalon, ainsi que Claude Sonnet 4.6, sorti en février 2026, qui atteint empiriquement la même qualité de code pour un prix moindre.
Dans cette liste, j'ai inclus Mistral Medium 3.5, qui est, il me semble, au moment où j'écris ces lignes, le plus puissant de leurs modèles. On peut voir qu'il est en retard sur cet indice par rapport à la plupart des modèles actuels ; de mon côté, je ne vois personne l'utiliser.
Je pars du principe que tout ce qui atteint la qualité d'Opus 4.5 — donc a fortiori de Sonnet 4.6 — m'est utile. À partir de là, comme c'est moi qui paie mes crédits LLM et non mon entreprise — contrairement à la plupart de mes amis qui se préoccupent peu du coût — ce qui m'importe avant tout, c'est le prix et la vitesse de rendu. Sur le prix, la différence est réelle, comme l'illustre le benchmark Cost per Intelligence Index Task :

À tâche d'intelligence égale, DeepSeek Flash coûte une fraction de Sonnet 4.6, Sonnet 5 ou Opus 5.
En bas de cette note, j'ai dressé une liste de benchmarks qui comparent les modèles DeepSeek Flash avec 3 jalons : Sonnet 4.6, qui me sert de référence basse en tant qu'équivalent empirique d'Opus 4.5, puis Sonnet 5 et Claude Opus 5. Les modèles DeepSeek Flash s'y positionnent très bien par rapport à ces modèles de référence.
La seule exception notable est le benchmark AA-Omniscience Index: Score :
 2.png)
Pour éviter cela, je peux utiliser Kimi K3 ou GLM-5.3 qui se débrouillent aussi bien que Sonnet 5 dans ce benchmark.
Précision tout de même, le benchmark "AA-Omniscience: Evaluating Cross-Domain Knowledge Reliability in Large Language Models" exécute ses tests sans harness permettant au LLM de vérifier ses réponses à l'aide d'un RAG (recherche sur Internet ou autre). C'est une situation plus difficile que la situation réelle. Je ne remets pas en cause ce benchmark, je le prends en compte, mais dans ma pratique quotidienne je ne pense pas être impacté, car je configure mes harness pour toujours faire des vérifications. En pratique, lors des tâches de coding, c'est le bon fonctionnement du programme qui rattrape les hallucinations du LLM ; pour mes tâches d'écriture et d'analyse, c'est ma vérification des sources qui me permet de contredire le LLM en cas d'hallucination.
Annexe : liste de benchmarks
 (11 Sep '26).png)
.png)
.png)
.png)
.png)
.png)
.png)
.png)
.png)
Ventilateur ThinkPad T14s Gen 3 : le clone AliExpress à 35 € n'a pas tenu 90 jours
Après 3 ans d’utilisation intensive de mon Thinkpad T14s AMD Gen 3, le roulement de son ventilateur a commencé à faire du bruit. C’est le genre de bruit qui me rend totalement fou.
Identification et analyse de ventilateur d'origine
Voici la pièce en question :

Sonnet 5 a réussi à lire l’étiquette et à me donner les détails :
- Fabricant : Delta Electronics Inc. (Made in China)
- Modèle :
NS85C41 - Type :
DC Brushless - Alimentation :
DC5V, 0.50A - Un code produit du type
21QG01(ou proche) et un QR code de traçabilité - Marquages de certification
UR usetEPA
Delta Electronics est l’un des plus gros fabricants mondiaux de ventilateurs pour PC portables — ils équipent notamment Lenovo, Dell, HP en OEM. C’est un type de fournisseur « premium » (avec Foxconn, AVC, Sunon).
Leurs roulements sont généralement de bonne qualité constante, avec un contrôle qualité industriel sérieux, ce qui explique que le vôtre a tenu 3 ans en usage intensif avant de commencer à faire du bruit — c’est une durée de vie tout à fait normale, voire bonne, pour ce type de composant.
J’ai découvert les types de roulements utilisés dans les ventilateurs de laptop :
Sleeve bearing (roulement à manchon/bague) Le plus basique et le moins cher : un axe qui tourne dans un manchon en bronze/laiton imprégné d’huile. Bon marché à produire, mais l’usure est progressive et le bruit apparaît vite dès que le film d’huile se dégrade (chaleur, gravité qui fait couler l’huile vers le bas sur un axe vertical/incliné). C’est typiquement ce qu’on trouve sur les clones bas de gamme.
Ball bearing (roulement à billes) Des billes métalliques dans une cage, avec beaucoup moins de friction et de dérive dans le temps. Plus cher à fabriquer (précision d’usinage des billes et des chemins de roulement), mais dure largement plus longtemps et résiste mieux à la chaleur soutenue (le CPU d’un T14s tourne facilement à 60-80°C sous charge, ce qui dégrade l’huile d’un sleeve bearing plus vite).
FDB (Fluid Dynamic Bearing) Un axe usiné en cuivre pur (tournage de précision, pas de fritté comme le sleeve bearing classique) avec des rainures hélicoïdales qui guident l’huile et créent une pression maximale au point critique de charge, ce qui soutient et centre l’axe en rotation. C’est une évolution nettement plus sophistiquée du sleeve bearing : présenté par les fabricants comme un compromis silence/durabilité supérieur au ball bearing classique. C’est ce type de roulement qu’utilise notamment Sunon dans sa gamme MagLev/Vapo.
Variantes hybrides (hydro-bearing, dual-ball, oil-impregnated + ball) Les fabricants premium (Delta, Foxconn, AVC, Sunon — ceux que Lenovo utilise en OEM) combinent souvent les deux approches ou utilisent des formulations d’huile plus stables thermiquement, avec des tolérances d’usinage bien plus serrées.
Je n’ai pas trouvé la datasheet du modèle NS85C41 ni sur https://www.delta-fan.com, ni sur https://www.alldatasheet.com. Sonnet 5 pense que ce modèle semble être une référence « custom » fabriquée spécifiquement pour Lenovo, non cataloguée publiquement chez Delta Electronics.
Étant donné le positionnement haut de gamme du segment [Thinkpad T14s AMD Gen 3] (garantie 3 ans, usage en flotte d'entreprise) — plutôt qu'en raison du fabricant, [Delta Electronics] produisant aussi bien du bas de gamme que du premium selon la commande du client — [Claude Sonnet|Sonnet 5] pense qu'il est probable que ce ventilateur utilise un roulement de type [Ball bearing], possiblement dual-ball.
Il s’agit d’une inférence basée sur des indices indirects (durée de vie observée de 3 ans, positionnement produit, marketing général du fabricant), sans confirmation documentaire directe.
Remplacement par un ventilateur Aliexpress bas de gamme
Le 11 avril 2026, j’ai commandé ce ventilateur de remplacement chez Aliexpress à 35,99 €.

Je l’ai reçu le 26 avril et j’ai consulté cette vidéo pour l’installer. L’opération a été très simple.
Malheureusement, fin juillet 2026, le ventilateur fait à nouveau du bruit ! Après seulement 90 jours d’utilisation !
J’ai contacté le vendeur sur Aliexpress mais il ne semble pas très motivé à m’envoyer un nouveau modèle de remplacement :
Hello, the loud noise from the fan may be caused by hair or foreign objects being sucked in by the fan as it rotates. Therefore, this situation is more of a probabilistic issue.
Étant donné son prix modeste et la panne survenue après seulement 90 jours — cohérent avec la faible résistance à la chaleur d’un roulement bas de gamme — Sonnet 5 suppose que ce ventilateur utilise un roulement de type Sleeve bearing.
Remplacement par un ventilateur acheté directement chez Lenovo
Ce bruit étant insupportable, j’ai cherché une solution pérenne. J’ai trouvé la section « pièces détachées » sur le site de support de Lenovo :

J’ai saisi le numéro de référence exact de mon modèle de laptop 21CQCTO1WW et j’ai trouvé les ventilateurs suivants : 5H41B77292 ou 5H41B77293.

J’ai demandé à Sonnet 5 la différence entre ces deux modèles de ventilateurs et j’ai eu la réponse suivante :
Bonne nouvelle : dans le cas présent, ce ne sont pas deux fans différents au sens fonctionnel, mais deux références FRU (Field Replaceable Unit) pour le même composant, provenant de fournisseurs différents.
Ce que disent les sources
- Le module thermique 5H41B77292 est identifié comme AT2DU001VV0, JT4C5_UMA, explicitement compatible avec votre machine : T14s Gen 3 (Type 21CQ 21CR).
- Les références 5H41B77292 / 5H41B77293 / 5H41B77294 sont systématiquement groupées ensemble par les revendeurs (Amazon, eBay, myfixguide, oemcomputerpart…) comme interchangeables pour les versions AMD du T14s Gen 3.
- Les références 5H41B77305 / 06 / 07 correspondent, elles, aux versions Intel — donc pas pertinentes pour vous si votre machine est AMD (le suffixe « UMA » dans « JT4C5_UMA » suggère un chipset graphique intégré, cohérent avec les config AMD Ryzen sans GPU dédié).
Pourquoi Lenovo a plusieurs FRU pour la même pièce
C’est une pratique standard chez Lenovo : ils multi-sourcent certains composants (ici probablement le ventilateur/dissipateur) auprès de plusieurs fabricants (Delta, Foxconn, AVC, Sunon, etc. selon les périodes de production). Le boîtier, les caractéristiques électriques (5V, 0.5A, connecteur 6 fils) et la compatibilité mécanique sont identiques — seule l’origine/le lot de fabrication change. Ce n’est pas une histoire de config UMA vs dGPU ici (le T14s Gen 3 AMD n’a pas de dGPU dédiée), donc 77292 et 77293 sont fonctionnellement équivalentes.
Étant donné que les références 5H41B77292, 5H41B77293 sont internes à Lenovo, cette fois encore, je n’ai pas accès aux datasheets 😔.
Au hasard, je vais commander le modèle 5H41B77292 et je vais bien voir si ce modèle à 52 € au lieu de 35 € est de meilleure qualité et arrivera à nouveau à durer 3 ans !
Comment "harness" s'est répandu en IA et pourquoi ce terme a été choisi
Le week-end dernier, j'ai commencé à chercher d'où venait le terme harness et pourquoi il a été choisi pour désigner ce concept dans les AI agents comme OpenCode ou Claude Code.
Cette note est le résultat de ce travail de recherche, basé sur des échanges avec Sonnet 4.6, des lectures de commentaires Hacker News et divers articles sur le sujet.
En novembre 2025, Anthropic a publié l'article « Effective Harnesses for Long-Running Agents », qui utilise explicitement « agent harness » dans le sens moderne.
Le terme « harness engineering » semble avoir été popularisé par Mitchell Hashimoto dans la section 5 de son billet publié le 5 février 2026. Il y décrit une pratique qu'il a développée au fil de son usage des agents IA :
Je ne sais pas s'il existe un terme largement accepté par l'industrie pour cela, mais j'en suis venu à appeler cela « harness engineering ». C'est l'idée que chaque fois qu'on constate qu'un agent commet une erreur, on prend le temps de concevoir une solution pour que l'agent ne commette plus jamais cette erreur. Je n'ai pas besoin d'inventer de nouveaux termes ici ; s'il en existe un autre, je m'y joindrai.
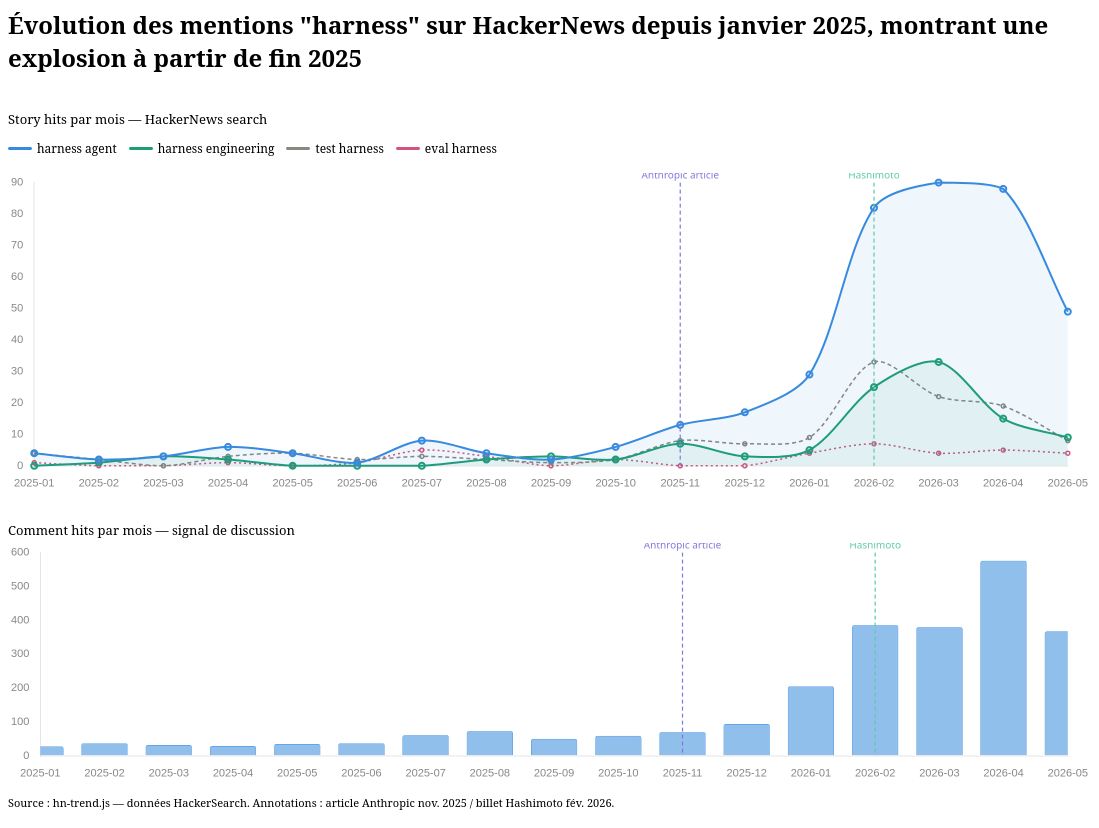 Données extraites avec hackernews-trends-poc.
Jusqu'à présent, je pensais à tort que l'analogie du harnais correspondait simplement à l'équipement qu'on pose sur un cheval, sans saisir la pertinence de ce terme, par manque de culture de cette langue. En anglais, on trouve les expressions « harness the sun » ou « harness the wind ». Voici la définition du verbe harness :
Verb
harness (third-person singular simple present harnesses, present participle harnessing, simple past and past participle harnessed)
- (transitive) To place a harness on something; to tie up or restrain. Synonym: tackle
« They harnessed the horse to the post. »- (transitive) To capture, control or put to use. « Imagine what might happen if it were possible to harness solar energy fully. »
- (transitive) To equip with armour.
Le terme français qui me semble le plus proche du verbe harness serait « canaliser » ou « dompter ».
Le terme harness désigne donc l'action de canaliser et d'orienter la puissance d'un LLM vers un objectif souhaité.
Avant l'usage du terme harness dans le domaine de l'AI — que ce soit pour agent harness, harness engineering ou LM Evaluation Harness — j'ai découvert en travaillant sur cette note qu'il était déjà utilisé en software engineering, principalement dans l'expression test harness. Il me semble que c'était d'ailleurs l'usage principal du mot dans notre domaine, bien avant qu'il ne soit repris pour les agents IA.
Les concepts que je pense avoir identifiés et que je retiens
- Le harness est un artefact à installer et configurer dans OpenCode. Il est composé de :
- Le harness engineering est le processus humain d'amélioration itérative du harness. Quand l'utilisateur observe une erreur de l'agent, il modifie ou ajoute des fichiers
AGENTS.md,SKILLS.md, des outils MCP ou des configurations pour qu'elle ne se reproduise plus. Ce terme désigne le processus, par opposition au harness qui est l'artefact. - Agent-eval-harness est un outil externe au harness permettant de lancer des sortes de tests unitaires. Il est utilisé pendant les phases de harness engineering pour valider les modifications de façon contrôlée et reproductible.
Cette note ne traite pas de la boucle agent en elle-même — j'ai documenté ce concept séparément ici :
Une application est qualifiée d'AI agent lorsqu'un LLM y prend de façon autonome des décisions en boucle pour atteindre un objectif — en appelant des tools, en consultant des sources via RAG, ou en déléguant à des sous-agents. La boucle s'arrête lorsque l'objectif est atteint ou qu'une intervention humaine est requise.
Le concept de harness vient encadrer cette boucle pour la configurer et la contraindre, mais il ne la définit pas. Comprendre la boucle aide à saisir ce qu'orchestre le harness.
Extrait d'un article de Sebastian Raschka :
Pour clarifier les concepts :
- LLM : le modèle brut de prédiction du prochain token
- Modèle de raisonnement : un LLM optimisé pour produire des traces de raisonnement intermédiaires et se vérifier davantage
- Agent : une boucle qui combine un modèle avec des outils, de la mémoire et des retours d'environnement
- Agent harness : le scaffold logiciel autour d'un agent qui gère le contexte, l'utilisation des outils, les prompts, l'état et le flux de contrôle
- Coding harness : un cas particulier d'agent harness ; un harness spécifique au génie logiciel qui gère le contexte du code, les outils, l'exécution et les retours itératifs
Quelques articles que j'ai lus avec attention :
- Effective harnesses for long-running agents — Anthropic, nov. 2025
- My AI Adoption Journey — Mitchell Hashimoto, fév. 2026
- Components of a Coding Agent — Sebastian Raschka, avr. 2026
En explorant le sujet de harness, je constate que, comme beaucoup de concepts, sa définition peut varier selon les sources et les communautés. Par exemple, l'article Components of a Coding Agent de Sebastian Raschka semble en proposer une définition plus large que Mitchell Hashimoto.
Pour le moment, je souhaite adopter la version de Mitchell Hashimoto, que j'arrive mieux à appréhender et dont je parviens mieux à délimiter le périmètre : un dispositif qui canalise la fougue du LLM, comme le harnais canalise le cheval sauvage.
J'ai découvert MimiMax M2.7, qui semble équivalent à GLM-5 pour un tiers du prix
#JaiDécouvert la sortie de MiniMax M2.7 le 18 mars 2026 : https://www.minimax.io/news/minimax-m27-en.
Pour donner du contexte, j'utilise depuis le 12 mars 2026 les modèles GLM-5, Kimi K2.5 et MiniMax M2.5 via l'offre OpenCode Go. Je n'ai pas comparé rigoureusement ces modèles avec Sonnet 4.6 et Opus 4.6, mais pour le moment, je suis satisfait de ces modèles. J'ai même l'impression que MiniMax M2.5, le moins cher, suffit pour la majorité de mes besoins.
J'ai lu l'article "MiniMax M2.7 Review: Is It Worth the Hype?", mais c'est finalement MiniMax M2.7: Everything you need to know qui m'a été le plus utile, voici sa traduction :
MiniMax a publié MiniMax-M2.7, offrant une intelligence de niveau GLM-5 pour moins d'un tiers du coût
MiniMax-M2.7 de @MiniMax_AI obtient un score de 50 sur l'Artificial Analysis Intelligence Index, une amélioration de 8 points par rapport à MiniMax-M2.5, publié il y a un mois. Cette amélioration est portée par une performance améliorée sur les tâches agentiques du monde réel et une réduction des hallucinations. MiniMax-M2.7 est désormais devant MiMo-V2-Pro (Reasoning, 49) et Kimi K2.5 (Reasoning, 47), et équivalent à GLM-5 (Reasoning, 50) tout en utilisant 20% de tokens de sortie en moins et coûtant moins d'un tiers du prix pour fonctionner. MiniMax-M2.7 est un modèle uniquement raisonnement et maintient le même prix par token que MiniMax-M2.5.
Points clés :
➤ Performance solide sur les tâches agentiques du monde réel : MiniMax-M2.7 atteint un Elo GDPval-AA de 1494, une amélioration significative par rapport à MiniMax-M2.5 (1203) et devant MiMo-V2-Pro (Reasoning, 1426), GLM-5 (Reasoning, 1406) et Kimi K2.5 (Reasoning, 1283). Il reste derrière les modèles de pointe tels que GPT-5.4 (xhigh, 1667) et Claude Opus 4.6 (Adaptive Reasoning, max effort, 1606).
- Réduction des hallucinations : MiniMax-M2.7 obtient un score de +1 sur l'AA-Omniscience Index, contre -40 pour MiniMax-M2.5. Cela le place en compétition avec GPT-5.2 (xhigh, -1) et GLM-5 (Reasoning, +2), et bien devant Kimi K2.5 (Reasoning, -8). L'amélioration par rapport à M2.5 est entièrement due à la réduction des hallucinations, ce qui signifie que le modèle est plus susceptible de s'abstenir de répondre lorsqu'il ne connaît pas la réponse, plutôt que de deviner. M2.7 atteint un taux d'hallucination de 34%, inférieur à Claude Sonnet 4.6 (Adaptive Reasoning, max effort, 46%) et Gemini 3.1 Pro Preview (50%).
- Gains sur la plupart des évaluations par rapport à MiniMax-M2.5 : En dehors des améliorations du GDPval-AA et de l'AA-Omniscience notées ci-dessus, MiniMax-M2.7 progresse en HLE (+9 p.p.), TerminalBench Hard (+5 p.p.), SciCode (+4 p.p.), IFBench (+4 p.p.), GPQA (+3 p.p.) et LCR (+3 p.p.). Nous avons constaté une régression notable en τ²-Bench (-11 p.p.).>
- Utilisation accrue de tokens : MiniMax-M2.7 a utilisé environ 87M tokens de sortie pour exécuter l'Artificial Analysis Intelligence Index, en hausse de 55% par rapport à MiniMax-M2.5 (environ 56M). Il reste plus efficace en tokens que d'autres modèles tels que GLM-5 (Reasoning, 110M) et Kimi K2.5 (Reasoning, environ 89M).
- Rentabilité de pointe : MiniMax-M2.7 a coûté 176 $ pour exécuter l'Artificial Analysis Intelligence Index, maintenant le même prix de 0,30 $/1,20 $ par million de tokens d'entrée/sortie que M2.5. Cela le place sur la frontière de Pareto de notre graphique Intelligence vs. Coût. À titre de référence, GLM-5 (Reasoning) a coûté 547 $ à intelligence équivalente, Kimi K2.5 (Reasoning) 371 $, et Gemini 3 Flash Preview (Reasoning) 278 $.
Détails clés du modèle :
- Fenêtre de contexte : 200K tokens (équivalent à MiniMax-M2.5).
- Tarification : 0,30 $/1,20 $ par million de tokens d'entrée/sortie (inchangé par rapport à MiniMax-M2.5).
- Disponibilité : API propriétaire MiniMax uniquement.
- Modalité : Entrée et sortie de texte uniquement (pas de multimodalité).
- Licence : MiniMax n'a pas annoncé si MiniMax-M2.7 sera en open weights. MiniMax-M2.5 est disponible sous licence MIT.
MiniMax M2.7 a été intégré dans l'offre OpenCode Go, par conséquent, je vais tester ce modèle dans mes projets OpenCode.
Cette note est la suite de la note "J'ai créé fedora-rpm-copr-playground pour apprendre à publier des packages RPM sur Fedora COPR" :
Pour être tout à fait transparent, en rédigeant cette note, j'ai découvert les méthodes tito et Packit.
Je compte mettre à jour
stephane-klein/fedora-rpm-copr-playgroundpour les tester et ensuite publier une nouvelle note de compte rendu.
Voici ce que Claude Sonnet 4.6 m'a appris au sujet des méthodes Tito et Packit :
Tito (~2008) est issu de l'équipe Red Hat Network / Spacewalk. C'est un outil local de gestion du cycle de vie RPM : il gère le tagging Git (
tito tag), incrémente la version dans le.spec, génère automatiquement les changelogs depuis l'historique Git et produit des SRPMs. Ce sont des opérations que le développeur invoque manuellement sur sa workstation, avant de committer et pousser son travail.Packit (~2019) est un projet Red Hat conçu pour l'ère CI/CD GitHub/GitLab. Son rôle est d'orchestrer automatiquement les builds RPM (via COPR), et optionnellement les soumissions Koji et les updates Bodhi pour les projets intégrés à la distribution officielle Fedora, en réaction à des événements upstream (push, PR, release, ou création d'un tag). Il peut également mettre à jour le changelog à partir des commits, mais cette opération intervient au moment où il prépare la mise à jour vers le dist-git Fedora — non pas comme étape explicite du workflow local du développeur.
La différence fondamentale entre les deux n'est donc pas tant dans quand le build est déclenché — les deux peuvent travailler sur tag — que dans comment le workflow de tagging est géré : avec Tito, c'est le développeur qui crée le tag depuis sa workstation, alors que Packit suppose que le tag existe déjà et déclenche automatiquement le build sur l'infrastructure Fedora (Copr, Koji ou Bodhi selon la configuration) à sa création ou à tout autre événement upstream configuré.
Les deux sont des projets Red Hat gravitant autour de l'écosystème Fedora/RPM, sans que l'un soit le successeur de l'autre. Tito lui-même recommande aujourd'hui Packit pour automatiser les Bodhi updates. Beaucoup de projets Fedora les utilisent d'ailleurs conjointement : Tito pour gérer le versioning et le tagging en local, Packit pour automatiser la distribution en aval.
J'ai intégré Packit à fedora-rpm-copr-playground, dans la branche bash-packit.
Avant de pouvoir utiliser Packit pour build un package RPM d'un projet qui se trouve dans un repository GitHub, il est nécessaire de suivre un certain nombre d'étapes détaillées dans le "Packit Upstream Onboarding Guide" :
- Activer l'application GitHub nommée "Packit-as-a-Service" : https://packit.dev/docs/guide/#github
- Ensuite suivre l'étape "Approval" — j'ai perdu du temps dans le playground parce que j'étais totalement passé à côté de cette étape : https://packit.dev/docs/guide/#2-approval
Voici l'issue GitHub qui a permis l'approbation de mon compte : https://github.com/packit/notifications/issues/716 - Créer un projet COPR et ajouter des permissions "admin" à "packit" (voir ligne 18).
J'ai automatisé cette étape avec le script
/init-copr-project.sh.
Ensuite, j'ai intégré le fichier /.packit.yaml à la racine de mon playground, avec le contenu suivant :
specfile_path: rpm/hello-bash.spec

upstream_package_name: hello-bash
downstream_package_name: hello-bash
upstream_tag_template: "v{version}"

actions:
  create-archive:
    - bash rpm/create-archive.sh

jobs:
  - job: copr_build
    trigger: release
    owner: stephaneklein
    project: hello-bash-packit
    targets:
      - fedora-42
      - fedora-43
      - fedora-44
    preserve_project: true
Je ne vais pas détailler ici le contenu de ce fichier, je vous renvoie vers la documentation officielle :
La configuration trigger: release dans .packit.yaml signifie qu'il faut créer une release GitHub pour obtenir un package. Pour cela j'utilise de script /release.sh qui exécute :
gh release create "$VERSION" --title "Release $VERSION" --generate-notes
Une fois la commande suivante exécutée :
$ ./release.sh v1.0.15
L'exécution du job de génération du package SRPM est visible sur le backend Packit à cette adresse : https://dashboard.packit.dev/jobs/srpm
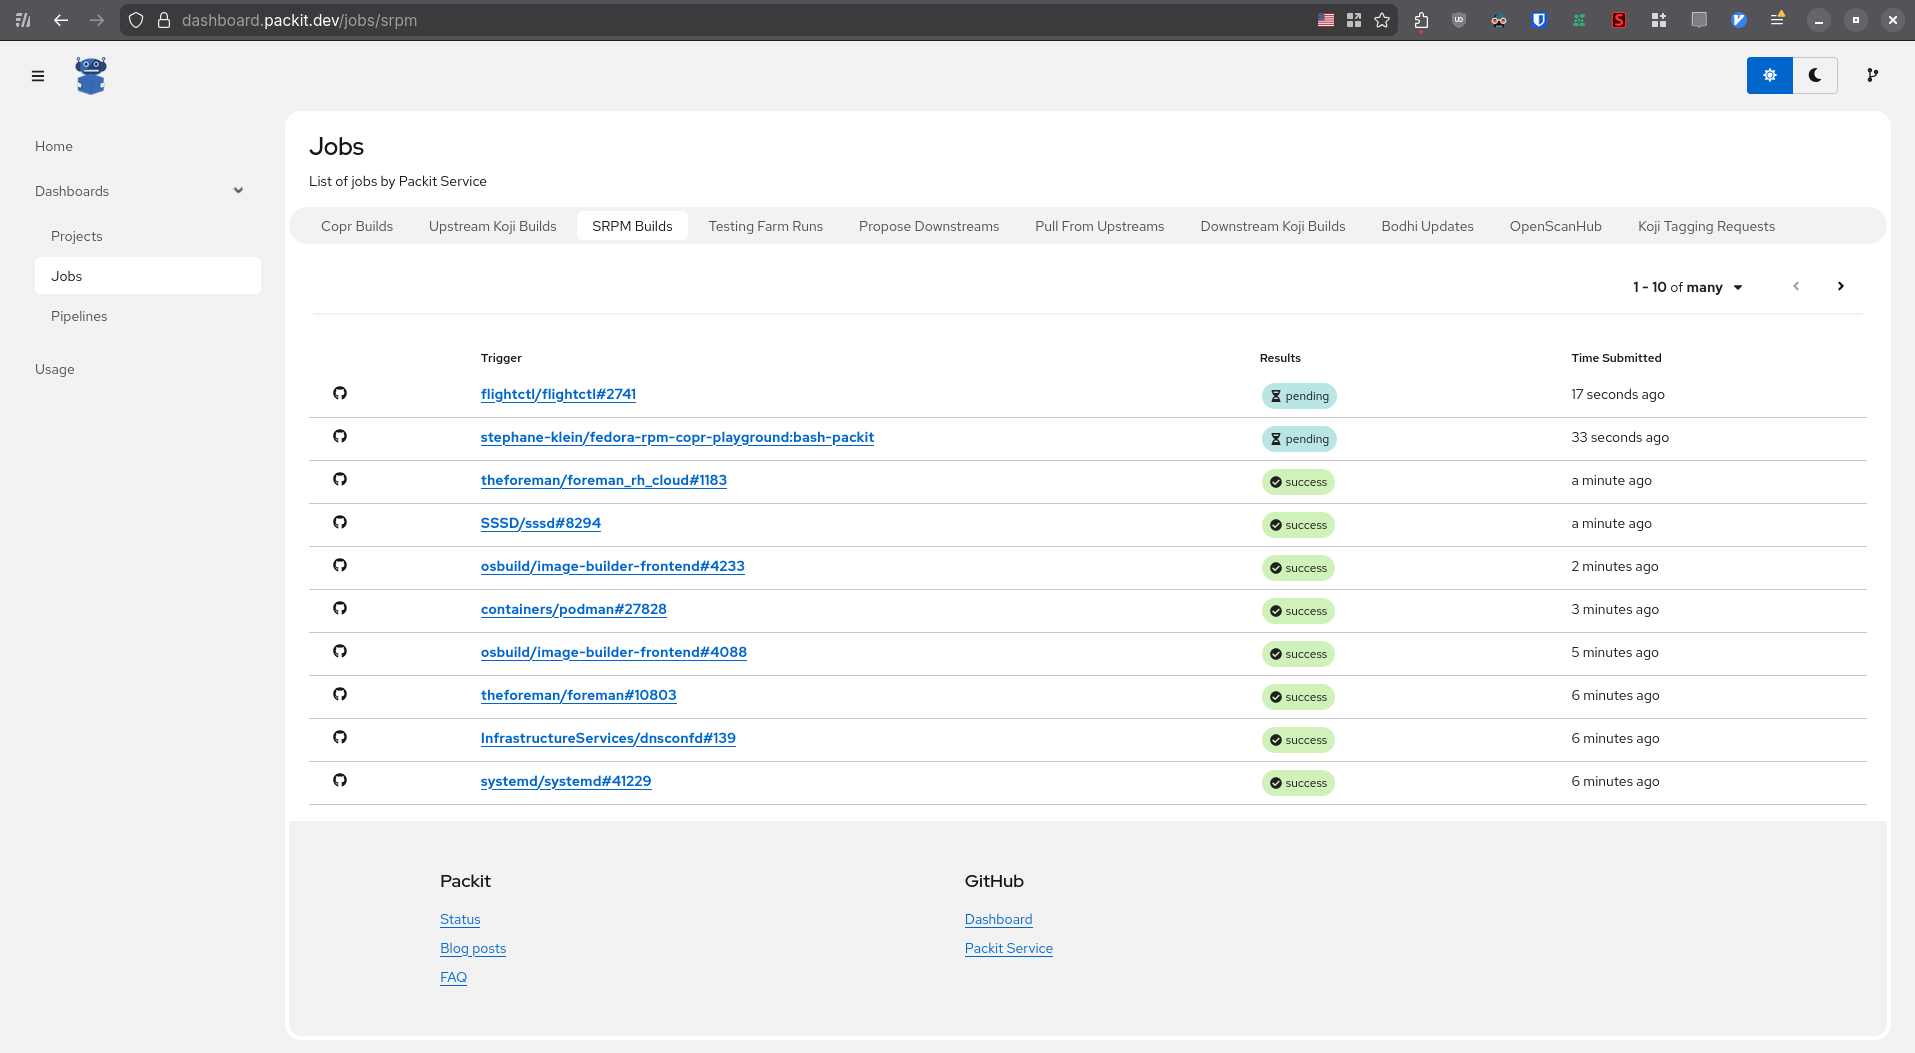
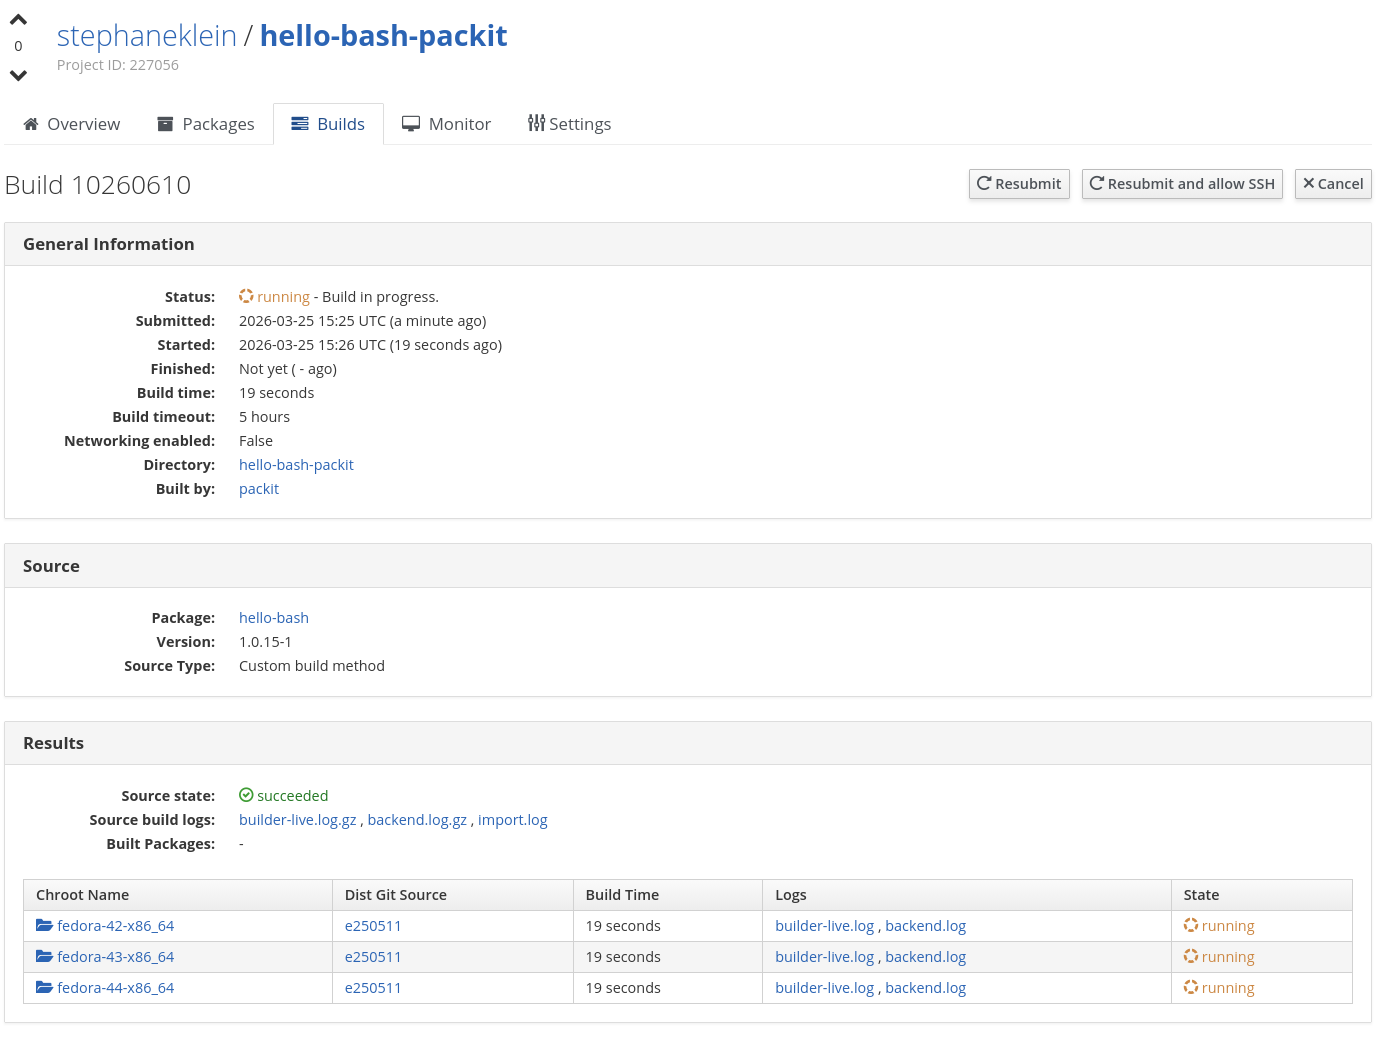
Une fois ce job terminé, c'est ensuite le backend COPR qui s'occupe de construire les packages RPM pour toutes les distributions indiquées dans le fichier .packit.yaml :
En conclusion, j'ai réussi à configurer Packit pour construire mes packages RPM. Cependant, la configuration est plus complexe que la méthode make_srpm. Selon moi, Packit est à utiliser pour les packages destinés à être intégrés officiellement à Fedora, tandis que make_srpm convient mieux pour les autres.
J'ai créé fedora-rpm-copr-playground pour apprendre à publier des packages RPM sur Fedora COPR
Introduction
Après trois ans à repousser ce projet, je me suis enfin lancé en janvier 2026 dans la création de paquets RPM pour Fedora COPR.
J'ai créé et publié les packages aichat-git (repository) et text-to-audio (repository). L'expérience a été beaucoup plus simple et rapide que je le pensais. Les agents IA simplifient certes ce genre de tâche, mais même sans eux, le code reste plutôt minimaliste.
Pourquoi est-ce que je me suis intéressé à ce sujet ? Au départ, c'était pour distribuer qemu-compose sous forme de package RPM (voir issue).
Pour bien maîtriser ces opérations, la semaine dernière, je suis reparti de zéro et j'ai implémenté et publié le playground : fedora-rpm-copr-playground. Voici les objectifs de ce playground :
- Générer un package pour distribuer un simple script Bash qui affiche un "Hello world" (dans la branche
bash). - Générer un package pour distribuer une application Golang qui affiche un "Hello world" (dans la branche
golang)
Pour chacun de ces packages, j'ai testé trois méthodes de build :
- build du package RPM 100% local
- build du package SRPM en local, puis upload sur Fedora COPR qui génère les RPM pour plusieurs plateformes et architectures (x86_64, aarch64, etc.)
- une méthode basée à 100% sur Fedora COPR à partir des sources d'un dépôt GitHub, déclenchée automatiquement par un script GitHub Actions
Cette note documente ce playground et rassemble les difficultés que j'ai rencontrées. Le README.md reste consultable si vous préférez suivre un exemple pas à pas.
Le fichier .spec
Le point central pour créer un package RPM est le fichier .spec /rpm/hello-bash.spec :
#
Name:           hello-bash
Version:        1.0.7
Release:        1%{?dist}
Summary:        A simple Hello World bash script

License:        MIT
URL:            https://github.com/stephane-klein/fedora-rpm-copr-playground
Source0:        hello-bash

BuildArch:      noarch

%description
A simple "Hello World" Bash script packaged as an RPM for Fedora COPR.

%prep
# Nothing to prepare, source is ready

%build
# Nothing to build, it's a bash script

%install
mkdir -p %{buildroot}/%{_bindir}
cp %{SOURCE0} %{buildroot}/%{_bindir}/hello-bash
chmod 755 %{buildroot}/%{_bindir}/hello-bash

%files
%{_bindir}/hello-bash

%changelog
* Thu Mar 19 2026 Stéphane Klein <contact@stephane-klein.info> - 1.0.0-1
- Initial release
Les lignes importantes dans ce fichier :
BuildArch: noarch, étant donnée que c'est un simple script, ce package n'est pas dépendant de l'architecture (processeur).- La section
%install - La section
%files
La syntaxe du format .spec peut sembler étrange en 2026. Elle date de 1995 — avant même l'existence de YAML (2001) et JSON (1999). Cette ancienneté explique les %... et %{...} qui peuvent paraitre cryptiques aujourd'hui.
Historiquement, le champ Source0 pointe vers une archive (généralement un tar.gz), contenant les sources du projet. Pour des cas simples, comme ici avec le script Bash, Source0 peut directement référencer le fichier source.
J'ai aussi implémenté une variante bash-multifiles dans le playground, pour tester le packaging de plusieurs scripts accompagnés d'un fichier de documentation. J'y indique les fichiers via Source0:, Source1:, Source2:, puis je les copie dans %install avec %{SOURCE0}, %{SOURCE1}, %{SOURCE2}. Cela fonctionne correctement, bien qu'au-delà de trois ou quatre fichiers, je pense qu'il soit probablement plus pratique d'utiliser une archive.
Build local du package RPM
Le script /build.sh suivant permet de générer un package RPM :
#!/bin/bash
set -e

TOPDIR="$(pwd)/rpmbuild"

mkdir -p "$TOPDIR"/{BUILD,RPMS,SRPMS,SOURCES,SPECS}

echo "Copying source to SOURCES..."
cp hello-bash "$TOPDIR/SOURCES/"

echo "Building RPM..."
rpmbuild --define "_topdir $TOPDIR" -ba rpm/hello-bash.spec

echo ""
echo "Build complete!"
echo "RPM: $TOPDIR/RPMS/noarch/"
Il commence par préparer la structure de dossier suivante :
/rpmbuild/
├── BUILD
├── RPMS
├── SOURCES
├── SPECS
└── SRPMS
Ensuite les fichiers à packager sont copiés dans rpmbuild/SOURCES
/rpmbuild/
├── BUILD
├── RPMS
├── SOURCES
│   ├── hello-bash
├── SPECS
└── SRPMS
Pour finir, la commande rpmbuild --define "_topdir $TOPDIR" -ba rpm/hello-bash.spec génère à la fois le package SRPM (source RPM) et le RPM binaire. L'option -ba signifie "build all". Pour générer uniquement le SRPM, il faudrait utiliser -bs (build source). Ici, comme le package contient un script Bash, il est de type noarch :
/rpmbuild/
├── BUILD
├── RPMS
│   └── noarch
│       └── hello-bash-1.0.7-1.fc42.noarch.rpm
├── SOURCES
│   ├── hello-bash
├── SPECS
└── SRPMS
    └── hello-bash-1.0.7-1.fc42.src.rpm
Publication sur Fedora COPR
Le playground contient un second script qui permet de publier le package sur Fedora COPR, ce qui permet de rendre accessible publiquement son package.
Voici comment cette méthode fonctionne. Tout d'abord, il faut créer un compte et un projet sur Fedora COPR. Dans le playground, j'ai implémenté le script init-copr-project.sh basé sur copr-cli, qui me permet d'automatiser la création du projet (paradigme GitOps).
$ copr-cli create "hello-bash" \
    --description "A simple Hello World Bash script packaged as an RPM (auto-build on tags)" \
    --chroot fedora-42-x86_64 \
    --chroot fedora-43-x86_64 \
    --chroot fedora-44-x86_64
Dans cet exemple, je demande à COPR de builder les packages du projet pour les distributions fedora-42-x86_64, fedora-43-x86_64, fedora-44-x86_64.
Après avoir configuré le projet COPR, je lance le script /build-copr.sh qui exécute :
copr-cli build "hello-bash" /rpmbuild/SRPMS/hello-bash-1.0.6-1.fc42.src.rpm
Le premier paramètre "hello-bash" est le nom du projet et le second est le package source SRPM préalablement construit localement par le script /build.sh.
Voici ce que donne l'exécution de ./build-copr.sh côté cli :
$ ./build-copr.sh

...

Build complete!
RPM: /home/stephane/git/github.com/stephane-klein/fedora-rpm-copr-playground/.worktree/bash/rpmbuild/RPMS/noarch/
Uploading package ./rpmbuild/SRPMS/hello-bash-1.0.6-1.fc42.src.rpm
 |################################| 8.5 kB 47.1 kB/s eta 0:00:00
Build was added to hello-bash:
  https://copr.fedorainfracloud.org/coprs/build/10252699
Created builds: 10252699
Watching build(s): (this may be safely interrupted)
  08:59:15 Build 10252699: pending
  08:59:45 Build 10252699: running
  09:00:15 Build 10252699: starting
  09:00:46 Build 10252699: running
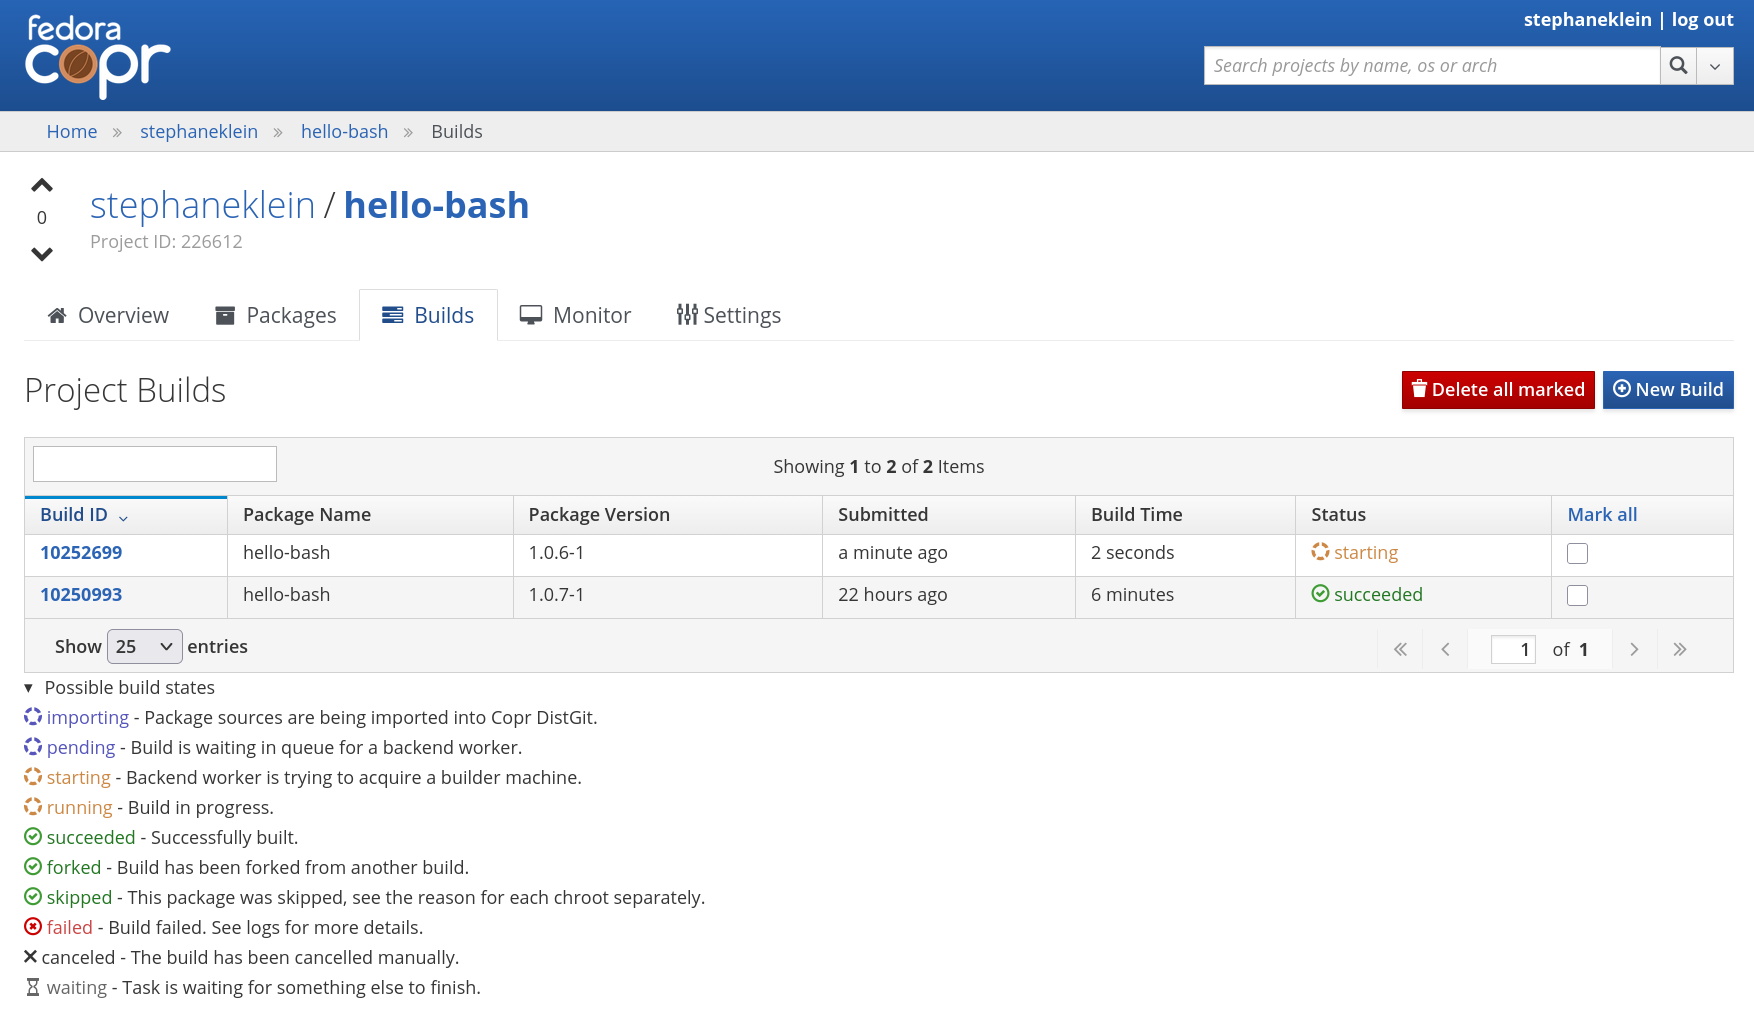
Voici ce qui est visible sur l'interface web de COPR, https://copr.fedorainfracloud.org/coprs/stephaneklein/hello-bash/builds/ :
Une fois le build des packages terminé, il est facile d'installer le package avec les commandes suivantes :
$ sudo dnf copr enable -y stephaneklein/hello-bash
$ sudo dnf install -y hello-bash
$ hello-bash
Hello World
Automatisation GitOps avec COPR
Et pour finir, j'ai implémenté dans le playground l'automatisation complète de la compilation et publication des packages sur l'infrastructure COPR.
Pour cela, dans le script init-copr-project.sh j'ai déclaré l'URL du repository qui contient le code source :
...

copr-cli add-package-scm "$COPR_PROJECT" \
    --name hello-bash \
    --clone-url https://github.com/stephane-klein/fedora-rpm-copr-playground.git \
    --commit bash \
    --subdir . \
    --spec rpm/hello-bash.spec \
    --type git \
    --method make_srpm \
    --webhook-rebuild on
Le paramètre --commit bash permet de définir la branche Git à utiliser comme source.
Le paramètre --method make_srpm, qui permet à l'utilisateur d'utiliser un script personnalisé de génération du SRPM, à placer dans /.copr/Makefile à la racine du dépôt avec une cible srpm, exemple :
specfile = rpm/hello-bash.spec

.PHONY: srpm
srpm: $(specfile)
	mkdir -p /tmp/copr-srpm-build
	cp rpm/hello-bash.spec /tmp/copr-srpm-build/hello-bash.spec
	cp -r . /tmp/copr-srpm-build/source/
	cd /tmp/copr-srpm-build && \
		rpmbuild -bs hello-bash.spec \
			--define "_topdir /tmp/copr-srpm-build/rpmbuild" \
			--define "dist .fc42" \
			--define "_sourcedir /tmp/copr-srpm-build/source"
	cp /tmp/copr-srpm-build/rpmbuild/SRPMS/*.src.rpm $(outdir)
Je ne souhaite pas détailler ici d'autres méthodes comme tito ou Packit, mais la méthode make_srpm est la plus flexible, elle permet de contrôler entièrement comment le SRPM est construit.
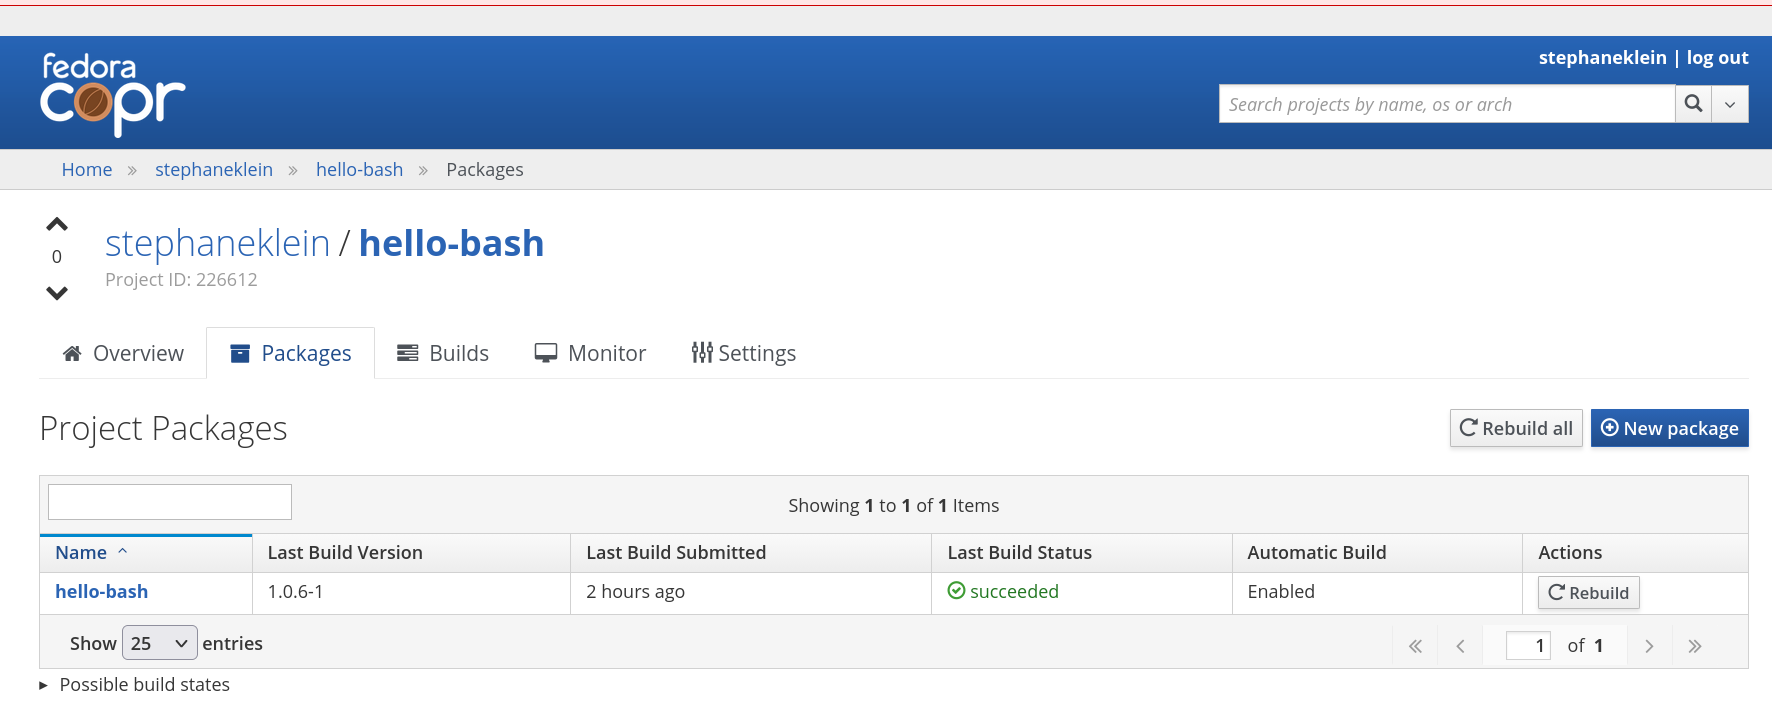
Une fois tout ceci configuré, il est possible de rebuild le package directement en cliquant sur le bouton "Rebuild" sur l'interface web de COPR :
Dernière étape : j'ai implémenté un build automatique qui est déclenchée par un appel curl dans le job GitHub Actions /.github/workflows/trigger-copr-build.yml, dont voici le contenu :
name: Trigger Copr Build

on:
  push:
    tags:
      - '*'

jobs:
  trigger-copr-build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0

      - name: Verify tag is on bash branch
        run: |
          if ! git branch -r --contains ${{ github.ref_name }} | grep -q "origin/bash"; then
            echo "Tag ${{ github.ref_name }} is not on branch bash"
            exit 1
          fi

      - name: Trigger Copr webhook
        run: |
          curl -X POST https://copr.fedorainfracloud.org/webhooks/custom/226325/3cf20247-820b-4050-bfb1-593b01a6996f/hello-bash/
Ce job est exécuté à chaque publication d'un nouveau Git tag, suivi d'une vérification que le tag provient bien de la branche bash.
Claude Sonnet 4.6 m'a suggéré l'existence d'une méthode de polling de dépôt Git intégrée à COPR, mais je n'ai trouvé aucune trace de celle-ci dans la documentation.
J'ai aussi essayé d'utiliser la méthode basée sur les webhooks GitHub de COPR, mais je n'ai pas réussi à la faire fonctionner. L'interface de GitHub m'indiquait à chaque fois une erreur dans la réponse des calls HTTP. C'est pour cela que j'ai fini par déclencher le webhook custom via un job GitHub Actions.
Package d'un projet en Golang
Le playground contient aussi le packaging d'une application en Golang, consultable dans la branche golang.
Voici le contenu du fichier /golang/rpm/hello-golang.spec :
Name:           hello-golang
Version:        1.0.10
Release:        1%{?dist}
Summary:        A simple Hello World Go application

License:        MIT
URL:            https://github.com/stephane-klein/fedora-rpm-copr-playground
Source0:        %{name}-%{version}.tar.gz

BuildRequires:  golang >= 1.21

%description
A simple "Hello World" Go application packaged as an RPM for Fedora COPR.

%prep
%autosetup

%build
go build -ldflags "-X main.version=%{version}" -o %{name}

%install
mkdir -p %{buildroot}%{_bindir}
cp %{name} %{buildroot}%{_bindir}/

%files
%{_bindir}/%{name}

%changelog
* Fri Mar 20 2026 Stéphane Klein <contact@stephane-klein.info> - 1.0.0-1
- Initial release
Les principales différences avec la version pour Bash :
- Absence de
BuildArch: noarch - Présence de
BuildRequires: golang >= 1.21 - Et l'ajout des instructions suivantes :
%prep
%autosetup

%build
go build -ldflags "-X main.version=%{version}" -o %{name}
Peu de changement au niveau du script /build-rpm-locally.sh, qui génère ces fichiers :
rpmbuild
├── BUILD
├── RPMS
│   └── x86_64
│       ├── hello-golang-1.0.10-1.fc42.x86_64.rpm
│       ├── hello-golang-debuginfo-1.0.10-1.fc42.x86_64.rpm
│       └── hello-golang-debugsource-1.0.10-1.fc42.x86_64.rpm
├── SOURCES
│   ├── hello-golang-1.0.10
│   │   ├── go.mod
│   │   └── main.go
│   └── hello-golang-1.0.10.tar.gz
├── SPECS
└── SRPMS
    └── hello-golang-1.0.10-1.fc42.src.rpm
Cette fois, plus rien dans le dossier RPMS/noarch/, la commande rpmbuild --define "_topdir $TOPDIR" -ba rpm/hello-golang.spec build le package pour la distribution de la workstation du développeur.
Pour le reste, je n'ai pas identifié de différence majeure entre la version Bash et la version Golang
La suite… méthode Tito et Packit
Pour être tout à fait transparent, en rédigeant cette note, j'ai découvert les méthodes tito et Packit.
Je compte mettre à jour stephane-klein/fedora-rpm-copr-playground pour les tester et ensuite publier une nouvelle note de compte rendu.
Je découvre l'offre "Go" de OpenCode, « Go - Modèles de code à faible coût pour tous », qui semble être sortie le 25 février 2026 : https://xcancel.com/opencode/status/2026553685468135886.
Je n'ai rien trouvé à ce sujet sur Hacker News ni chez Simon Willison.
D'après ce que je comprends, alors que l'offre OpenCode Zen propose un point d'accès et une facturation unifiés du type Pay-As-You-Go, comme OpenRouter, OpenCode Go est une offre d'abonnement à 10 dollars par mois, selon les mêmes principes que les plans d'abonnement comme Anthropic Claude Pro, Max, etc.
L'offre OpenCode Go propose un accès uniquement à 3 LLMs, tous Open Weights et tous chinois : GLM-5, Kimi K2.5 et MiniMax M2.5.
À noter toutefois que OpenCode Go n'utilise aucun AI provider basé en Chine :
Privacy : The plan is designed primarily for international users, with models hosted in the US, EU, and Singapore for stable global access.
Contrairement à Anthropic (voir Est-ce qu'un abonnement Claude est réellement plus économique qu'un accès direct via l'API ?), OpenCode semble être transparent sur leur offre :
Usage limits
OpenCode Go includes the following limits:
- 5 hour limit — $12 of usage
- Weekly limit — $30 of usage
- Monthly limit — $60 of usage
Limits are defined in dollar value. This means your actual request count depends on the model you use. Cheaper models like MiniMax M2.5 allow for more requests, while higher-cost models like GLM-5 allow for fewer.
The table below provides an estimated request count based on typical Go usage patterns:
GLM-5 Kimi K2.5 MiniMax M2.5 requests per 5 hour 1,150 1,850 20,000 requests per week 2,880 4,630 50,000 requests per month 5,750 9,250 100,000 Estimates are based on observed average request patterns:
- GLM-5 — 700 input, 52,000 cached, 150 output tokens per request
- Kimi K2.5 — 870 input, 55,000 cached, 200 output tokens per request
- MiniMax M2.5 — 300 input, 55,000 cached, 125 output tokens per request
You can track your current usage in the console.
Comparaison des prix au million de tokens des plans Claude Max et OpenCode Go
Si je pars des prix listés sur l'offre OpenCode Zen et les prix de Sonnet 4.6 chez Anthropic, je peux dresser le tableau suivant, prix exprimé en millions de tokens :
| Model | Input | Output | Cached Read | Cached Write |
|---|---|---|---|---|
| MiniMax M2.5 | $0.30 | $1.20 | $0.06 | $0.375 |
| GLM 5 | $1.00 | $3.20 | $0.20 | - |
| Kimi K2.5 | $0.60 | $3.00 | $0.10 | - |
| Sonnet 4.6 | $3.00 | $15.00 | $0.30 | $3.75 |
Ensuite, j'ajuste ces prix avec les réductions offertes :
- par le plan Claude Max à $100 / mois, soit une réduction de 92,56 % (
(1345 - 100) / 1345 × 100 = 92,56 %) - par OpenCode Go, soit une réduction de 83,33 % (
(60 - 10) / 60 × 100 = 83,33 %)
Cela donne :
| Model | Input | Output | Cached Read | Cached Write |
|---|---|---|---|---|
| MiniMax M2.5 (avec offre Go) | $0.05 | $0.20 | $0.01 | $0.06 |
| GLM 5 (avec offre Go) | $0.16 | $0.53 | $0.03 | - |
| Kimi K2.5 (avec offre Go) | $0.10 | $0.50 | $0.01 | - |
| Sonnet 4.6 (avec offre Max) | $0.22 | $1.11 | $0.02 | $0.27 |
Sur la base du leaderboard SWE-bench Verified, je vais partir des hypothèses suivantes :
- Si je considère arbitrairement que GLM-5 est équivalent à Sonnet 4.6, alors l'offre OpenCode Go est légèrement moins cher que l'offre Claude Max
- Si je considère arbitrairement que Kimi K2.5 est équivalent à Sonnet 4.6, alors l'offre OpenCode Go est deux fois moins cher que l'offre Claude Max
#JaiDécidé de tester l'offre OpenCode Go sur un projet d'outil d'archivage à froid de conversations Mattermost en Golang que je coderai from scratch. Je compte réaliser deux versions de ce projet en parallèle : une version avec Sonnet 4.6 et l'autre avec les modèles de OpenCode Go.
Journal du jeudi 12 mars 2026 à 11:18
En étudiant l'offre OpenCode Go, je suis tombé sur une page marketing du service ApiYi : « Is the OpenCode GO Plan Worth Buying? $10/Month 3 Model Tests + 5 Major Alternative Solutions Compared ».
En analysant le contenu avec Sonnet 4.6, j'ai compris qu'ApiYi fonctionne vraisemblablement comme une solution de contournement à destination du marché chinois : les utilisateurs qui ne peuvent pas acheter directement auprès d'Anthropic — en raison des risques de bannissement liés aux adresses IP et aux moyens de paiement chinois — y trouvent un accès indirect aux modèles.
Journal du jeudi 12 mars 2026 à 00:51
J'ai regroupé dans cette note les feedbacks que j'ai reçus à propos de ma note « Ma cartographie de l'écosystème LLM de 2026 ». En principe, je considère que mes notes éphémères sont immuables, mais je vais cette fois me permettre d'y apporter quelques corrections et d'en tracer les changements dans la présente note.
Généralement le grand public accède aux AI providers via leurs agents conversationnels web — ChatGPT, Claude, Le Chat, etc.
Les développeurs connectent leurs applications aux LLMs en passant par une Web API qui respecte généralement la convention OpenAI Chat Completions compatible API.
Un ami m'a dit : « Plus personne ne fait de "completion", on migre tous vers la Responses API. »
Jusqu'à présent, je ne m'étais jamais vraiment penché sur les spécifications d'API des AI providers. Je m'étais contenté d'utiliser des bibliothèques IA et des AI Frameworks, en supposant naïvement qu'des outils comme Aider, llm (cli), Open WebUI ou OpenCode s'appuyaient tous sur l'OpenAI Chat Completions compatible API, et que les nouvelles fonctionnalités — tools, prompt caching, etc. — s'intégraient simplement via de nouveaux champs dans le JSON. Après analyse, ce n'est pas le cas.
L'API "completions" est d'ailleurs désormais classée dans la section « Legacy » de la documentation d'OpenAI, et OpenAI cherche à imposer un nouveau standard avec Open Responses.
La lecture de l'article OpenAI Responses API vs. Chat Completions vs. Messages API confirme que trois formats d'API dominent aujourd'hui :
Today, three API formats dominate how AI Agents talk to LLMs:
- OpenAI's Chat Completions API — the de facto standard, universally supported
- OpenAI's Responses API — the newer, agent-oriented evolution with built-in tools and state management
- Anthropic's Messages API — Claude's native interface, with capabilities like extended thinking and prompt caching
Mistral AI, de son côté, semble encore s'appuyer sur l'OpenAI Chat Completions compatible API : son endpoint reste POST /v1/chat/completions.
Je comprends mieux maintenant, pourquoi des frameworks comme l'AI SDK proposent une implémentation par provider : chaque API diverge suffisamment pour nécessiter un adaptateur dédié 😯.
Je constate que OpenRouter proposes les trois API :
POST https://openrouter.ai/api/v1/chat/completions(lien vers la documentation)POST https://openrouter.ai/api/v1/responses(lien vers la documentation)POST https://openrouter.ai/api/v1/messages(lien vers la documentation)
C'est là l'un des intérêts d'OpenRouter : une abstraction unifiée au-dessus d'une multitude d'AI providers.
Voici la nouvelle version de mon paragraphe :
Généralement le grand public accède aux AI providers via leurs agents conversationnels web — ChatGPT, Claude, Le Chat, etc.
Les développeurs, eux, connectent leurs applications aux AI provider via une Web API : ces APIs respectaient initialement la convention OpenAI Chat Completions compatible API, mais les APIs ont progressivement divergé.
OpenAI cherche à imposer un standard commun avec Open Responses, tandis qu'Anthropic suit sa propre voie avec sa Messages API.
Mon ami m'a aussi fait remarquer :
« Tu utilises interchangeablement "LLM" et "le produit". Dans "De nombreux LLMs permettent de configurer des tools qui permettent au modèle d'appeler des fonctions externes", c'est pas le LLM lui-même, c'est le wrapper autour qui fait ça — le LLM s'en fiche. »
J'avais en effet manqué de rigueur à plusieurs endroits ; j'ai corrigé ma note.
Autre retour :
Dans ton histoire de middle tu peux aussi parler de prompt répétition : Prompt Repetition Improves Non-Reasoning LLMs.
Je ne connaissais pas cette astuce. J'ai ajouté cette phrase dans ma note :
« Jusqu'en 2025, répéter le prompt améliorait les résultats sur les modèles non-raisonnants. La question reste ouverte pour les LLMs de début 2026 : aucune étude publiée ne le confirme ni ne l'infirme à ce jour. »
Autre retour :
« Tes notes sur le prompt caching pourraient être plus précises. C'est utile pour plus de cas, mais il ne faut pas vraiment y penser comme à un cache software. »
En effet, je vois un autre usage évident : une application métier qui envoie de nombreuses requêtes différentes partageant toutes le même long system prompt. Plutôt que de retraiter ces tokens à chaque fois, le provider les garde en cache côté serveur.
J'ai ajouté ce paragraphe à ma note :
Ce système de prompt caching peut être utile aussi pour une application métier qui envoie de nombreuses requêtes différentes partageant toutes le même long system prompt. Plutôt que de retraiter ces tokens à chaque fois, le provider les garde en cache côté serveur. En fonction du contexte d'utilisation de l'application, il est possible de choisir plusieurs durées de cache, par exemple Anthropic propose 5min ou 1h.
À noter que le prompt caching n'est pas un cache logiciel classique au sens applicatif : c'est une optimisation transparente et implicite côté inférence, sans gestion de clés ni invalidation manuelle.
J'ai reçu le retour suivant d'une autre personne :
Je crois qu'en plus d'utiliser des Inferences Engines les AIs providers utilisent aussi des Workload Managers, Mistral avait mis https://github.com/SchedMD/slurm dans ses offres d'emploi compute
D'après ce que j'ai compris, Slurm Workload Manager est un projet qui a commencé en 2002, généralement utilisé sur des clusters High-performance computing (HPC) pour lancer de gros traitements de calcul, qui peuvent durer plusieurs heures ou même des jours, sur du matériel mutualisé entre plusieurs laboratoires de recherche.
J'ai trouvé cette mention dans une offre d'emploi qui semble aller dans le sens de cette hypothèse :
Now, it would be ideal if you also had:
• Experience with HPC workload managers (Slurm) and distributed storage systems (Lustre, Ceph)
Je pense que Mistral AI utilise Slurm pour leur offre Compute - built infrastructure for AI builders, qui permet à leurs clients de créer ou de fine-tuner des modèles.
Je ne pense pas que Slurm soit utilisé pour leur offre AI provider : c'est un ordonnanceur batch conçu pour des jobs longs et prévisibles, alors que l'inférence requiert une faible latence et la capacité à traiter des requêtes à la volée — deux patterns fondamentalement différents. Par conséquent, je n'ai pas inclus ce sujet dans ma cartographie de l'écosystème LLM de 2026.
Une troisième personne m'a fait des retours :
Il y un concept important que tu ne cites pas, c'est l'embedding (vectorisation).
En effet, j'ai oublié d'en parler. Je viens d'ajouter le paragraphe suivant dans ma note :
Pour écrire des données dans une base de données vectorielle, il est nécessaire de passer par une étape de vectorisation en utilisant un modèle d'embedding, comme par exemple Cohere Embed v3 multilingual ou text-embedding-3-large d'OpenAI. La vectorisation est également requise au moment d'effectuer la requête dans la base de données — avec impérativement le même modèle que celui utilisé lors de l'indexation.
Les modèles d'embedding sont nettement plus légers et économiques qu'un LLM. Ils peuvent être exécutés sur CPU pour des usages courants, sans nécessiter de GPU.
Cette même personne m'a aussi partagé :
je suis dans une phase d'exploration du Specs Driven Development.
Je connais la méthode, bien que je n'aie jamais remarqué qu'elle portait un nom : Specs Driven Development (SDD). Je pense que j'ai plus ou moins suivi cette méthode dans le fichier AGENTS.md de mon projet qemu-compose.
Je prépare très souvent mes specs quand je suis dans le métro ou quand je marche. Je réalise que mes notes publiques de projets me sont de plus en plus utiles comme base de spécification à soumettre aux LLMs, comme par exemple celle-ci : Première description du gestionnaire de projet de mes rêves.
J'ai fait quelques recherches sur le sujet du Specs Driven Development et je suis tombé sur le thread Hacker News « Spec-Driven Development: The Waterfall Strikes Back » ainsi que sur la section « Do you do spec-driven development? » d'un billet de blog. La pratique ne semble pas faire consensus. Je n'ai pas encore d'avis tranché sur la question.
Au passage, j'ai découvert ici deux autres noms de concepts : Verified Spec-Driven Development (VSDD) et Verification-Driven Development (VDD).
Je n'ai pas ajouté ces informations dans ma note de cartographie.
En rédigeant cette note, je me suis rendu compte que j'avais oublié quelques sujets.
J'ai ajouté un paragraphe sur le reranking :
Depuis 2022, les RAG avancés suivent le pattern "Retrieve, rerank, Generate". L'étape de reranking peut être effectuée via deux méthodes :
- Des modèles spécialisés de reranking, comme Cohere Rerank, ou Voyage AI Rerankers, qui sont légers, rapides. Ils prennent en entrée la
queryet la liste de documents candidats et produisent un score de pertinence.- Ou directement des LLMs généralistes, potentiellement plus précis sur des domaines spécifiques non couverts par les données d'entraînement des modèles de reranking, mais plus coûteux en latence et en tokens.
J'ai aussi ajouté un paragraphe sur chain-of-thought (CoT) :
La technique d'activation de raisonnement chain-of-thought (CoT) par prompting sur les LLMs classiques est connue depuis 2022.
Depuis o1 d'OpenAI en septembre 2024, les modèles sont entraînés spécifiquement pour le raisonnement via RL, on parle de Reasoning Language Model (RLM). L'utilisateur peut contrôler le niveau d'effort de raisonnement via le paramètreeffort.
Les modèles Claude Sonnet et Opus4.xadaptent dynamiquement l'effort de raisonnement en fonction de la complexité de la tâche — Anthropic nomme cela hybrid reasoning.
Et pour finir, j'ai ajouté un paragraphe à propos des API de type "Batch" :
La plupart des AI providers proposent une API asynchrone de type "batch" — exemples :
POST /v1/messages/batchespour Anthropic,POST /batchespour OpenAI, ouPOST /v1/batch/jobspour Mistral AI.
Ces APIs sont conçues pour des tâches non temps-réel, avec un délai de traitement pouvant aller jusqu'à 24h, en échange d'une réduction de 50% sur le tarif standard. Elles disposent par ailleurs de rate limits séparés des quotas synchrones, ce qui permet de soumettre de gros volumes sans impacter les appels temps-réel.