
LLM
Article Wikipedia : https://fr.wikipedia.org/wiki/Grand_modèle_de_langage
Aperçu des modèles de l'année 2024 : Timeline of AI model releases in 2024
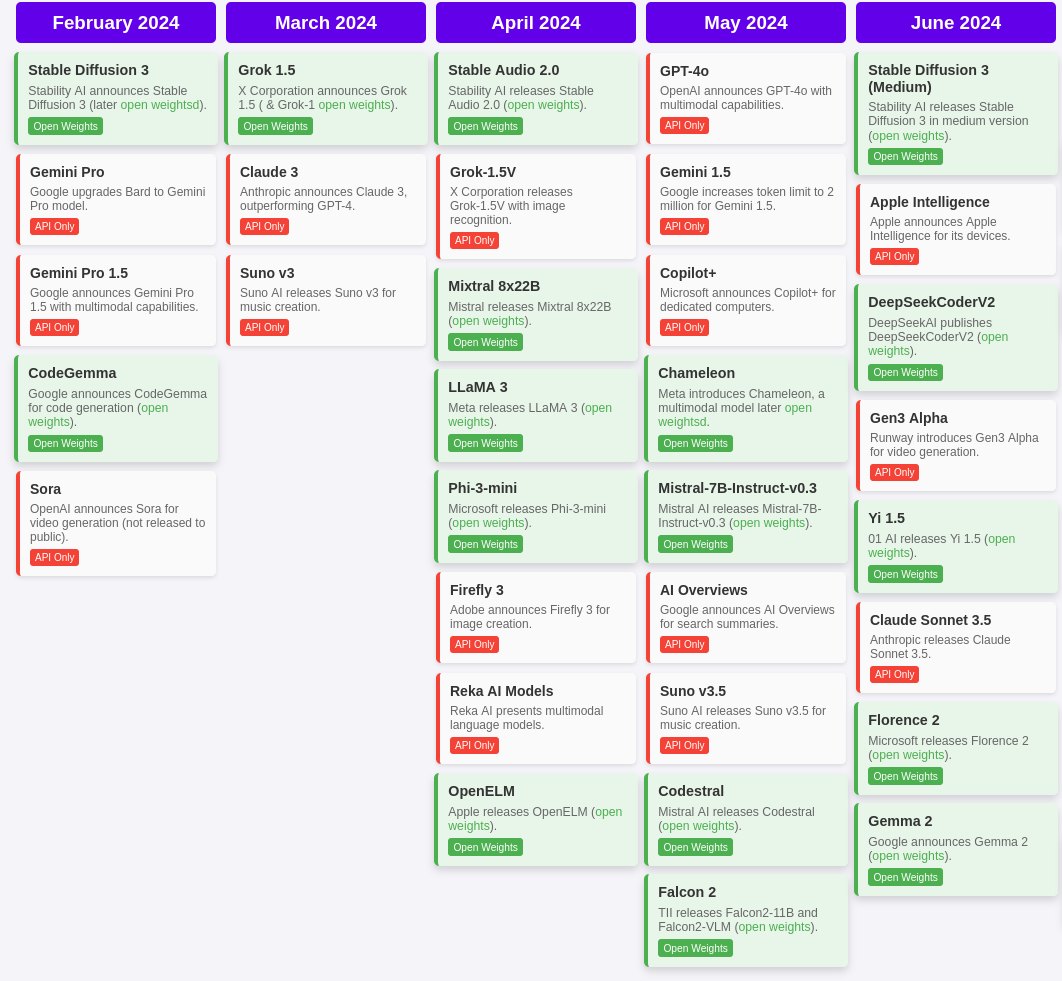
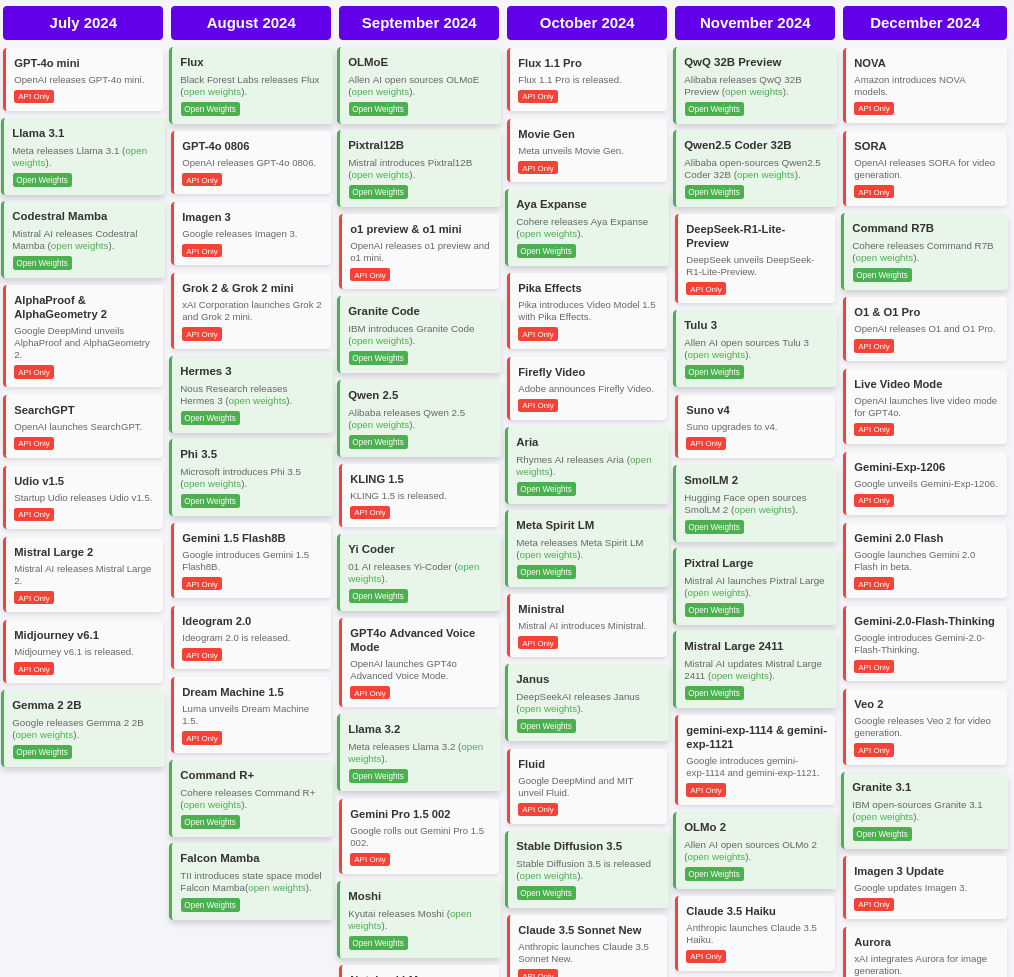
Journaux liées à cette note :
Depuis mars 2026 - je code avec des open weights pour 10 à 30 € par mois
Depuis mi-mars 2026, je suis passé des modèles Anthropic aux modèles Open Weights proposés par OpenCode Go au quotidien.
- En mars j'ai commencé par MiniMax M2.5
- En avril, principalement Kimi K2.5
- En mai, Kimi K2.6
- En juin et juillet DeepSeek-V4-Flash preview
- En août DeepSeek-V4-Flash 0731
- En septembre DeepSeek-V4.1-Flash
Comme le montre la liste ci-dessus, j'utilise les modèles Flash de DeepSeek depuis juin. Je les utilise soit via l'AI provider DeepSeek, soit à travers OpenCode Go.
OpenCode Go plafonne à 10 $ par compte. Fin août, face à la hausse soudaine des tarifs de DeepSeek Flash (annonce du 13 août 2026, discussion sur Hacker News), j'ai ouvert un second compte pour dépasser ce plafond : j'utilise donc deux comptes OpenCode Go à 10 $ par mois (soit 2 × 10 $). Au-delà de 20 $, ou si OpenCode Go est indisponible, je bascule sur le provider DeepSeek direct avec ces tarifs en mode Pay-As-You-Go.
Ces modèles me satisfont pleinement, tant pour le coding que pour l'analyse de texte, la réflexion ou l'aide à l'écriture. Et tout cela à un prix beaucoup plus compétitif que les offres OpenAI ou Anthropic : sur toute cette période, je suis resté entre 10 et 30 € par mois pour du coding.
Je précise tout de même qu'à côté de ces LLM, je possède toujours un abonnement Claude Pro à 18 € HT par mois, que j'utilise principalement sur mon smartphone. Je compte clôturer cet abonnement et à la place, utiliser sur mon smartphone OpenChamber connecté à OpenCode, connecté à DeepSeek V4.1-Flash, mais à ce jour, ce n'est toujours pas fait.
Mon impression de performance des modèles DeepSeek Flash est corroborée par les benchmarks.
Je ne veux pas me lancer, dans cet article, dans une analyse rigoureuse des différents modèles, ce que synthétise de toute façon bien mieux que moi Artificial Analysis.
Je me contenterai ici de partager seulement le benchmark Artificial Analysis Intelligence Index: Score :

Avec Opus 4.5, sorti en novembre 2025, un tournant reconnu dans la communauté s'est produit, et la pratique du coding agentique s'est diffusée (par exemple l'avis du créateur de Redis). Dans cette liste, j'ai sélectionné volontairement ce modèle comme mon jalon, ainsi que Claude Sonnet 4.6, sorti en février 2026, qui atteint empiriquement la même qualité de code pour un prix moindre.
Dans cette liste, j'ai inclus Mistral Medium 3.5, qui est, il me semble, au moment où j'écris ces lignes, le plus puissant de leurs modèles. On peut voir qu'il est en retard sur cet indice par rapport à la plupart des modèles actuels ; de mon côté, je ne vois personne l'utiliser.
Je pars du principe que tout ce qui atteint la qualité d'Opus 4.5 — donc a fortiori de Sonnet 4.6 — m'est utile. À partir de là, comme c'est moi qui paie mes crédits LLM et non mon entreprise — contrairement à la plupart de mes amis qui se préoccupent peu du coût — ce qui m'importe avant tout, c'est le prix et la vitesse de rendu. Sur le prix, la différence est réelle, comme l'illustre le benchmark Cost per Intelligence Index Task :

À tâche d'intelligence égale, DeepSeek Flash coûte une fraction de Sonnet 4.6, Sonnet 5 ou Opus 5.
En bas de cette note, j'ai dressé une liste de benchmarks qui comparent les modèles DeepSeek Flash avec 3 jalons : Sonnet 4.6, qui me sert de référence basse en tant qu'équivalent empirique d'Opus 4.5, puis Sonnet 5 et Claude Opus 5. Les modèles DeepSeek Flash s'y positionnent très bien par rapport à ces modèles de référence.
La seule exception notable est le benchmark AA-Omniscience Index: Score :
 2.png)
Pour éviter cela, je peux utiliser Kimi K3 ou GLM-5.3 qui se débrouillent aussi bien que Sonnet 5 dans ce benchmark.
Précision tout de même, le benchmark "AA-Omniscience: Evaluating Cross-Domain Knowledge Reliability in Large Language Models" exécute ses tests sans harness permettant au LLM de vérifier ses réponses à l'aide d'un RAG (recherche sur Internet ou autre). C'est une situation plus difficile que la situation réelle. Je ne remets pas en cause ce benchmark, je le prends en compte, mais dans ma pratique quotidienne je ne pense pas être impacté, car je configure mes harness pour toujours faire des vérifications. En pratique, lors des tâches de coding, c'est le bon fonctionnement du programme qui rattrape les hallucinations du LLM ; pour mes tâches d'écriture et d'analyse, c'est ma vérification des sources qui me permet de contredire le LLM en cas d'hallucination.
Annexe : liste de benchmarks
 (11 Sep '26).png)
.png)
.png)
.png)
.png)
.png)
.png)
.png)
.png)
Dernièrement, un ami m'a demandé : « qu'est-ce que je dois faire signer à mes clients pour être autorisé légalement à analyser leurs données confidentielles à l'aide d'un LLM, en fonction des types d'hébergement qui s'offrent à moi ? ».
Il travaille dans une entreprise sous-traitante industrielle. Contrairement à ma note du mois de juin, cette fois il ne s'agit pas de Données de santé (DDS), ni de PII, mais de secrets industriels. D'après ce que j'ai compris, le sujet est surtout contractuel.
Pour la suite de cette note, j'appelle Verdier Industries (nom fictif) l'entreprise de mon ami, afin d'incarner mes propos.
Dans cette note, je veux être très pratique : je souhaite générer des exemples de documents légaux à faire signer aux clients de Verdier Industries en fonction des options suivantes :
- a. LLM en SaaS hors UE
- b. LLM en SaaS en Europe hors France
- c. LLM en SaaS en France
- d. LLM installé sur une machine virtuelle avec GPU, louée chez Scaleway, OVH, etc.
- e. LLM installé sur un serveur physique dans ses locaux
Idéalement, je souhaite pouvoir facilement comparer ces documents légaux et analyser l'impact que cela aura sur la relation commerciale.
Lesquels risquent de faire peur à ses clients ou au contraire de les rassurer.
Avant d'entrer dans le détail, une précision sur le terme « accès à un LLM ». Si je simplifie, un LLM s'utilise de deux façons très différentes :
- via une interface de chat, dans un navigateur ou une application : c'est le cas de ChatGPT, Claude, Le Chat (Mistral AI), etc. Une personne écrit un message, le modèle répond. Ces noms désignent des interfaces de chat, pas le modèle qui est derrière. Les modèles portent d'autres noms.
- via une API : une sorte de porte d'entrée technique qui permet à un logiciel d'envoyer des demandes au modèle automatiquement, sans qu'un humain tape dans une fenêtre de chat. Quelques exemples de modèles connus au mois de septembre 2026 : GPT-5.6 Sol, Claude Sonnet 5, DeepSeek 4.1 Flash.
Dans cette note, je ne traite que du second cas, l'accès par API.
La raison : c'est le modèle LLM qui est très difficile à héberger soi-même, pas l'interface de chat.
Un LLM a besoin de serveurs puissants, équipés de GPU coûteux. Une fois qu'on dispose d'un accès au modèle, héberger une interface de chat comme Open WebUI ou LibreChat est plutôt facile, car ces services fonctionnent sur des machines modestes.
Autrement dit, les cinq options ci-dessous décrivent surtout où et comment on accède au modèle, pas comment on l'affiche à l'écran.
Une dernière précision : cette note traite uniquement des questions légales. Je compte publier une autre note pour tout ce qui concerne les estimations de coût d'hébergement pour chacune de ces options.
Je détaille les cinq options d'accès à un LLM
J'ai fait le choix de découper les offres commerciales réellement disponibles pour chacune de ces options par localisation du traitement des données, et non pas par juridiction du fournisseur.
J'ai indiqué la juridiction du fournisseur dans le tableau de synthèse en fin de section. Je tiens à préciser que cette question de juridiction n'est pas anecdotique pour les clients.
Solutions SaaS
Un service SaaS, ici, veut dire que le modèle est fourni et exécuté par un tiers : les données de Verdier Industries et de ses clients partent chez le fournisseur, qui renvoie une réponse. Contrairement aux solutions IaaS, Verdier Industries n'a donc pas besoin d'un administrateur système, interne ou externe, pour gérer le serveur qui fait tourner le modèle, ni pour s'occuper du modèle.
LLM en SaaS hors UE (a)
Lieu de traitement des données : hors de l'Union européenne.
Les offres les plus courantes en API directe chez des producteurs de LLM sont :
On trouve aussi des AI providers comme Deepinfra ou Together AI.
LLM en SaaS en Europe hors France (b)
Lieu de traitement des données : dans l'UE, mais le fournisseur n'est pas français.
Côté américain, l'endpoint européen d'OpenAI traite les données en Irlande (Dublin). Attention, le contrat reste conclu avec une entité américaine : OpenAI reste donc soumis au Cloud Act.
On y trouve aussi des acteurs européens comme :
- IONOS et leur offre AI Model Hub
- ou STACKIT et leur offre AI Model Serving
mais ces deux acteurs offrent un accès seulement à des modèles peu puissants.
LLM en SaaS en France (c)
Lieu de traitement des données : en France.
Les offres portées par une entité française sont :
- Mistral AI
- OVHcloud avec AI Endpoints
- Scaleway avec Generative APIs
En septembre 2026, Mistral AI et OVHcloud ne proposent que des modèles très peu puissants, bien loin derrière GLM-5.2 ou DeepSeek V4 Flash 0731 proposé par Scaleway.
Les acteurs américains peuvent aussi traiter dans des data centers en France, à condition de choisir explicitement un déploiement mono-région :
- AWS avec Bedrock
- Azure avec Azure OpenAI
- Google Cloud avec Vertex AI
- Together AI avec leur offre Dedicated inference, tuned for production
Pour tous ces acteurs, le contrat reste conclu avec une entité américaine : ils restent donc soumis au Cloud Act.
Solutions IaaS en France (d)
Une machine virtuelle avec GPU louée, c'est de l'IaaS : seule l'infrastructure est louée, le modèle LLM est installé et administré par un informaticien administrateur système de Verdier Industries. Le fournisseur n'a donc pas accès à l'OS de la machine virtuelle, donc pas aux données traitées.
Nuance : sur une machine virtuelle, l'hébergeur contrôle l'hyperviseur et pourrait en théorie accéder à la mémoire de la VM, ce qui n'est pas le cas sur un serveur bare metal.
- Quelques acteurs français :
- Scaleway, offres GPU Instances
- OVH, offres Cloud GPU
- Outscale, offres GPU NVIDIA
- Cloud Temple
- Acteurs américains dans leur datacenter en France soumis au Cloud Act :
- Together AI, offres GPU clusters
- AWS, offres Accelerated computing Amazon EC2 instance types
- Azure, offres GPU accelerated VM size series
- Google Cloud, offres accelerator-optimized
Sur site, un serveur dans les locaux de Verdier Industries (e)
Le serveur est dans les locaux de Verdier Industries : aucun tiers n'intervient, ni pour la machine, ni pour le modèle.
L'informaticien administrateur système de Verdier Industries doit prendre en charge l'installation, sur ce serveur, de logiciels comme vLLM, Ollama ou llama.cpp permettant d'instancier des LLM.
À ce coût matériel, DeepSeek V4 Flash me dit qu'il faut ajouter la facture d'électricité : un serveur 8x H100 ou H200 consomme de l'ordre de 10 kW au niveau informatique et 14 kW au niveau de l'installation, refroidissement inclus, soit de l'ordre de 15 000 à 30 000 € par an à pleine charge selon le prix du kWh.
Concrètement, un tel serveur ne peut pas être placé dans une pièce de bureaux : il faut une alimentation électrique dédiée, un refroidissement dimensionné et une pièce isolée acoustiquement.
Tableau de synthèse
| Option | Fournisseur | Pays de l'entité | Datacenter | Résidence UE | Exposition CLOUD Act |
|---|---|---|---|---|---|
| SaaS hors UE | OpenAI | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | Anthropic | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | États-Unis | États-Unis | Non | Oui | |
| SaaS hors UE | Deepinfra | États-Unis | États-Unis | Non | Oui |
| SaaS hors UE | Together AI | États-Unis | États-Unis | Non | Oui |
| SaaS Europe hors France | OpenAI | États-Unis | UE (Irlande) | Oui | Oui |
| SaaS Europe hors France | IONOS | Allemagne | UE | Oui | Non |
| SaaS Europe hors France | STACKIT | Allemagne | UE | Oui | Non |
| SaaS en France | Mistral AI | France | France | Oui | Non |
| SaaS en France | Scaleway | France | France | Oui | Non |
| SaaS en France | OVHcloud | France | France | Oui | Non |
| SaaS en France | AWS | États-Unis | France | Oui | Oui |
| SaaS en France | Microsoft | États-Unis | France | Oui | Oui |
| SaaS en France | États-Unis | France | Oui | Oui | |
| SaaS en France | Together AI | États-Unis | France | Oui | Oui |
| IaaS | Scaleway | France | France | Oui | Non |
| IaaS | OVHcloud | France | France | Oui | Non |
| IaaS | Outscale | France | France | Oui | Non |
| IaaS | Cloud Temple | France | France | Oui | Non |
| IaaS | Together AI | États-Unis | France | Oui | Oui |
| IaaS | AWS | États-Unis | France | Oui | Oui |
| IaaS | Microsoft | États-Unis | France | Oui | Oui |
| IaaS | États-Unis | France | Oui | Oui | |
| Sur site | — | Auto-hébergé | Locaux de Verdier Industries | Oui | Non |
Les 6 situations contractuelles
À partir de toutes les options d'hébergement d'un LLM listées précédemment, voici la liste de toutes les situations contractuelles.
Le classement va du plus simple à opérer (SaaS hors UE) au plus difficile (serveur sur site).
| Cas | Option | Exposition des données à un tiers | Transfert hors UE | Cloud Act |
|---|---|---|---|---|
| 1 | (a) SaaS hors UE | Oui | Oui | Oui |
| 2 | (b/c) SaaS datacenter en UE ou FR, entité US | oui | Non | Oui |
| 3 | (b/c) SaaS datacenter en UE ou FR, entité UE | oui | Non | Non |
| 4 | (d) IaaS US avec datacenter en FR | non | Non | Oui |
| 5 | (d) IaaS FR avec data center en FR | non | Non | Non |
| 6 | (e) sur site | aucun tiers | Non | Non |
Liste des démarches administratives à effectuer pour chaque situation contractuelle
Je pars de la situation suivante : Verdier Industries a déjà 50 clients sous contrat, il décide de réaliser les démarches légales auprès de ses clients afin d'être autorisé à envoyer des données confidentielles de ses clients à son LLM à travers la solution qu'il a retenue. Quels sont les documents à produire, envoyer au client, faire signer, etc.
Hypothèse générale : les contrats clients interdisent la divulgation des données confidentielles à un tiers sans accord écrit. Un avenant signé est donc nécessaire.
J'ai dressé la liste des étapes de ces procédures administratives avec l'aide de DeepSeek V4.1 Flash.
Cas 1 - SaaS hors UE
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple OpenAI) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- ses CCT (Clauses Contractuelles Types), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD) et annexe des CCT.
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Selon ce que prévoit le contrat client pour le RGPD :
- Si le contrat contient une autorisation générale, par exemple : « Le client autorise Verdier Industries à recourir à des sous-traitants ultérieurs. Verdier Industries informe le client par écrit au moins 30 jours à l'avance, et le client peut s'opposer à cette modification. » Alors, pour le RGPD, Verdier envoie une simple notification, et si le client ne s'oppose pas dans les 30 jours, le nouveau sous-traitant est accepté, sans signature.
- Si le contrat contient une autorisation spécifique, par exemple : « Verdier Industries ne peut confier les données à un sous-traitant ultérieur qu'après accord écrit préalable du client. » Alors Verdier doit faire signer l'avenant pour le RGPD aussi.
- Dans les deux cas, ces clauses ne couvrent ni les secrets industriels ni le risque Cloud Act : pour ces deux points, l'avenant doit être signé.
Cas 2 - SaaS datacenter en UE ou FR, entité US
Les données sont traitées dans l'UE, mais le fournisseur est une entité américaine : il reste soumis au Cloud Act. Comme il n'y a pas de transfert hors UE, les CCT ne sont pas nécessaires.
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple l'endpoint européen d'OpenAI) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels et le risque Cloud Act imposent une signature.
Cas 3 - SaaS datacenter en UE ou FR, entité UE
Les données sont traitées dans l'UE par une entité européenne : ni transfert hors UE, ni exposition au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son fournisseur (par exemple Scaleway) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-entraînement et de rétention zéro ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017, 27018, 27701 et 42001, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation de divulgation des données à un tiers ;
- article 2 : confidentialité ;
- article 3, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels impose une signature.
Cas 4 - IaaS US avec datacenter en FR
L'infrastructure est louée chez un hébergeur américain. L'hébergeur n'accède pas au contenu des données, mais il reste soumis au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son hébergeur (par exemple AWS) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-accès au contenu des données hébergées : mémoire vive, volumes de stockage et snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017 et 27018.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation d'héberger les données sur une infrastructure tierce ;
- article 2 : Verdier Industries garantit que l'hébergeur n'a pas accès au contenu des données, son accès étant limité à l'infrastructure nécessaire à l'hébergement, hors réquisition d'une autorité judiciaire ou administrative compétente ;
- article 3 : acceptation du risque Cloud Act ;
- article 4, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels et le risque Cloud Act imposent une signature.
L'engagement de non-accès demandé à l'hébergeur peut être rédigé ainsi :
L'hébergeur s'engage à ne pas accéder au contenu des données hébergées, en particulier à la mémoire vive, aux volumes de stockage et aux snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente. En cas de réquisition, l'hébergeur en informe Verdier Industries dans les meilleurs délais, sauf si la loi lui interdit de le faire.
Cas 5 - IaaS FR avec data center en FR
L'infrastructure est louée chez un hébergeur français ou européen : ni transfert hors UE, ni exposition au Cloud Act.
Procédure pas à pas :
- Verdier Industries demande à son hébergeur (par exemple Scaleway) les documents suivants et les rassemble :
- son accord de confidentialité ;
- son engagement de non-accès au contenu des données hébergées : mémoire vive, volumes de stockage et snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente ;
- son DPA (Data Processing Agreement, accord de traitement des données), si données personnelles ;
- la liste de ses sous-traitants ultérieurs ;
- ses certifications et attestations de sécurité : SOC 2 Type II (attestation) et ISO/IEC 27001 (certification), et le cas échéant ISO/IEC 27017 et 27018, SecNumCloud ou HDS.
- Verdier Industries rédige un avenant type au contrat client, structuré en articles :
- article 1 : autorisation d'héberger les données sur une infrastructure tierce ;
- article 2 : Verdier Industries garantit que l'hébergeur n'a pas accès au contenu des données, son accès étant limité à l'infrastructure nécessaire à l'hébergement, hors réquisition d'une autorité judiciaire ou administrative compétente ;
- article 3, si données personnelles : autorisation de sous-traitance (article 28.2 du RGPD).
- Verdier Industries joint à l'avenant les documents obtenus à l'étape 1.
- Verdier Industries envoie le dossier à chaque client.
- Le client signe l'avenant et le renvoie.
- Verdier Industries archive l'avenant signé et ses pièces jointes par client.
Pour le RGPD :
- Si le contrat contient une autorisation générale de sous-traitance : une notification avec droit d'opposition suffit, sans signature.
- S'il exige un accord écrit au cas par cas : l'avenant doit être signé.
- Dans les deux cas, la confidentialité des secrets industriels impose une signature.
L'engagement de non-accès demandé à l'hébergeur peut être rédigé ainsi :
L'hébergeur s'engage à ne pas accéder au contenu des données hébergées, en particulier à la mémoire vive, aux volumes de stockage et aux snapshots des machines virtuelles, sauf demande écrite de Verdier Industries ou réquisition d'une autorité judiciaire ou administrative compétente. En cas de réquisition, l'hébergeur en informe Verdier Industries dans les meilleurs délais, sauf si la loi lui interdit de le faire.
Cas 6 - Hébergement sur site
Le serveur est dans les locaux de Verdier Industries : aucun tiers n'intervient.
- Aucun document à obtenir d'un tiers.
- Aucun avenant à faire signer : les données ne quittent pas les locaux et ne sont divulguées à personne.
- Pour rassurer le client, Verdier Industries peut l'informer que le traitement se fait en interne, sans sous-traitant ultérieur.
Liste des différences entre les situations contractuelles
Différences entre cas 2 et cas 1
- Les données restent dans l'UE : les CCT ne sont plus nécessaires.
- Le reste est identique, notamment le risque Cloud Act.
Différences entre cas 3 et cas 2
- Le fournisseur est une entité européenne : plus de risque Cloud Act.
- L'article 3 de l'avenant (acceptation du risque Cloud Act) disparaît.
- Le reste est identique.
Différences entre cas 4 et cas 3
- Le fournisseur ne traite plus les données : l'hébergeur n'accède pas au contenu, et l'avenant le garantit (article 2).
- L'engagement de non-entraînement et de rétention zéro disparaît.
- L'article 1 de l'avenant devient une autorisation d'héberger, et non plus une autorisation de divulgation.
- Le risque Cloud Act réapparaît, car l'hébergeur est américain.
Différences entre cas 5 et cas 3
- Le fournisseur ne traite plus les données : l'hébergeur n'accède pas au contenu, et l'avenant le garantit (article 2).
- L'engagement de non-entraînement et de rétention zéro disparaît, remplacé par un engagement de non-accès au contenu.
- L'article 1 de l'avenant devient une autorisation d'héberger, et non plus une autorisation de divulgation.
- Les certifications attendues sont allégées : plus de 27701 ni 42001, qui n'ont plus de sens quand le fournisseur ne traite pas les données.
- Le reste est identique : ni transfert hors UE, ni risque Cloud Act.
Différences entre cas 5 et cas 4
- L'hébergeur est français ou européen : plus de risque Cloud Act.
- L'article 3 de l'avenant (acceptation du risque Cloud Act) disparaît.
- Le reste est identique.
Différences entre cas 6 et cas 5
- Aucun tiers n'intervient : plus de documents à obtenir ni d'avenant à signer.
- Il ne reste qu'une information au client, sans sous-traitant ultérieur.
Ce que je retiens
En travaillant cette note, je m'attendais, naïvement, à ce que le cas 5 — un LLM installé sur une machine virtuelle avec GPU louée chez un hébergeur français, dans un data center français — soit indolore contractuellement, c'est-à-dire qu'il n'exige aucun avenant aux contrats clients, mais ce n'est pas le cas.
En réalité, l'infrastructure reste louée à un tiers. Les contrats clients interdisent la divulgation des données confidentielles à un tiers sans accord écrit, et même si l'hébergeur n'accède pas au contenu, le fait de lui confier l'infrastructure qui porte les données déclenche quand même la signature.
Gagner en souveraineté réduit le nombre d'articles et la gravité du risque, mais ne ramène pas le travail contractuel à zéro.
Mon regard de praticien de terrain
Comme dans ma note du mois de juin sur les données de santé, je termine cette note avec un sentiment partagé.
Je suis un praticien de terrain : j'administre les serveurs, je gère les données de mes propres mains. En lisant tout cet édifice contractuel, je sais qu'il s'agit d'une convention humaine — ce que l'on nomme le constructivisme juridique, il me semble — souvent assez éloignée de la logique et de la pratique du terrain.
C'est un exercice d'analyse que j'aime beaucoup, mais qui m'est difficile. Il me crée une dissonance cognitive. D'un côté, je pense en praticien : je vois ce qu'on pourrait faire techniquement, concrètement, physiquement, pour renforcer la sécurité des données. De l'autre, ces protections juridiques sanctionnent devant un juge, mais ne protègent pas la donnée physiquement. C'est une protection par la sanction, pas une protection réelle. Ma culture hacker est de protéger pour de vrai, pas par le droit. Je crois que c'est là la source de ma dissonance, et parfois de mon énervement.
J'y trouve régulièrement de l'incohérence, parfois une forme d'hypocrisie, un peu comme un jeu de théâtre. Je ne dis pas que cela ne sert à rien — sans doute que ce cadre protège. Peut-être que mon regard de praticien me rend trop sensible à ce qui sépare la théorie juridique du terrain.
Premier test minimaliste de Promptfoo avec le provider OpenCode SDK
Depuis au moins novembre 2025, je cherche à rédiger mes prompts, mes fichiers AGENTS.md, mes fichiers SKILLS.md — et plus largement mon harness OpenCode — avec une méthode rigoureuse et contrôlée. J'ai découvert dans cette issue le nom du mécanisme que j'essaie de mettre en place : agent-eval-harness, terme plutôt simple et explicite.
En février, je disais :
Je compte créer un playground Promptfoo connecté à plusieurs modèles LLM dans les semaines à venir.
Quelques mois plus tard, j'ai enfin implémenté un premier POC utilisant Promptfoo couplé avec le provider OpenCode SDK : https://github.com/stephane-klein/opencode-promptfoo-poc.
Cette première itération est volontairement minimaliste. J'ai testé :
- 3 LLMs (dans 2 configurations chacune)
- 3 cas de test
L'intégralité de mon évaluation tient dans un seul fichier promptfooconfig.yaml :
# yaml-language-server: $schema=https://promptfoo.dev/config-schema.json
description: "Hello World - minimal test"
providers:
  - id: opencode:sdk
    label: "without-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "without-agent-minimax-m2.7"
    config:
      provider_id: opencode-go
      model: minimax-m2.7
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "without-agent-deepseek-v4-flash"
    config:
      provider_id: opencode-go
      model: deepseek-v4-flash
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "with-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/

  - id: opencode:sdk
    label: "with-agent-minimax-m2.7"
    config:
      provider_id: opencode-go
      model: minimax-m2.7
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/

  - id: opencode:sdk
    label: "with-agent-deepseek-v4-flash"
    config:
      provider_id: opencode-go
      model: deepseek-v4-flash
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/

prompts:
  - "Translate the following English text to {{language}}: {{input}}"

tests:
  - vars:
      language: French
      input: Hello world
    assert:
      - type: contains-all
        value:
          - "Bonjour"
          - "monde"

  - vars:
      language: Spanish
      input: Where is the library?
    assert:
      - type: contains-any
        value:
          - "Donde esta la biblioteca"
    providers:
      - "with-agent*"

  - vars:
      language: Spanish
      input: Where is the library?
    assert:
      - type: not-contains-any
        value:
          - "Donde esta la biblioteca"
    providers:
      - "without-agent*"
L'exécution de promptfoo eval donne ceci :
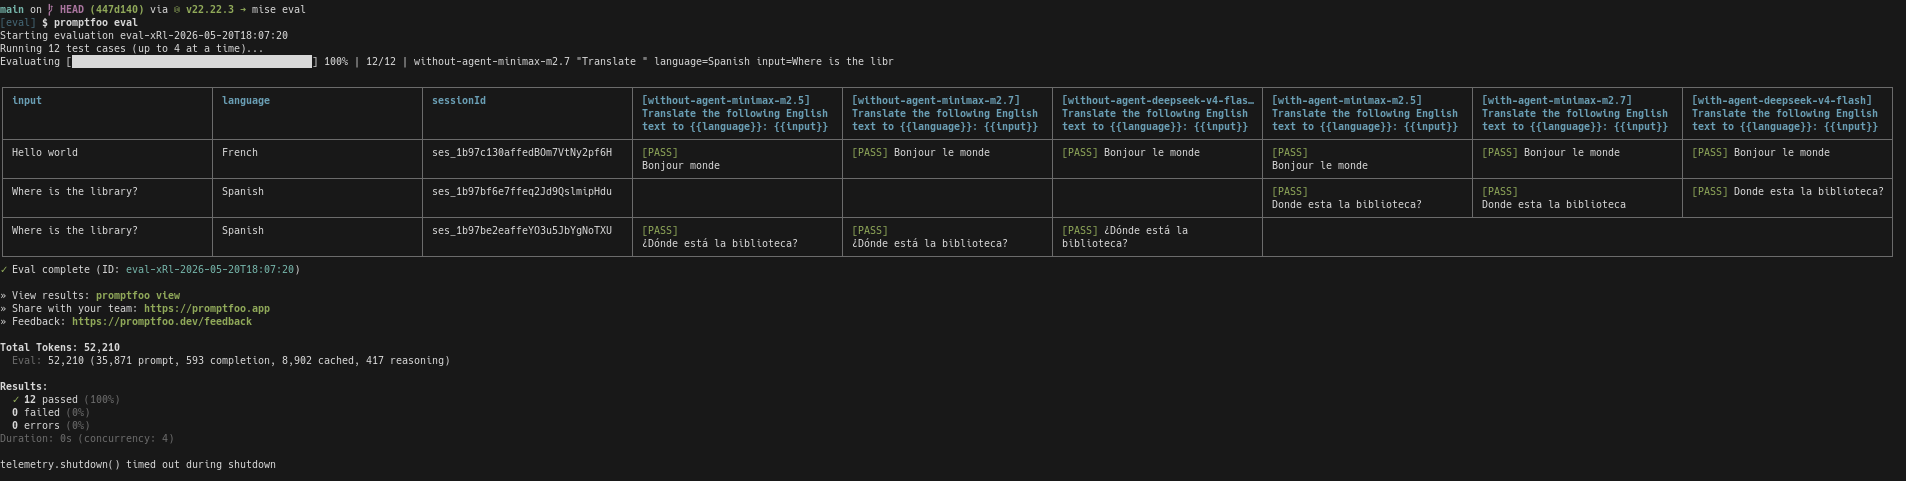
Et voici ce qu'affiche promptfoo viewer dans un browser :
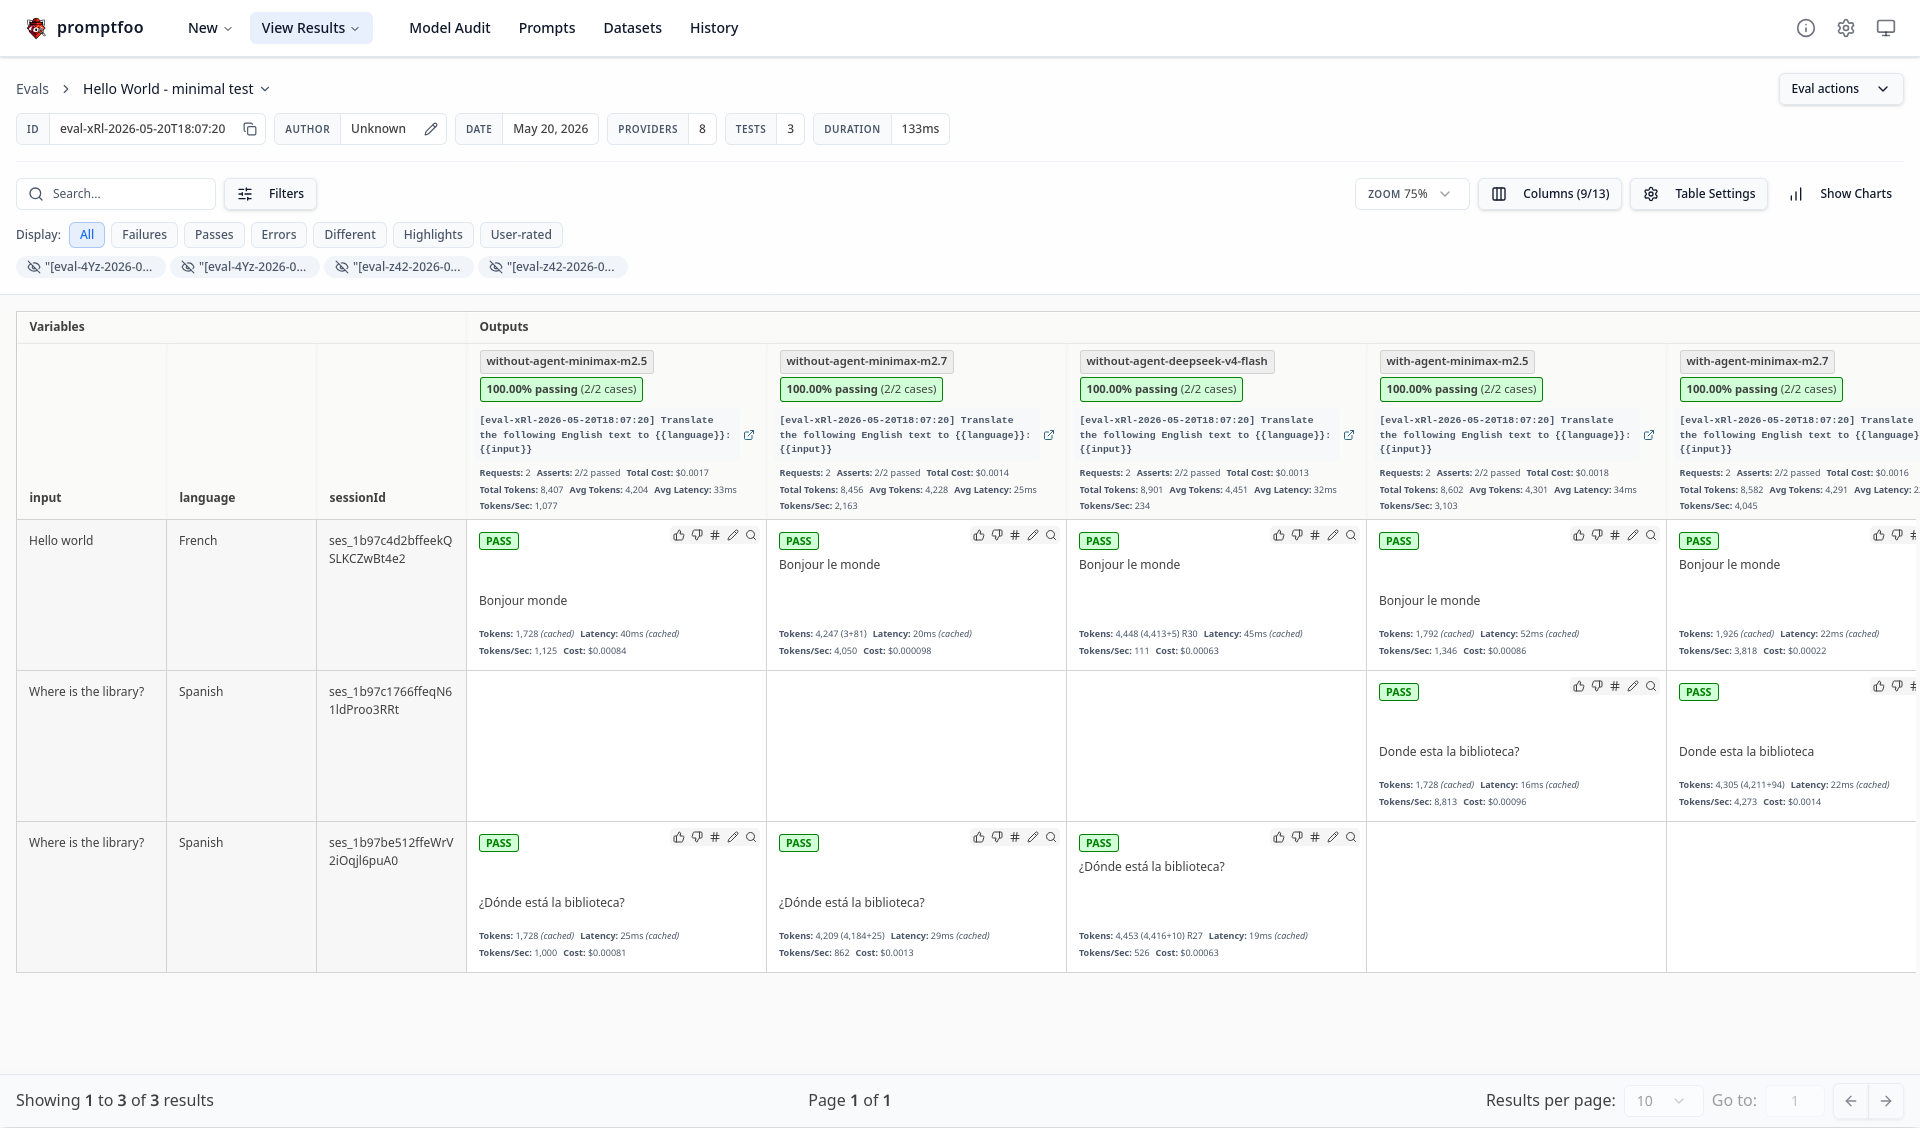
Dans mes tests, j'ai mis en œuvre uniquement contains-all et contains-any, mais Promptfoo propose beaucoup d'autres « Deterministic metrics ».
Promptfoo propose aussi de nombreuses assertions effectuées par des modèles de langage, les « Model-graded metrics », dont la plupart peuvent être qualifiées de LLM-as-a-Judge. Je ne les ai pas encore testées.
Je n'ai pas non plus exploré l'évaluation de « Chat conversations / threads ». Par ailleurs, en examinant la documentation du provider OpenCode SDK, j'ai constaté ce qui me semble être une limitation : il n'est probablement pas possible de changer d'agent dans un thread, c'est-à-dire d'alterner entre le mode plan et le mode build, comme on le ferait dans un usage normal de OpenCode.
Mais après réflexion, il me semble que cette limitation n'est pas importante. Dans un test d'évaluation, chaque cas est un appel unique à l'agent, avec l'historique complet de la conversation fourni en contexte — il n'est pas nécessaire de simuler un flux interactif multi-tours avec alternance d'agents.
Dans ce POC, je configure le provider OpenCode SDK pour qu'il utilise le dossier de configuration ./config/opencode du repository, afin que le harness évalué soit précisément celui qui est versionné, et afin de ne pas subir de perturbation par la configuration OpenCode globale.
Quand j'ai démarré ce POC, j'ai essayé d'indiquer différentes configurations OpenCode au niveau des tests, pour tester différents fichiers AGENTS.md. Mais j'ai constaté que la configuration OpenCode ne peut être définie qu'une seule fois, ici, via une variable d'environnement XDG_CONFIG_HOME.
J'ai mis un certain temps à réaliser que je pouvais procéder autrement, en plaçant les fichiers AGENTS.md dans différents working_dir. Les working_dir se configurent au niveau des providers, voici deux exemples :
  - id: opencode:sdk
    label: "without-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "with-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/
Cela permet de charger et de tester ./workdir1/AGENTS.md ou ./workdir2/AGENTS.md. Il est possible d'utiliser la même méthode pour évaluer différents SKILLS.md.
Pour le moment, je ne sais pas encore si Promptfoo est un bon outil pour mettre au point mon harness.
Avant de poursuivre mes tests de harness engineering avec Promptfoo, j'aimerais tester agent-catalog-eval pour voir si cet outil serait plus simple à mettre en œuvre.
Comment "harness" s'est répandu en IA et pourquoi ce terme a été choisi
Le week-end dernier, j'ai commencé à chercher d'où venait le terme harness et pourquoi il a été choisi pour désigner ce concept dans les AI agents comme OpenCode ou Claude Code.
Cette note est le résultat de ce travail de recherche, basé sur des échanges avec Sonnet 4.6, des lectures de commentaires Hacker News et divers articles sur le sujet.
En novembre 2025, Anthropic a publié l'article « Effective Harnesses for Long-Running Agents », qui utilise explicitement « agent harness » dans le sens moderne.
Le terme « harness engineering » semble avoir été popularisé par Mitchell Hashimoto dans la section 5 de son billet publié le 5 février 2026. Il y décrit une pratique qu'il a développée au fil de son usage des agents IA :
Je ne sais pas s'il existe un terme largement accepté par l'industrie pour cela, mais j'en suis venu à appeler cela « harness engineering ». C'est l'idée que chaque fois qu'on constate qu'un agent commet une erreur, on prend le temps de concevoir une solution pour que l'agent ne commette plus jamais cette erreur. Je n'ai pas besoin d'inventer de nouveaux termes ici ; s'il en existe un autre, je m'y joindrai.
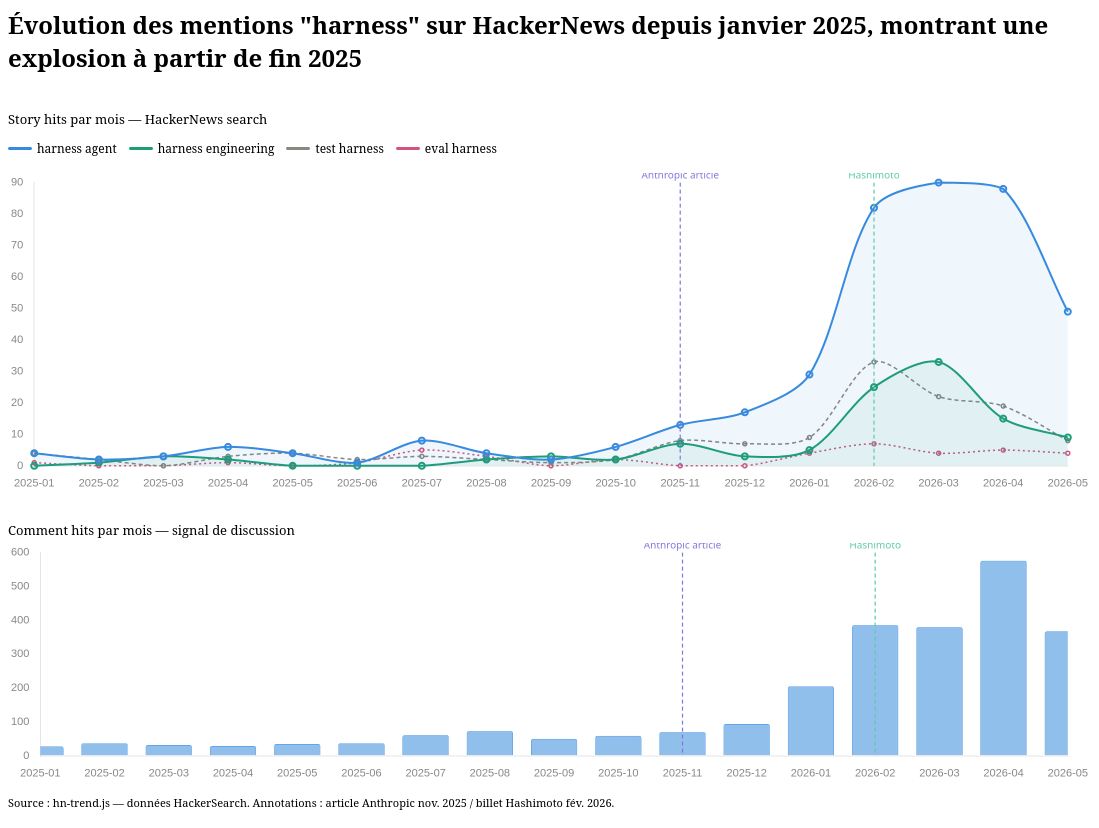 Données extraites avec hackernews-trends-poc.
Jusqu'à présent, je pensais à tort que l'analogie du harnais correspondait simplement à l'équipement qu'on pose sur un cheval, sans saisir la pertinence de ce terme, par manque de culture de cette langue. En anglais, on trouve les expressions « harness the sun » ou « harness the wind ». Voici la définition du verbe harness :
Verb
harness (third-person singular simple present harnesses, present participle harnessing, simple past and past participle harnessed)
- (transitive) To place a harness on something; to tie up or restrain. Synonym: tackle
« They harnessed the horse to the post. »- (transitive) To capture, control or put to use. « Imagine what might happen if it were possible to harness solar energy fully. »
- (transitive) To equip with armour.
Le terme français qui me semble le plus proche du verbe harness serait « canaliser » ou « dompter ».
Le terme harness désigne donc l'action de canaliser et d'orienter la puissance d'un LLM vers un objectif souhaité.
Avant l'usage du terme harness dans le domaine de l'AI — que ce soit pour agent harness, harness engineering ou LM Evaluation Harness — j'ai découvert en travaillant sur cette note qu'il était déjà utilisé en software engineering, principalement dans l'expression test harness. Il me semble que c'était d'ailleurs l'usage principal du mot dans notre domaine, bien avant qu'il ne soit repris pour les agents IA.
Les concepts que je pense avoir identifiés et que je retiens
- Le harness est un artefact à installer et configurer dans OpenCode. Il est composé de :
- Le harness engineering est le processus humain d'amélioration itérative du harness. Quand l'utilisateur observe une erreur de l'agent, il modifie ou ajoute des fichiers
AGENTS.md,SKILLS.md, des outils MCP ou des configurations pour qu'elle ne se reproduise plus. Ce terme désigne le processus, par opposition au harness qui est l'artefact. - Agent-eval-harness est un outil externe au harness permettant de lancer des sortes de tests unitaires. Il est utilisé pendant les phases de harness engineering pour valider les modifications de façon contrôlée et reproductible.
Cette note ne traite pas de la boucle agent en elle-même — j'ai documenté ce concept séparément ici :
Une application est qualifiée d'AI agent lorsqu'un LLM y prend de façon autonome des décisions en boucle pour atteindre un objectif — en appelant des tools, en consultant des sources via RAG, ou en déléguant à des sous-agents. La boucle s'arrête lorsque l'objectif est atteint ou qu'une intervention humaine est requise.
Le concept de harness vient encadrer cette boucle pour la configurer et la contraindre, mais il ne la définit pas. Comprendre la boucle aide à saisir ce qu'orchestre le harness.
Extrait d'un article de Sebastian Raschka :
Pour clarifier les concepts :
- LLM : le modèle brut de prédiction du prochain token
- Modèle de raisonnement : un LLM optimisé pour produire des traces de raisonnement intermédiaires et se vérifier davantage
- Agent : une boucle qui combine un modèle avec des outils, de la mémoire et des retours d'environnement
- Agent harness : le scaffold logiciel autour d'un agent qui gère le contexte, l'utilisation des outils, les prompts, l'état et le flux de contrôle
- Coding harness : un cas particulier d'agent harness ; un harness spécifique au génie logiciel qui gère le contexte du code, les outils, l'exécution et les retours itératifs
Quelques articles que j'ai lus avec attention :
- Effective harnesses for long-running agents — Anthropic, nov. 2025
- My AI Adoption Journey — Mitchell Hashimoto, fév. 2026
- Components of a Coding Agent — Sebastian Raschka, avr. 2026
En explorant le sujet de harness, je constate que, comme beaucoup de concepts, sa définition peut varier selon les sources et les communautés. Par exemple, l'article Components of a Coding Agent de Sebastian Raschka semble en proposer une définition plus large que Mitchell Hashimoto.
Pour le moment, je souhaite adopter la version de Mitchell Hashimoto, que j'arrive mieux à appréhender et dont je parviens mieux à délimiter le périmètre : un dispositif qui canalise la fougue du LLM, comme le harnais canalise le cheval sauvage.
Journal du jeudi 07 mai 2026 à 00:06
Je viens de publier Projet 37 - "Application de répétition espacée, comme Anki, assistée par LLM".
En rédigeant cette note, j'ai découvert Mochi qui est une alternative closed-source à Anki et qui intègre un serveur MCP (mcp-mochi) qui devrait permettre de créer les cards avec un LLM. J'envisage de tester cet outil.
J'ai découvert snip et rtk et testé rtk (reduce LLM usage)
Le 13 avril 2026, j'ai découvert le projet snip :
Quelques semaines plus tard, le 29 avril, Alexandre m'a fait découvrir rtk, une alternative à snip.
rtk est un projet Rust dont le développement a commencé le 18 janvier 2026. snip, quant à lui, est un projet Golang initié par un français basé à la Réunion le 15 février 2026, directement inspiré de rtk.
Voici comment le projet snip compare les deux projets :
Design Philosophy
snip chose a fundamentally different approach to LLM token reduction: filters are data, not code. The binary is the engine, filters are YAML data files, and the two evolve independently.
rtk (Rust) snip (Go) Filter authoring Write Rust, recompile, wait for release Write YAML, drop in a folder, done Filter format Compiled into the binary Declarative YAML, engine and filters evolve independently Custom filters Fork the repo, add Rust code Create a .yamlfile in~/.config/snip/filters/Concurrency 2 OS threads Goroutines (lightweight, no thread pool) SQLite Requires CGO + C compiler Pure Go driver, static binary, no dependencies Cross-compilation Per-target C toolchain GOOS=linux GOARCH=arm64 go buildPipeline actions Built-in strategies 19 composable actions (keep, remove, regex, JSON, state machine...) Contributing Rust knowledge required YAML knowledge sufficient Both tools solve the same problem: reducing AI token costs from verbose CLI output. snip's bet is that extensibility wins. When anyone can write a filter in 5 minutes without touching Go or Rust, the filter ecosystem grows faster.
Voici à quoi ressemble un filtre dans rtk : https://github.com/rtk-ai/rtk/blob/master/src/filters/jj.toml.
Et voici l'équivalent pour snip : https://github.com/edouard-claude/snip/blob/master/filters/jj.yaml.
Je trouve la possibilité d'ajouter de nouvelles commandes à snip simplement en créant un fichier YAML intéressante, mais pour le moment je ne sais pas si j'en aurai besoin.
D'autre part, rtk est supporté par Mise : https://mise-versions.jdx.dev/tools/rtk.
Par conséquent, j'ai décidé de tester la configuration de rtk avec OpenCode. Voici le commit d'intégration à sklein-devbox : https://github.com/stephane-klein/sklein-devbox-chezmoi/commit/0fa4917ee2f31605f8d124223ec650961bf057b6.
Voici comment j'ai initialisé le plugin OpenCode pour rtk :
$ rtk init -g --opencode

OpenCode plugin installed (global).

  OpenCode: /home/sklein/.config/opencode/plugins/rtk.ts
  Restart OpenCode. Test with: git status


--- Telemetry ---
RTK collects anonymous usage metrics once per day to improve filters.

  What:    command names (not arguments), token savings, OS, version
  Why:     prioritize filter development for the most-used commands
  Who:     RTK AI Labs, contact@rtk-ai.app
  Rights:  disable anytime with `rtk telemetry disable`,
           request erasure with `rtk telemetry forget`
  Details: https://github.com/rtk-ai/rtk/blob/main/docs/TELEMETRY.md

Enable anonymous telemetry? [y/N] y
  Telemetry enabled. Disable anytime: rtk telemetry disable
Et voici un exemple d'utilisation :
$ opencode run "Quels sont les derniers changements de ce projet ?"

> build · minimax-m2.5

$ rtk git log --oneline -10
0fffe04 Remove mode -x dot_config/tmux/scripts/executable_current-path.sh
832f03b Add peeble/ to Chezignore  #   <m-r>      Reset Message
0fa4917 Setup rtk to reduces OpenCode LLM token consumption
983b77d s6-overlay migration to Pebble (#25)
1f7cbcd Start Mise eval before atuin to fix a bug
c8e6194 Remove gopass and GPG agent management since both services start automatically on first use
71e64e1 Enable Mise environment activation so Neovim can access Mise-managed tools
679f53f Purge empty mise installs/ dirs to force reinstall of incomplete tools
4c32db8 Extract init process into standalone script
8258ab9 Add infomation messages in init scripts

...
Je constate que la commande rtk git log est correctement utilisée par OpenCode.
Voici ce que m'affiche la commande rtk gain :
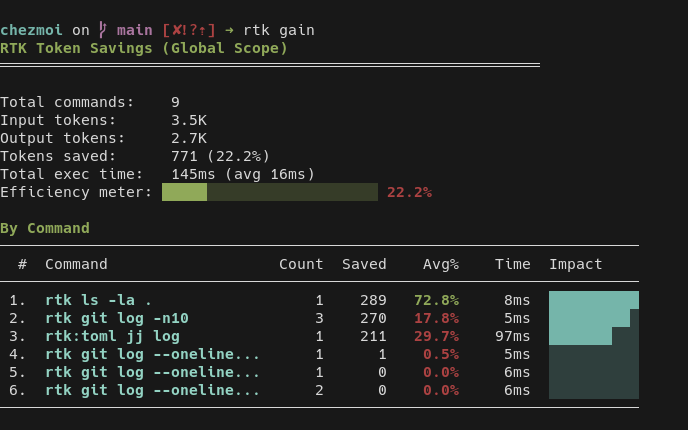
Pour le moment ceci n'est pas représentatif, car je viens de l'installer et j'ai lancé uniquement des tests fictifs.
Je compte publier une note de bilan d'ici quelques semaines pour analyser si c'est vraiment impactant ou non.
Comment je me renseigne sur un nouveau modèle LLM en 4 étapes
Voici le process que je suis lorsque je découvre un nouveau modèle LLM et que je souhaite en savoir plus à son propos.
Étape 1 : blog de Simon Willison
Je commence par jeter un œil rapide sur le blog de Simon Willison, car cela fait plusieurs années que je le suis et j'apprécie son expertise et ses analyses de modèles.
Étape 2 : les articles de Artificial Analysis
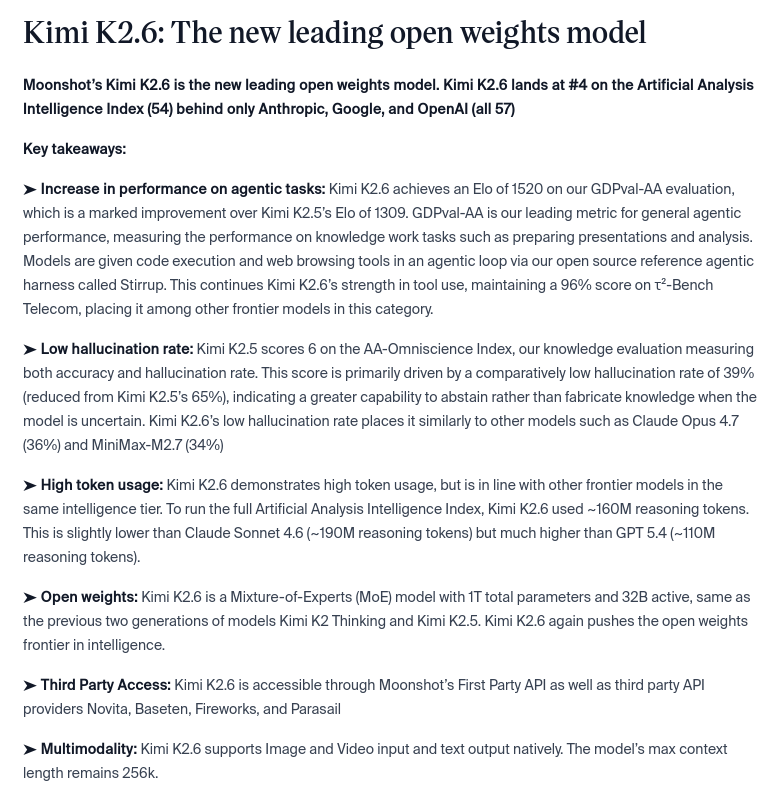
Ensuite je regarde les articles (https://artificialanalysis.ai/articles) d'Artificial Analysis, pour voir s'ils ont publié un nouvel article sur ce modèle. Généralement, ils sont très réactifs. Voici un exemple concernant Kimi K2.6 : Kimi K2.6: The new leading open weights model.
J'aime beaucoup la structure de leurs articles.
Tout d'abord, une section synthétique avec des informations majeures du modèle :
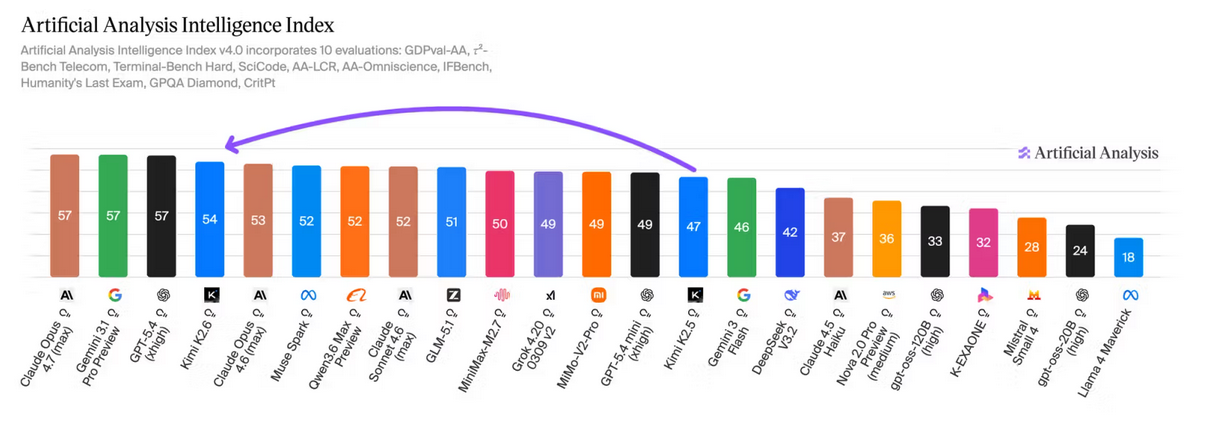
Ensuite, la position du nouveau modèle pour différents leaderboards :
Étape 3 : Analyse des commentaires HackerNews
En troisième étape, j'utilise le moteur de recherche de Hacker News pour identifier le thread qui traite du modèle. Voici par exemple celui à propos de Kimi K2.6: Advancing open-source coding et ses 371 commentaires.
À partir de l'url de ce thread, je lance le prompt suivant dans Claude Desktop connecté au serveur MCP fetch lancé localement :
Utilise `fetch_html` pour récupérer https://news.ycombinator.com/item?id=47835735

**Étape 1 — Récupération complète**

- Récupère la première page avec `fetch_html` et lis le nombre total de commentaires indiqué en début de page — ce nombre est ta cible obligatoire
- Le contenu étant probablement tronqué (limite 200 000 caractères), enchaîne les appels successifs en incrémentant `start_index` de 200 000 à chaque fois :
  - `fetch_html(url, start_index=0, max_length=200000)`
  - `fetch_html(url, start_index=200000, max_length=200000)`
  - `fetch_html(url, start_index=400000, max_length=200000)`
  - … jusqu'à ce que la réponse soit vide
- **Tu dois avoir récupéré 100% des commentaires avant de passer à l'étape suivante.** Vérifie que le nombre de commentaires extraits correspond au compteur initial — si ce n'est pas le cas, continue à paginer.

**Étape 2 — Analyse exhaustive**

Analyse **chacun des commentaires sans exception** exclusivement sous l'angle des **modèles LLM** mentionnés. Aucun commentaire ne doit être ignoré ou échantillonné.

Pour chaque modèle cité, synthétise :

- **Points forts** relevés par les commentateurs
- **Points faibles** ou limitations mentionnées
- **Cas d'usage Coding** : performance en génération de code, débogage, complétion, etc.
- **Cas d'usage Intelligence générale** : raisonnement, compréhension, tâches polyvalentes, etc.
- **Benchmarks mentionnés** : scores, classements ou comparaisons chiffrées associés à ce modèle

**Étape 3 — Synthèse**

Présente le résultat sous forme de **deux tableaux comparatifs markdown** :

1. **Tableau Coding** — colonnes : Modèle | Points forts | Points faibles | Benchmarks coding
2. **Tableau Intelligence générale** — colonnes : Modèle | Points forts | Points faibles | Benchmarks généralistes

Puis ajoute :

1. Une section **"Comparaison directe entre modèles"** synthétisant les confrontations explicites faites par les commentateurs (quel modèle bat quel autre, sur quoi, dans quel contexte), en distinguant coding vs intelligence générale
2. Une section **"Benchmarks en discussion"** listant les benchmarks cités, leur crédibilité perçue par la communauté, et les modèles qu'ils avantagent ou désavantagent — en précisant s'il s'agit de benchmarks coding (HumanEval, SWE-bench…) ou généralistes (MMLU, GPQA…)

Seuls les commentaires sans aucune mention de modèle spécifique sont à ignorer.
Ce qui m'a donné le résultat suivant : Analyse par Sonnet 4.6 des commentaires Hacker News à propos de Kimi K2.6.
Étape 4 : quelques semaines plus tard
Quelques semaines plus tard, je consulte toutes les sorties de modèle du mois dans l'article Nouvelles sur l'IA du site LinuxFR pour avoir une revue complète de l'écosystème.
Je découvre l'offre "Go" de OpenCode, « Go - Modèles de code à faible coût pour tous », qui semble être sortie le 25 février 2026 : https://xcancel.com/opencode/status/2026553685468135886.
Je n'ai rien trouvé à ce sujet sur Hacker News ni chez Simon Willison.
D'après ce que je comprends, alors que l'offre OpenCode Zen propose un point d'accès et une facturation unifiés du type Pay-As-You-Go, comme OpenRouter, OpenCode Go est une offre d'abonnement à 10 dollars par mois, selon les mêmes principes que les plans d'abonnement comme Anthropic Claude Pro, Max, etc.
L'offre OpenCode Go propose un accès uniquement à 3 LLMs, tous Open Weights et tous chinois : GLM-5, Kimi K2.5 et MiniMax M2.5.
À noter toutefois que OpenCode Go n'utilise aucun AI provider basé en Chine :
Privacy : The plan is designed primarily for international users, with models hosted in the US, EU, and Singapore for stable global access.
Contrairement à Anthropic (voir Est-ce qu'un abonnement Claude est réellement plus économique qu'un accès direct via l'API ?), OpenCode semble être transparent sur leur offre :
Usage limits
OpenCode Go includes the following limits:
- 5 hour limit — $12 of usage
- Weekly limit — $30 of usage
- Monthly limit — $60 of usage
Limits are defined in dollar value. This means your actual request count depends on the model you use. Cheaper models like MiniMax M2.5 allow for more requests, while higher-cost models like GLM-5 allow for fewer.
The table below provides an estimated request count based on typical Go usage patterns:
GLM-5 Kimi K2.5 MiniMax M2.5 requests per 5 hour 1,150 1,850 20,000 requests per week 2,880 4,630 50,000 requests per month 5,750 9,250 100,000 Estimates are based on observed average request patterns:
- GLM-5 — 700 input, 52,000 cached, 150 output tokens per request
- Kimi K2.5 — 870 input, 55,000 cached, 200 output tokens per request
- MiniMax M2.5 — 300 input, 55,000 cached, 125 output tokens per request
You can track your current usage in the console.
Comparaison des prix au million de tokens des plans Claude Max et OpenCode Go
Si je pars des prix listés sur l'offre OpenCode Zen et les prix de Sonnet 4.6 chez Anthropic, je peux dresser le tableau suivant, prix exprimé en millions de tokens :
| Model | Input | Output | Cached Read | Cached Write |
|---|---|---|---|---|
| MiniMax M2.5 | $0.30 | $1.20 | $0.06 | $0.375 |
| GLM 5 | $1.00 | $3.20 | $0.20 | - |
| Kimi K2.5 | $0.60 | $3.00 | $0.10 | - |
| Sonnet 4.6 | $3.00 | $15.00 | $0.30 | $3.75 |
Ensuite, j'ajuste ces prix avec les réductions offertes :
- par le plan Claude Max à $100 / mois, soit une réduction de 92,56 % (
(1345 - 100) / 1345 × 100 = 92,56 %) - par OpenCode Go, soit une réduction de 83,33 % (
(60 - 10) / 60 × 100 = 83,33 %)
Cela donne :
| Model | Input | Output | Cached Read | Cached Write |
|---|---|---|---|---|
| MiniMax M2.5 (avec offre Go) | $0.05 | $0.20 | $0.01 | $0.06 |
| GLM 5 (avec offre Go) | $0.16 | $0.53 | $0.03 | - |
| Kimi K2.5 (avec offre Go) | $0.10 | $0.50 | $0.01 | - |
| Sonnet 4.6 (avec offre Max) | $0.22 | $1.11 | $0.02 | $0.27 |
Sur la base du leaderboard SWE-bench Verified, je vais partir des hypothèses suivantes :
- Si je considère arbitrairement que GLM-5 est équivalent à Sonnet 4.6, alors l'offre OpenCode Go est légèrement moins cher que l'offre Claude Max
- Si je considère arbitrairement que Kimi K2.5 est équivalent à Sonnet 4.6, alors l'offre OpenCode Go est deux fois moins cher que l'offre Claude Max
#JaiDécidé de tester l'offre OpenCode Go sur un projet d'outil d'archivage à froid de conversations Mattermost en Golang que je coderai from scratch. Je compte réaliser deux versions de ce projet en parallèle : une version avec Sonnet 4.6 et l'autre avec les modèles de OpenCode Go.
Journal du jeudi 12 mars 2026 à 00:51
J'ai regroupé dans cette note les feedbacks que j'ai reçus à propos de ma note « Ma cartographie de l'écosystème LLM de 2026 ». En principe, je considère que mes notes éphémères sont immuables, mais je vais cette fois me permettre d'y apporter quelques corrections et d'en tracer les changements dans la présente note.
Généralement le grand public accède aux AI providers via leurs agents conversationnels web — ChatGPT, Claude, Le Chat, etc.
Les développeurs connectent leurs applications aux LLMs en passant par une Web API qui respecte généralement la convention OpenAI Chat Completions compatible API.
Un ami m'a dit : « Plus personne ne fait de "completion", on migre tous vers la Responses API. »
Jusqu'à présent, je ne m'étais jamais vraiment penché sur les spécifications d'API des AI providers. Je m'étais contenté d'utiliser des bibliothèques IA et des AI Frameworks, en supposant naïvement qu'des outils comme Aider, llm (cli), Open WebUI ou OpenCode s'appuyaient tous sur l'OpenAI Chat Completions compatible API, et que les nouvelles fonctionnalités — tools, prompt caching, etc. — s'intégraient simplement via de nouveaux champs dans le JSON. Après analyse, ce n'est pas le cas.
L'API "completions" est d'ailleurs désormais classée dans la section « Legacy » de la documentation d'OpenAI, et OpenAI cherche à imposer un nouveau standard avec Open Responses.
La lecture de l'article OpenAI Responses API vs. Chat Completions vs. Messages API confirme que trois formats d'API dominent aujourd'hui :
Today, three API formats dominate how AI Agents talk to LLMs:
- OpenAI's Chat Completions API — the de facto standard, universally supported
- OpenAI's Responses API — the newer, agent-oriented evolution with built-in tools and state management
- Anthropic's Messages API — Claude's native interface, with capabilities like extended thinking and prompt caching
Mistral AI, de son côté, semble encore s'appuyer sur l'OpenAI Chat Completions compatible API : son endpoint reste POST /v1/chat/completions.
Je comprends mieux maintenant, pourquoi des frameworks comme l'AI SDK proposent une implémentation par provider : chaque API diverge suffisamment pour nécessiter un adaptateur dédié 😯.
Je constate que OpenRouter proposes les trois API :
POST https://openrouter.ai/api/v1/chat/completions(lien vers la documentation)POST https://openrouter.ai/api/v1/responses(lien vers la documentation)POST https://openrouter.ai/api/v1/messages(lien vers la documentation)
C'est là l'un des intérêts d'OpenRouter : une abstraction unifiée au-dessus d'une multitude d'AI providers.
Voici la nouvelle version de mon paragraphe :
Généralement le grand public accède aux AI providers via leurs agents conversationnels web — ChatGPT, Claude, Le Chat, etc.
Les développeurs, eux, connectent leurs applications aux AI provider via une Web API : ces APIs respectaient initialement la convention OpenAI Chat Completions compatible API, mais les APIs ont progressivement divergé.
OpenAI cherche à imposer un standard commun avec Open Responses, tandis qu'Anthropic suit sa propre voie avec sa Messages API.
Mon ami m'a aussi fait remarquer :
« Tu utilises interchangeablement "LLM" et "le produit". Dans "De nombreux LLMs permettent de configurer des tools qui permettent au modèle d'appeler des fonctions externes", c'est pas le LLM lui-même, c'est le wrapper autour qui fait ça — le LLM s'en fiche. »
J'avais en effet manqué de rigueur à plusieurs endroits ; j'ai corrigé ma note.
Autre retour :
Dans ton histoire de middle tu peux aussi parler de prompt répétition : Prompt Repetition Improves Non-Reasoning LLMs.
Je ne connaissais pas cette astuce. J'ai ajouté cette phrase dans ma note :
« Jusqu'en 2025, répéter le prompt améliorait les résultats sur les modèles non-raisonnants. La question reste ouverte pour les LLMs de début 2026 : aucune étude publiée ne le confirme ni ne l'infirme à ce jour. »
Autre retour :
« Tes notes sur le prompt caching pourraient être plus précises. C'est utile pour plus de cas, mais il ne faut pas vraiment y penser comme à un cache software. »
En effet, je vois un autre usage évident : une application métier qui envoie de nombreuses requêtes différentes partageant toutes le même long system prompt. Plutôt que de retraiter ces tokens à chaque fois, le provider les garde en cache côté serveur.
J'ai ajouté ce paragraphe à ma note :
Ce système de prompt caching peut être utile aussi pour une application métier qui envoie de nombreuses requêtes différentes partageant toutes le même long system prompt. Plutôt que de retraiter ces tokens à chaque fois, le provider les garde en cache côté serveur. En fonction du contexte d'utilisation de l'application, il est possible de choisir plusieurs durées de cache, par exemple Anthropic propose 5min ou 1h.
À noter que le prompt caching n'est pas un cache logiciel classique au sens applicatif : c'est une optimisation transparente et implicite côté inférence, sans gestion de clés ni invalidation manuelle.
J'ai reçu le retour suivant d'une autre personne :
Je crois qu'en plus d'utiliser des Inferences Engines les AIs providers utilisent aussi des Workload Managers, Mistral avait mis https://github.com/SchedMD/slurm dans ses offres d'emploi compute
D'après ce que j'ai compris, Slurm Workload Manager est un projet qui a commencé en 2002, généralement utilisé sur des clusters High-performance computing (HPC) pour lancer de gros traitements de calcul, qui peuvent durer plusieurs heures ou même des jours, sur du matériel mutualisé entre plusieurs laboratoires de recherche.
J'ai trouvé cette mention dans une offre d'emploi qui semble aller dans le sens de cette hypothèse :
Now, it would be ideal if you also had:
• Experience with HPC workload managers (Slurm) and distributed storage systems (Lustre, Ceph)
Je pense que Mistral AI utilise Slurm pour leur offre Compute - built infrastructure for AI builders, qui permet à leurs clients de créer ou de fine-tuner des modèles.
Je ne pense pas que Slurm soit utilisé pour leur offre AI provider : c'est un ordonnanceur batch conçu pour des jobs longs et prévisibles, alors que l'inférence requiert une faible latence et la capacité à traiter des requêtes à la volée — deux patterns fondamentalement différents. Par conséquent, je n'ai pas inclus ce sujet dans ma cartographie de l'écosystème LLM de 2026.
Une troisième personne m'a fait des retours :
Il y un concept important que tu ne cites pas, c'est l'embedding (vectorisation).
En effet, j'ai oublié d'en parler. Je viens d'ajouter le paragraphe suivant dans ma note :
Pour écrire des données dans une base de données vectorielle, il est nécessaire de passer par une étape de vectorisation en utilisant un modèle d'embedding, comme par exemple Cohere Embed v3 multilingual ou text-embedding-3-large d'OpenAI. La vectorisation est également requise au moment d'effectuer la requête dans la base de données — avec impérativement le même modèle que celui utilisé lors de l'indexation.
Les modèles d'embedding sont nettement plus légers et économiques qu'un LLM. Ils peuvent être exécutés sur CPU pour des usages courants, sans nécessiter de GPU.
Cette même personne m'a aussi partagé :
je suis dans une phase d'exploration du Specs Driven Development.
Je connais la méthode, bien que je n'aie jamais remarqué qu'elle portait un nom : Specs Driven Development (SDD). Je pense que j'ai plus ou moins suivi cette méthode dans le fichier AGENTS.md de mon projet qemu-compose.
Je prépare très souvent mes specs quand je suis dans le métro ou quand je marche. Je réalise que mes notes publiques de projets me sont de plus en plus utiles comme base de spécification à soumettre aux LLMs, comme par exemple celle-ci : Première description du gestionnaire de projet de mes rêves.
J'ai fait quelques recherches sur le sujet du Specs Driven Development et je suis tombé sur le thread Hacker News « Spec-Driven Development: The Waterfall Strikes Back » ainsi que sur la section « Do you do spec-driven development? » d'un billet de blog. La pratique ne semble pas faire consensus. Je n'ai pas encore d'avis tranché sur la question.
Au passage, j'ai découvert ici deux autres noms de concepts : Verified Spec-Driven Development (VSDD) et Verification-Driven Development (VDD).
Je n'ai pas ajouté ces informations dans ma note de cartographie.
En rédigeant cette note, je me suis rendu compte que j'avais oublié quelques sujets.
J'ai ajouté un paragraphe sur le reranking :
Depuis 2022, les RAG avancés suivent le pattern "Retrieve, rerank, Generate". L'étape de reranking peut être effectuée via deux méthodes :
- Des modèles spécialisés de reranking, comme Cohere Rerank, ou Voyage AI Rerankers, qui sont légers, rapides. Ils prennent en entrée la
queryet la liste de documents candidats et produisent un score de pertinence.- Ou directement des LLMs généralistes, potentiellement plus précis sur des domaines spécifiques non couverts par les données d'entraînement des modèles de reranking, mais plus coûteux en latence et en tokens.
J'ai aussi ajouté un paragraphe sur chain-of-thought (CoT) :
La technique d'activation de raisonnement chain-of-thought (CoT) par prompting sur les LLMs classiques est connue depuis 2022.
Depuis o1 d'OpenAI en septembre 2024, les modèles sont entraînés spécifiquement pour le raisonnement via RL, on parle de Reasoning Language Model (RLM). L'utilisateur peut contrôler le niveau d'effort de raisonnement via le paramètreeffort.
Les modèles Claude Sonnet et Opus4.xadaptent dynamiquement l'effort de raisonnement en fonction de la complexité de la tâche — Anthropic nomme cela hybrid reasoning.
Et pour finir, j'ai ajouté un paragraphe à propos des API de type "Batch" :
La plupart des AI providers proposent une API asynchrone de type "batch" — exemples :
POST /v1/messages/batchespour Anthropic,POST /batchespour OpenAI, ouPOST /v1/batch/jobspour Mistral AI.
Ces APIs sont conçues pour des tâches non temps-réel, avec un délai de traitement pouvant aller jusqu'à 24h, en échange d'une réduction de 50% sur le tarif standard. Elles disposent par ailleurs de rate limits séparés des quotas synchrones, ce qui permet de soumettre de gros volumes sans impacter les appels temps-réel.
Serveur MCP web fetch local sous Claude Desktop pour contourner les blocages IP de certains sites
Mon installation de Claude Desktop sous Fedora était principalement motivée par l'exécution locale du tool "Web fetch tool" d'Anthropic, afin de contourner le blocage des IP d'Anthropic par certains sites web.
Après avoir passé en revue une demi-douzaine de serveurs MCP de type « web fetch », j'ai retenu zcaceres/fetch-mcp, implémenté en Javascript, qui, après quelques heures d'utilisation, semble bien fonctionner.
Voici mon fichier ~/.config/Claude/claude_desktop_config.json après configuration du serveur MCP :
{
  "mcpServers": {
    "fetch": {
      "command": "npx",
      "args": ["mcp-fetch-server"],
      "env": {
        "DEFAULT_LIMIT": "0"
      }
    }
  },
  "isUsingBuiltInNodeForMcp": false,
  "isDxtAutoUpdatesEnabled": false,
  "preferences": {
    "coworkScheduledTasksEnabled": true,
    "ccdScheduledTasksEnabled": true,
    "coworkWebSearchEnabled": true,
    "sidebarMode": "chat"
  }
}
zcaceres/fetch-mcp supporte différents types de formats de fetching :
All tools accept the following common parameters:
- fetch_html — Fetch a website and return its raw HTML content.
- fetch_markdown — Fetch a website and return its content converted to Markdown.
- fetch_txt — Fetch a website and return plain text with HTML tags, scripts, and styles removed.
- fetch_json — Fetch a URL and return the JSON response.
- fetch_readable — Fetch a website and extract the main article content using Mozilla Readability, returned as Markdown. Strips navigation, ads, and boilerplate. Ideal for articles and blog posts.
- fetch_youtube_transcript — Fetch a YouTube video's captions/transcript. Uses
yt-dlpif available, otherwise extracts directly from the page. Accepts an additionallangparameter (default:"en") to select the caption language.
C'est le LLM qui choisit quel tool utiliser. J'ai demandé à Claude Sonnet 4.6 comment il effectuait son choix : par défaut, il utilise fetch_markdown ; lorsqu'il sait qu'un site contient des publicités, une sidebar, etc. — généralement les sites de presse —, il utilise fetch_readable.
J'ai observé que les tools fetch_markdown, fetch_readable et fetch_json fonctionnent bien, mais fetch_youtube_transcript n'a pas fonctionné chez moi. D'après les logs, ce tool semble contenir un bug. #JaimeraisUnJour essayer de le corriger.