
Recherche
Filtre actif, cliquez pour en enlever un tag :
Cliquez sur un tag pour affiner votre recherche :
Résultat de la recherche (27 notes) :
Journal du dimanche 19 juillet 2026 à 14:36
Je viens de rédiger Projet 38 - "POC champ de recherche enrichi avec CodeMirror et conceal".
Premier test minimaliste de Promptfoo avec le provider OpenCode SDK
Depuis au moins novembre 2025, je cherche à rédiger mes prompts, mes fichiers AGENTS.md, mes fichiers SKILLS.md — et plus largement mon harness OpenCode — avec une méthode rigoureuse et contrôlée. J'ai découvert dans cette issue le nom du mécanisme que j'essaie de mettre en place : agent-eval-harness, terme plutôt simple et explicite.
En février, je disais :
Je compte créer un playground Promptfoo connecté à plusieurs modèles LLM dans les semaines à venir.
Quelques mois plus tard, j'ai enfin implémenté un premier POC utilisant Promptfoo couplé avec le provider OpenCode SDK : https://github.com/stephane-klein/opencode-promptfoo-poc.
Cette première itération est volontairement minimaliste. J'ai testé :
- 3 LLMs (dans 2 configurations chacune)
- 3 cas de test
L'intégralité de mon évaluation tient dans un seul fichier promptfooconfig.yaml :
# yaml-language-server: $schema=https://promptfoo.dev/config-schema.json
description: "Hello World - minimal test"
providers:
  - id: opencode:sdk
    label: "without-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "without-agent-minimax-m2.7"
    config:
      provider_id: opencode-go
      model: minimax-m2.7
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "without-agent-deepseek-v4-flash"
    config:
      provider_id: opencode-go
      model: deepseek-v4-flash
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "with-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/

  - id: opencode:sdk
    label: "with-agent-minimax-m2.7"
    config:
      provider_id: opencode-go
      model: minimax-m2.7
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/

  - id: opencode:sdk
    label: "with-agent-deepseek-v4-flash"
    config:
      provider_id: opencode-go
      model: deepseek-v4-flash
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/

prompts:
  - "Translate the following English text to {{language}}: {{input}}"

tests:
  - vars:
      language: French
      input: Hello world
    assert:
      - type: contains-all
        value:
          - "Bonjour"
          - "monde"

  - vars:
      language: Spanish
      input: Where is the library?
    assert:
      - type: contains-any
        value:
          - "Donde esta la biblioteca"
    providers:
      - "with-agent*"

  - vars:
      language: Spanish
      input: Where is the library?
    assert:
      - type: not-contains-any
        value:
          - "Donde esta la biblioteca"
    providers:
      - "without-agent*"
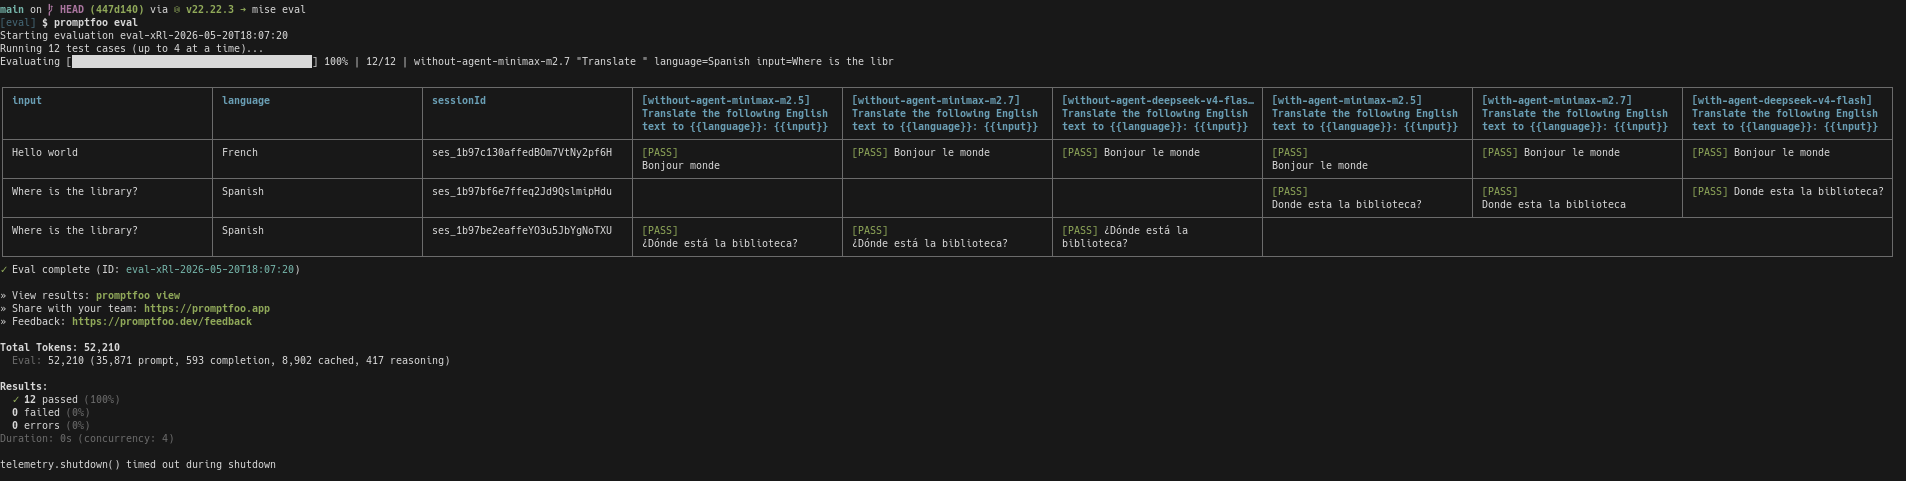
L'exécution de promptfoo eval donne ceci :
Et voici ce qu'affiche promptfoo viewer dans un browser :
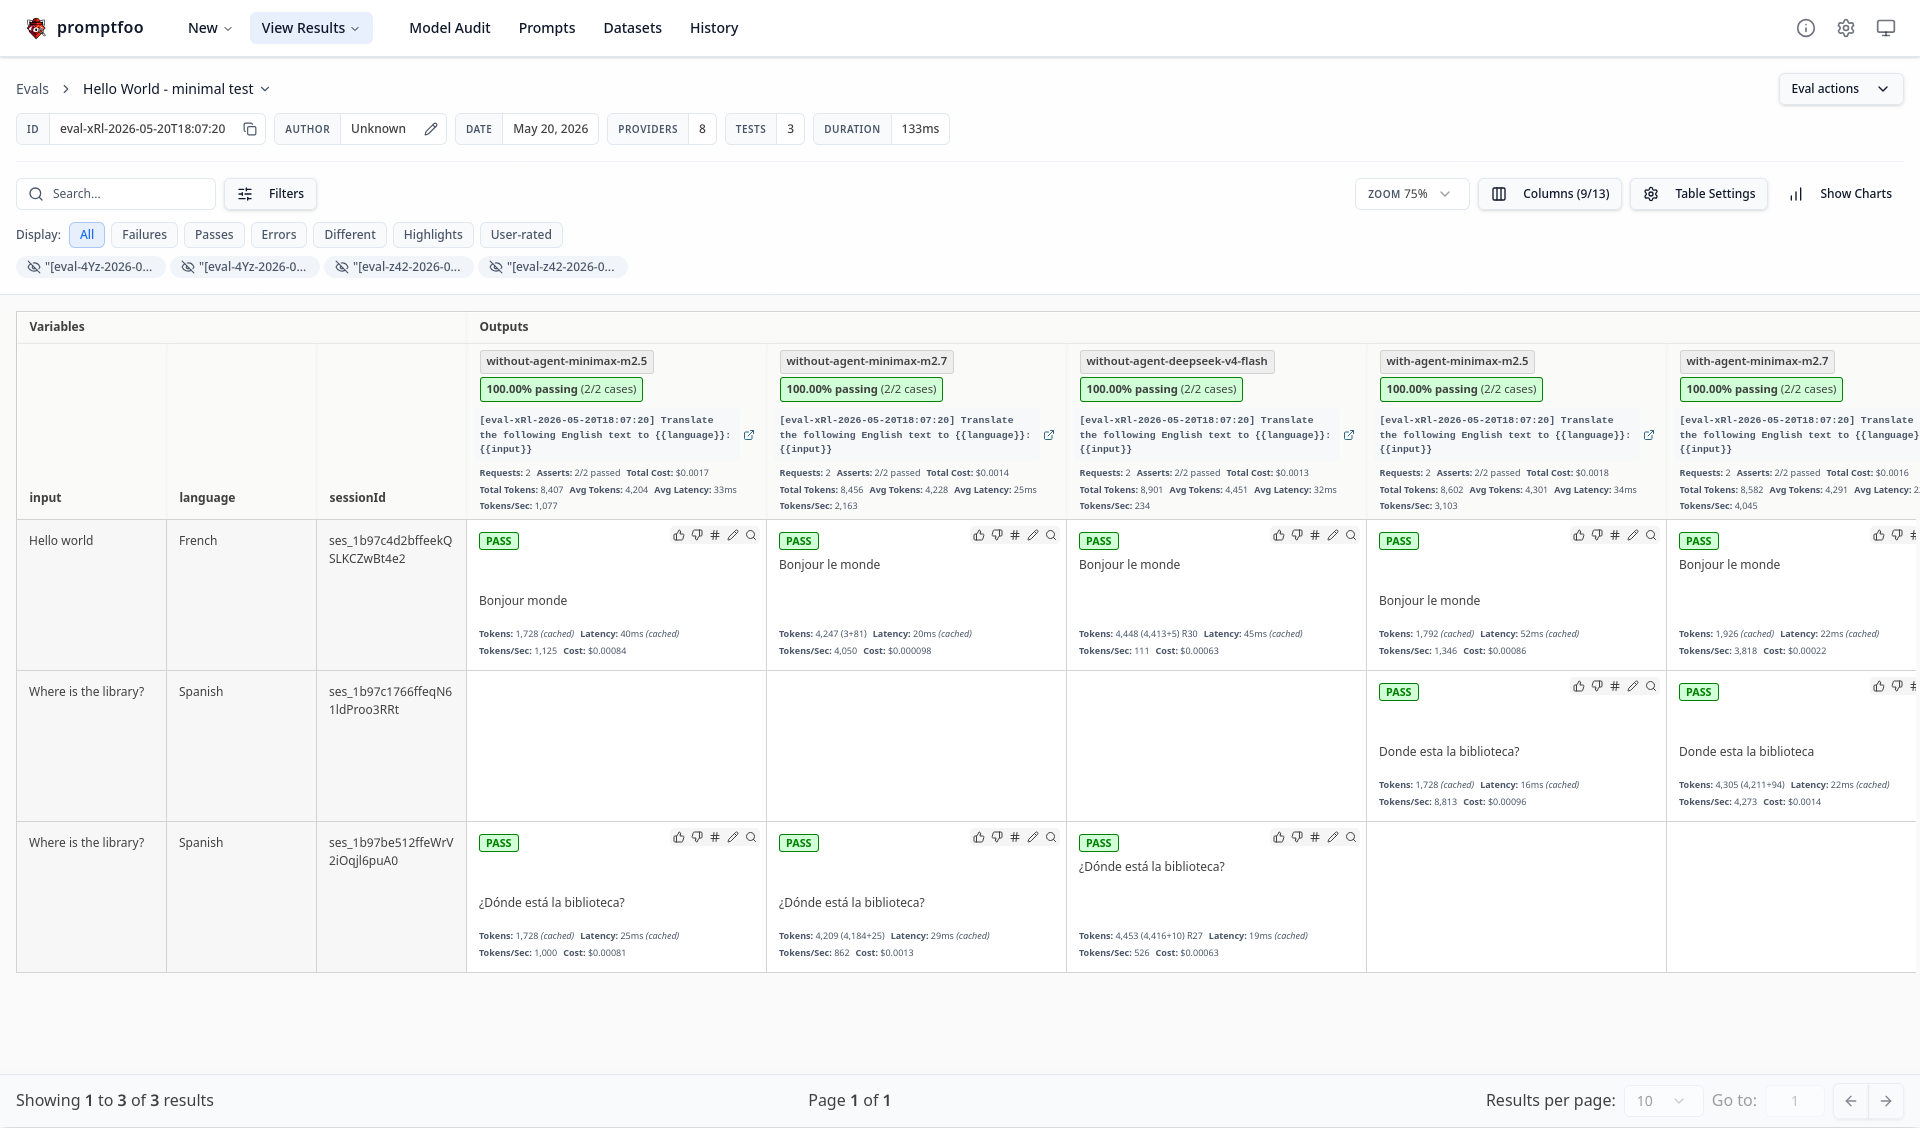
Dans mes tests, j'ai mis en œuvre uniquement contains-all et contains-any, mais Promptfoo propose beaucoup d'autres « Deterministic metrics ».
Promptfoo propose aussi de nombreuses assertions effectuées par des modèles de langage, les « Model-graded metrics », dont la plupart peuvent être qualifiées de LLM-as-a-Judge. Je ne les ai pas encore testées.
Je n'ai pas non plus exploré l'évaluation de « Chat conversations / threads ». Par ailleurs, en examinant la documentation du provider OpenCode SDK, j'ai constaté ce qui me semble être une limitation : il n'est probablement pas possible de changer d'agent dans un thread, c'est-à-dire d'alterner entre le mode plan et le mode build, comme on le ferait dans un usage normal de OpenCode.
Mais après réflexion, il me semble que cette limitation n'est pas importante. Dans un test d'évaluation, chaque cas est un appel unique à l'agent, avec l'historique complet de la conversation fourni en contexte — il n'est pas nécessaire de simuler un flux interactif multi-tours avec alternance d'agents.
Dans ce POC, je configure le provider OpenCode SDK pour qu'il utilise le dossier de configuration ./config/opencode du repository, afin que le harness évalué soit précisément celui qui est versionné, et afin de ne pas subir de perturbation par la configuration OpenCode globale.
Quand j'ai démarré ce POC, j'ai essayé d'indiquer différentes configurations OpenCode au niveau des tests, pour tester différents fichiers AGENTS.md. Mais j'ai constaté que la configuration OpenCode ne peut être définie qu'une seule fois, ici, via une variable d'environnement XDG_CONFIG_HOME.
J'ai mis un certain temps à réaliser que je pouvais procéder autrement, en plaçant les fichiers AGENTS.md dans différents working_dir. Les working_dir se configurent au niveau des providers, voici deux exemples :
  - id: opencode:sdk
    label: "without-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir1/

  - id: opencode:sdk
    label: "with-agent-minimax-m2.5"
    config:
      provider_id: opencode-go
      model: minimax-m2.5
      apiKey: "{{env.OPENCODE_API_KEY}}"
      working_dir: ./workdir2/
Cela permet de charger et de tester ./workdir1/AGENTS.md ou ./workdir2/AGENTS.md. Il est possible d'utiliser la même méthode pour évaluer différents SKILLS.md.
Pour le moment, je ne sais pas encore si Promptfoo est un bon outil pour mettre au point mon harness.
Avant de poursuivre mes tests de harness engineering avec Promptfoo, j'aimerais tester agent-catalog-eval pour voir si cet outil serait plus simple à mettre en œuvre.
Publication du projet 33 - "POC serveur Git HTTP qui injecte du contenu dans OpenSearch"
Je viens de terminer le "Projet 33 - "POC serveur Git HTTP qui injecte du contenu dans OpenSearch"" en 25h.
Si j'inclus le travail préliminaire du Projet 32 - "POC serveur Git HTTP avec exécution de scripts au push", cela représente 34h au total.
Voici le repository avec le résultat final : https://github.com/stephane-klein/poc-content-repository-git-to-opensearch.
J'ai réussi à implémenter preque tous les éléments que j'avais prévu :
- Un serveur Git HTTP supportant les opérations push et pull
- Après chaque git push, injection automatique des données reçues vers une base de données OpenSearch
- Intégration d'un système de job queue minimaliste qui permet de traiter les tâches d'importation des données Git vers OpenSearch de manière asynchrone. Cela permet entre autres de rendre l'opération git push non bloquante.
- Le modèle de données doit permettre l'accès au contenu de plusieurs branches.
- Upload des fichiers binaires vers un serveur Minio tout concervant leurs metadata (chemin, branche, etc) dans OpenSearch.
- La suppression d'une branche ou d'un commit doit aussi supprimer les données présentes dans OpenSearch et Minio.
- Utilisation de la librairie nodegit.
Le seul élément que je n'ai pas testé est celui-ci :
- L'accès aux données via l'API de OpenSearch ne doit pas être perturbé pendant les phases d'importation de données depuis Git.
Je précise d'emblée que l'implémentation de la fonctionnalité d'exploration web du content repository manque actuellement d'élégance.
Les dossiers suivants contiennent une quantité importante de code dupliqué :
src/routes/[...pathname]/,src/routes/branches/[branch_name]/[...pathname]/- et
src/routes/r/[revision]/[...pathname]/
src/routes
├── branches
│   ├── [branch_name]
│   │   ├── history
│   │   │   ├── +page.server.js
│   │   │   └── +page.svelte
│   │   ├── +page.server.js
│   │   ├── +page.svelte
│   │   └── [...pathname]
│   │       ├── +page.server.js
│   │       └── +page.svelte
│   ├── +page.server.js
│   └── +page.svelte
├── +page.server.js
├── +page.svelte
├── [...pathname]
│   ├── +page.server.js
│   ├── +page.svelte
│   └── raw
│       └── +server.js
└── r
    ├── +page.server.js
    └── [revision]
        ├── history
        │   ├── +page.server.js
        │   └── +page.svelte
        ├── +page.server.js
        ├── +page.svelte
        └── [...pathname]
            ├── +page.server.js
            ├── +page.svelte
            └── raw
Pour le moment, je n'ai pas encore trouvé comment éviter cette duplication de manière élégante.
J'ai pensé à 3 approches pour améliorer cette implémentation :
- Factoriser la logique de query des fichiers
+page.server.jsdans une fonction partagée. - Migrer complètement ces pages d'exploration vers
src/hooks.server.js(avec les Server hooks de SvelteKit ).
Comme cette partie n'était pas au cœur du projet, j'ai préféré ne pas y investir davantage de temps.
Dans ce projet, j'ai utilisé pour la première fois OpenSearch, le fork de Elasticsearch. J'ai dû faire quelques adaptations par rapport à Elasticsearch mais rien de vraiment complexe.
J'ai utilisé la librairie @opensearch-project/opensearch avec succès, bien aidé par Claude Sonnet 4 pour écrire mes query OpenSearch.
J'aimerais mieux maîtriser l'api de OpenSearch et Elasticsearch, mais je ne les utilise pas suffisamment.
Cette dépendance à un LLM pour écrire ces requêtes me contrarie, je me sens prolétaire et j'ai le sentiment de perdre l'habitude de l'effort. Je pense à cette recherche "Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task" et cela me préoccupe.
J'ai développé un système de job queue minimaliste en NodeJS avec une persistance basée sur des fichiers json simples : src/lib/server/job-queue.js.
Ma recherche avec Claude Sonnet 4 n'a révélé aucune librairie minimaliste existante qui se contente de fichiers pour la persistance.
Cette implémentation me paraît suffisamment robuste pour répondre à l'objectif que je me suis fixé.
J'ai implémenté la fonction importRevision avec nodegit pour parcourir toutes les entrées d'une révision Git du repository et les importer dans OpenSearch.
Claude Sonnet 4 m'a encore été d'une grande aide, me permettant d'éviter de passer trop de temps dans la documentation d'API de NodeGit, qui reste assez minimaliste.
Mon expérience de 2015 avec git2go sur le projet CmsHub avait été nettement plus laborieuse, à l'époque pré-LLM. Cela dit, j'avais quand même réussi. 🙂
L'implémentation du endpoint /src/routes/post_recieve_hook_url/+server.js n'a pas été très difficile.
J'ai réussi à implémenter le support de git push --force sans trop de difficulté.
Qu'est-ce qui t'a amené à choisir OpenSearch pour ce projet, plutôt qu'un autre type de base de données ?
Suite à de multiples expérimentations durant l'été 2024 (voir 2024-08-17_1253 ou Projet 5), j'ai sélectionné Elasticsearch comme moteur de base de données pour sklein-pkm-engine.
La puissance du moteur de query d'Elasticsearch m'a vraiment séduit, comme on peut le voir dans cette implémentation. Ça me paraît beaucoup plus souple que ce que j'avais développé avec postgres-tags-model-poc.
J'ai donc décidé d'explorer les possibilités d'Elasticsearch ou de son fork OpenSearch comme moteur de base de données de content repository. J'ai décidé d'en faire mon option par défaut tant que je ne rencontre pas d'obstacle majeur ou de point bloquant.
La partie où j'ai le plus hésité concerne le choix du modèle de données OpenSearch pour stocker efficacement le versioning Git.
J'ai décidé d'utiliser deux indexes distincts : files et commits :
await client.indices.create({
	index: "files",
	body: {
		mappings: {
			properties: {
				content: {
					type: "text"
				},
				mimetype: {
					type: 'keyword'
				},
				commits: {
					type: 'object',
					dynamic: 'true'
				}
			}
		}
	}
});
await client.indices.create({
	index: "commits",
	body: {
		mappings: {
			properties: {
				index: {
					type: 'integer'
				},
				time: {
					type: 'date',
					format: 'epoch_second'
				},
				message: {
					type: "text"
				},
				parents: {
					type: 'keyword'
				},
				entries: {
					type: 'object',
					dynamic: 'true',
				},
				branches: {
					type: 'keyword'
				}
			}
		}
	}
});
Après import des données depuis le repository dummy-content-repository-solar-system, voici ce qu'on trouve dans files :
[
  {
    _index: 'files',
    _id: '2f729046cb0f02820226c1183aa04ab20ceb857d',
    _score: 1,
    _source: {
      commits: {
        '4da69e469145fe5603e57b9e22889738d066a5e2': 'mars.md',
        d9bffc3da0c91366dda54fefa01383b109554054: 'mars.md'
      },
      mimetype: 'text/markdown; charset=utf-8'
    }
  },
  {
    _index: 'files',
    _id: '1be731144f49282c43b5e7827bef986a52723a71',
    _score: 1,
    _source: {
      commits: {
        '4da69e469145fe5603e57b9e22889738d066a5e2': 'venus.md',
        d9bffc3da0c91366dda54fefa01383b109554054: 'venus.md'
      },
      mimetype: 'text/markdown; charset=utf-8'
    }
  },
  {
    _index: 'files',
    _id: 'ccc921b7a66f18e98f4887189824eefe83c7e0b3',
    _score: 1,
    _source: {
      commits: {
        '4da69e469145fe5603e57b9e22889738d066a5e2': 'terre/index.md',
        a9272695d179e70cca15e89f1632b8fb76112dca: 'terre/index.md',
        d9bffc3da0c91366dda54fefa01383b109554054: 'terre/index.md'
      },
      mimetype: 'text/markdown; charset=utf-8'
    }
  },
  {
    _index: 'files',
    _id: '153d9d6e9dfedb253c624c9f25fbdb7d8691a042',
    _score: 1,
    _source: {
      commits: {
        '4da69e469145fe5603e57b9e22889738d066a5e2': 'terre/lune.md',
        a9272695d179e70cca15e89f1632b8fb76112dca: 'terre/lune.md',
        d9bffc3da0c91366dda54fefa01383b109554054: 'terre/lune.md'
      },
      mimetype: 'text/markdown; charset=utf-8'
    }
  },
  {
    _index: 'files',
    _id: '97ef5b8f52f85c595bf17fac6cbec856ce80bd4a',
    _score: 1,
    _source: {
      commits: { '4da69e469145fe5603e57b9e22889738d066a5e2': 'terre/terre.jpg' },
      mimetype: 'image/jpeg'
    }
  }
]
et voici un exemple de contenu de commits :
[
  {
    _index: 'commits',
    _id: '7ce2ab6f8d29fec0348342d95bfe71899dcb44fa',
    _score: 1,
    _source: { index: 1, time: 1757420855, branches: [ 'main' ], parents: [] }
  },
  {
    _index: 'commits',
    _id: '4da69e469145fe5603e57b9e22889738d066a5e2',
    _score: 1,
    _source: {
      entries: {
        'venus.md': {
          oid: '1be731144f49282c43b5e7827bef986a52723a71',
          contentType: 'text/markdown; charset=utf-8'
        },
        'terre/lune.md': {
          oid: '153d9d6e9dfedb253c624c9f25fbdb7d8691a042',
          contentType: 'text/markdown; charset=utf-8'
        },
        'mars.md': {
          oid: '2f729046cb0f02820226c1183aa04ab20ceb857d',
          contentType: 'text/markdown; charset=utf-8'
        },
        'terre/terre.jpg': {
          oid: '97ef5b8f52f85c595bf17fac6cbec856ce80bd4a',
          contentType: 'image/jpeg'
        },
        'terre/index.md': {
          oid: 'ccc921b7a66f18e98f4887189824eefe83c7e0b3',
          contentType: 'text/markdown; charset=utf-8'
        }
      },
      index: 4,
      time: 1757429173,
      branches: [ 'main' ],
      parents: [ 'd9bffc3da0c91366dda54fefa01383b109554054' ]
    }
  },
  {
    _index: 'commits',
    _id: 'd9bffc3da0c91366dda54fefa01383b109554054',
    _score: 1,
    _source: {
      entries: {
        'venus.md': {
          oid: '1be731144f49282c43b5e7827bef986a52723a71',
          contentType: 'text/markdown; charset=utf-8'
        },
        'terre/lune.md': {
          oid: '153d9d6e9dfedb253c624c9f25fbdb7d8691a042',
          contentType: 'text/markdown; charset=utf-8'
        },
        'mars.md': {
          oid: '2f729046cb0f02820226c1183aa04ab20ceb857d',
          contentType: 'text/markdown; charset=utf-8'
        },
        'terre/index.md': {
          oid: 'ccc921b7a66f18e98f4887189824eefe83c7e0b3',
          contentType: 'text/markdown; charset=utf-8'
        }
      },
      index: 3,
      time: 1757421171,
      branches: [ 'main' ],
      parents: [ 'a9272695d179e70cca15e89f1632b8fb76112dca' ]
    }
  },
  {
    _index: 'commits',
    _id: 'a9272695d179e70cca15e89f1632b8fb76112dca',
    _score: 1,
    _source: {
      entries: {
        'terre/lune.md': {
          oid: '153d9d6e9dfedb253c624c9f25fbdb7d8691a042',
          contentType: 'text/markdown; charset=utf-8'
        },
        'terre/index.md': {
          oid: 'ccc921b7a66f18e98f4887189824eefe83c7e0b3',
          contentType: 'text/markdown; charset=utf-8'
        }
      },
      index: 2,
      time: 1757420956,
      branches: [ 'main' ],
      parents: [ '7ce2ab6f8d29fec0348342d95bfe71899dcb44fa' ]
    }
  }
]
Ensuite, je mise beaucoup sur la puissance du moteur de requête d'OpenSearch pour récupérer efficacement les données à afficher.
Voici l'exemple de src/routes/[...pathname]/+page.server.js qui permet d'afficher le contenu d'un fichier de la branche main.
Première requête :
const responseOid = await client().search({
	index: 'commits',
	body: {
		query: {
			bool: {
				must: [
					{
						term: {
							branches: 'main'
						}
					},
					{
						exists: {
							field: `entries.${params.pathname}`
						}
					}
				]
			}
		},
		_source: [`entries.${params.pathname}`]
	}
});
Seconde requête qui utilise la réponse de la première :
const responseFile = await client().get({
	index: 'files',
	id: responseOid.body.hits.hits[0]._source.entries[params.pathname].oid,
	_source: ['content', 'mimetype']
});
Basé sur l'expérience de ce projet, je souhaite améliorer sklein-pkm-engine pour permettre la mise à jour de notes.sklein.xyz avec mes données locales uniquement via git push, sans avoir besoin d'installer quoi que ce soit sur ma workstation.
Je pense que cette implémentation sera bien plus simple que le Projet 33, car je ne prévois pas d'inclure le support dans un premier temps. Peut-être que je supporterai les branches dans un second temps.
J'ai terminé poc-svelteki-web-notification
Je viens de terminer un POC nommé poc-sveltekit-web-notification , qui m'a permis d'apprendre à implémenter la fonctionnalité Push API dans une PWA.
Quelques ressources qui m'ont été utiles :
- Push API
- Web Workers API
- Using VAPID with WebPush
- Cet exemple de MDN Web Docs :
push-subscription-management.
Je n'ai aucune idée de pourquoi ce repository est archivé et par quoi il a été remplacé. - J'ai lu en partie Voluntary Application Server Identification (VAPID) for Web Push - RFC 8292
- SvelteKit - Service workers
Ma prochaine étape : intégrer cette fonctionnalité dans gibbon-replay.
Journal du jeudi 29 mai 2025 à 00:04
Dans ma note Bilan de poc-sveltekit-custom-server je finis par ceci :
La suite...
Je souhaite rédiger cette note en anglais et la publier sur https://github.com/sveltejs/kit/discussions et https://old.reddit.com/r/sveltejs/ afin :
- d'avoir des retours d'expérience
- de découvrir des méthodes alternatives
- et partager la méthode que j'ai utilisée, qui sera peut-être utile à d'autres développeurs Svelte 🙂
Voici ce que je viens de publier :
- https://github.com/sveltejs/kit/discussions/13841
- https://old.reddit.com/r/sveltejs/comments/1kxtz1u/custom_sveltekit_server_dev_production_with/
2025-05-29 : voir J'ai découvert la fonctionnalité SvelteKit Shared hooks init
Bilan de poc-sveltekit-custom-server
Contexte et objectifs
Dans le projet gibbon-replay, j'ai besoin d'exécuter une tâche une fois par jour pour supprimer des anciennes sessions.
gibbon-replay utilise une base de données SQLite qui ne dispose pas nativement de fonctionnalité de type Time To Live, comme on peut trouver dans Clickhouse.
SQLite ne propose pas non plus d'équivalent à pg_cron — ce qui est tout à fait normal étant donnée que SQLite est une librairie et non pas un service à part entière.
Le projet gibbon-replay est un monolith (j'aime les monoliths !) et je souhaite conserver ce choix.
Face à ces contraintes, une solution consiste à intégrer une solution comme Cron for Node.js directement dans l'application gibbon-replay.
Je pense que je dois implémenter cela dans un SvelteKit Custom Server, ce qui me permettrait d'exécuter cette tâche de purge à intervalles réguliers tout en conservant l'architecture monolithique.
Il y a quelques jours, j'ai décidé de tester cette idée dans un POC nommé : poc-sveltekit-custom-server.
J'ai aussi décidé d'expérimenter un objectif supplémentaire dans ce POC : lancer la migration du modèle de données dès le lancement du monolith et non plus lors de la première requête HTTP reçue par le service.
Enfin, je souhaitais ne pas dégrader l'expérience développeur (DX), c'est à dire, je souhaitais pouvoir continuer à simplement utiliser :
$ pnpm run dev
ou
$ pnpm run build
$ pnpm run preview
sans différence avec un projet SvelteKit "vanilla".
Résultats du POC et enseignements
Tout d'abord, le POC fonctionne parfaitement 🙂, sans dégrader l'expérience développeur (DX), qui ressemble à ceci :
$ mise install
$ pnpm install
$ pnpm run load-seed-data
Start data model migration…
Data model migration completed
Start load seed data...
seed data loaded
Lancement du projet en mode développement :
$ pnpm run dev
Start data model migration…
Data model migration completed
Server started on http://localhost:5173 in development mode
Lancement du projet "buildé" :
$ pnpm run build
$ pnpm run preview
Start data model migration…
Data model migration completed
Server started on http://localhost:3000 in production mode
Les migrations et les données "seed.sql" se trouvent dans le dossier /sqls/.
Le SvelteKit Custom Server est implémenté dans le fichier src/server.js et il ressemble à ceci :
import express from 'express';
import cron from 'node-cron';
import db, { migrate } from '@lib/server/db.js';

const isDev = process.env.ENV !== 'production';

migrate(); // Lancement de la migration du modèle de donnée dès de lancement du serveur

// Configuration d'une tâche exécuté toutes les heures
cron.schedule(
    '0 * * * *',
    async () => {
        console.log('Start task...');
        console.log(db().query('SELECT * FROM posts'));
        console.log('Task executed');
    }
);

async function createServer() {
    const app = express();

    ...
Personnellement, je trouve cela simple et minimaliste.
Point de difficulté
SvelteKit utilise des "module alias", comme par exemple $lib.
Problème, par défaut, ces "module alias" ne sont pas configurés lors de l'exécution de node src/server.js.
Pour me permettre d'importer dans src/server.js des modules de src/lib/server/* comme :
import db, { migrate } from '@lib/server/db.js';
j'ai utilisé la librairie esm-module-alias.
Ceci complexifie un peu le projet, j'ai dû configurer ceci dans /package.json :
{
    "scripts": {
        "dev": "ENV=development node --loader esm-module-alias/loader --no-warnings src/server.js",
        "preview": "ENV=production node --loader esm-module-alias/loader --no-warnings build/server.js",

    ...

	"aliases": {
        "@lib": "src/lib/"
    }
}
- ajout de
--loader esm-module-alias/loader --no-warnings - et la section
aliases
Et dans /vite.config.js :
export default defineConfig({
    plugins: [sveltekit()],
    resolve: {
        alias: {
          '@lib': path.resolve('./src/lib')
        }
    }
});
- ajout de
alias
Le fichier src/server.js contient du code spécifique en fonction de son contexte d'exécution ("dev" ou "buildé") :
    if (isDev) {
        const { createServer: createViteServer } = await import('vite');

        const vite = await createViteServer({
            server: { middlewareMode: true },
            appType: 'custom'
        });

        app.use(vite.middlewares);
    } else {
        const { handler } = await import('./handler.js');
        app.use(handler);
    }
En mode "dev" il utilise Vite et en "buildé" il utilise le fichier build/handler.js généré par SvelteKit build en mode SSR.
Le fichier src/server.js est copié vers le dossier /build/ lors de l'exécution de pnpm run build.
J'ai testé le bon fonctionnement du POC dans un container Docker.
J'ai intégré au projet un deployment-playground : https://github.com/stephane-klein/poc-sveltekit-custom-server/tree/main/deployment-playground.
La suite...
Je souhaite rédiger cette note en anglais et la publier sur https://github.com/sveltejs/kit/discussions et https://old.reddit.com/r/sveltejs/ afin :
- d'avoir des retours d'expérience
- de découvrir des méthodes alternatives
- et partager la méthode que j'ai utilisée, qui sera peut-être utile à d'autres développeurs Svelte 🙂
Update du 2025-05-29 à 00:07 - Je viens de publier ceci :
- https://github.com/sveltejs/kit/discussions/13841
- https://old.reddit.com/r/sveltejs/comments/1kxtz1u/custom_sveltekit_server_dev_production_with/?
2025-05-29 : voir J'ai découvert la fonctionnalité SvelteKit Shared hooks init
Journal du vendredi 11 avril 2025 à 10:24
Suite à 2025-04-10_2034, je viens de créer le Projet 27 - "Créer un POC de pg_back".
Journal du jeudi 09 janvier 2025 à 13:13
Nouvelle #iteration sur le Projet 17 - Créer un POC de création d'une app smartphone avec Capacitor.
Je viens de push le commit feat(android): implemented webview and configured deeplinks. J'ai passé en tout, 11 heures sur cette itération.
Je souhaite, dans cette note de type DevLog, présenter les difficultés et les erreurs rencontrées dans cette itération.
Étape 1 : mise en place d'un dummy website totalement statique
The Capacitor application in this POC displays the content of a demonstration website, with the HTML content located in the
./dummy-website/folder.
This website is served by an HTTP Nginx server, launched usingdocker-compose.yml.
Pour faire très simple, j'ai choisi de créer un faux site totalement statique, qui sera affiché dans une webview de l'application smartphone.
Ce site contient juste 2 pages HTML ; celui-ci est exposé par un serveur HTTP nginx, lancé via un docker-compose.yml.
Étape 2 : Expose dummy website on Internet
En première étape, j'ai dû mettre en place une méthode pour facilement exposer sur Internet un dummy website lancé localement :
Expose dummy website on Internet
Why?
The Android and iOS emulators do not have direct and easy access to the HTTP service (dummy website) exposed on http://localhost:8080.To overcome this issue, I use "cloudflared tunnel". You can also use other solutions, such as sish or ngrok Developer Preview. For more information, you can refer to the following note (in French): 2025-01-06_2105
Comme expliqué ci-dessus, cette contrainte est nécessaire afin de permettre à l'émulateur Android et à l'émulateur iOS (lancé sur une instance Scaleway Apple Silicon) aussi bien que sur mon smartphone physique personnel, d'accéder aux dummy website avec un support https.
Ceci était d'autant plus nécessaire, pour remplir les contraintes de configuration de la fonctionnalité Deep Linking with Universal and App Links.
C'est pour cela que j'ai dernièrement publié les notes suivantes : 2024-12-28_1621, 2024-12-28_1710, 2024-12-31_1853 et Alternatives managées à ngrok Developer Preview.
Pour simplifier la configuration de ce projet (poc-capacitor), j'ai décidé d'utiliser "cloudflared tunnel" en mode non connecté.
J'ai installé cloudflared avec Mise (voir la configuration ici).
Pour rendre plus pratique le lancement et l'arrêt du tunnel cloudflare, j'ai implémenté deux scripts :
Voici ce que cela donne à l'usage :
$ ./scripts/start-cloudflare-http-tunnel.sh
Starting the tunnel...
…wait… …wait… …wait…
Tunnel started successfully: https://moral-clause-interesting-broadway.trycloudflare.com
To stop the tunnel, you can execute:
$ ./scripts/stop-cloudflare-http-tunnel.sh
Stopping the tunnel (PID: 673143)...
Tunnel stopped successfully.
Étape 3 : configuration de la webview Capacitor
En réalité, par erreur, j'ai configuré la webview Capacitor après l'implémentation de la partie App links.
Au départ, je pensais qu'un simple window.location.href = process.env.START_URL; était suffisant pour afficher le site web dans l'application. En réalité, cette commande a pour effet d'ouvrir la page HTML dans le browser par défaut du smartphone. Je ne m'en étais pas tout de suite rendu compte.
Dans Capacitor, pour créer une webview dans une application, il est nécessaire l'utiliser la fonction InAppBrowser.openInWebView(... du package @capacitor/inappbrowser.
Voici l'implémentation dans le fichier /src/js/online-webview.js :
window.Capacitor.Plugins.InAppBrowser.openInWebView({
	url: startUrl,
	options: {
		// See https://github.com/ionic-team/capacitor-os-inappbrowser/blob/e5bee40e9b942da0d4dad872892f5e7007d87e75/src/defaults.ts#L33
		// Constant values are in https://github.com/ionic-team/capacitor-os-inappbrowser/blob/e5bee40e9b942da0d4dad872892f5e7007d87e75/src/definitions.ts
		showToolbar: false,
		showURL: false,

		clearCache: true,
		clearSessionCache: true,
		mediaPlaybackRequiresUserAction: false,

		// closeButtonText: 'Close',
		// toolbarPosition: 'TOP', // ToolbarPosition.TOP

		// showNavigationButtons: true,
		// leftToRight: false,
		customWebViewUserAgent: 'capacitor webview',

		android: {
			showTitle: false,
			hideToolbarOnScroll: false,
			viewStyle: 'BOTTOM_SHEET', // AndroidViewStyle.BOTTOM_SHEET

			startAnimation: 'FADE_IN', // AndroidAnimation.FADE_IN
			exitAnimation: 'FADE_OUT', // AndroidAnimation.FADE_OUT
			allowZoom: false
		},
		iOS: {
			closeButtonText: 'DONE',           // DismissStyle.DONE
			viewStyle: 'FULL_SCREEN',          // iOSViewStyle.FULL_SCREEN
			animationEffect: 'COVER_VERTICAL', // iOSAnimation.COVER_VERTICAL
			enableBarsCollapsing: true,
			enableReadersMode: false
		}
	}
});
Les paramètres dans options permettent de configurer la webview. J'ai choisi de désactiver un maximum de fonctionnalités.
En implémentant cette partie, j'ai rencontré trois difficultés :
- Avec la version
1.0.2du packages, j'ai rencontré ce bug "Bug- Android App crashing after adding this plugin, j'ai perdu presque 1 heure avant de le découvrir, pour fixer cela, j'ai choisi le QuickWin d'installer la version1.0.1. - J'ai mis un peu de temps pour trouver les paramètres passés dans
options - J'ai trouvé
allowZoom: falsepour supprimer l'affichage des boutons de zoom dans la webview
Étape 4 : setup de la partie App Links
Après avoir lu la page "Deep Linking with Universal and App Links", c'était la partie que je trouvais la plus difficile, mais en pratique, ce n'est pas très compliqué.
J'ai passé 5h30 sur cette partie, mais j'ai fait plusieurs erreurs.
Cette configuration se passe en 3 étapes.
Génération du fichier .well-known/assetlinks.json
La première consiste à générer le fichier le fichier dummy-website/.well-known/assetlinks.json qui est exposé par le serveur HTTP du dummy website.
Cette opération est documentée dans la partie "Create Site Association File".
Son contenu ressemble à ceci :
[
  {
    "relation": [
        "delegate_permission/common.handle_all_urls"
    ],
    "target": {
      "namespace": "android_app",
      "package_name": "$PACKAGE_NAME",
      "sha256_cert_fingerprints": ["$SHA256_FINGERPRINT"]
    }
  }
]
Il a une fonction de sécurité, il permet d'éviter de créer des applications malveillantes qui s'ouvriraient automatiquement sur des URLs sans lien avec l'application.
Il permet de dire « l'URL de ce site web peut automatiquement ouvrir l'application $PACKAGE_NAME » qui est signée avec la clé publique $SHA256_FINGERPRINT.
J'ai implémenté le script /scripts/generate-dev-assetlinks.sh qui permet automatiquement de générer ce fichier.
Lorsque j'ai travaillé sur cette partie, j'ai fait l'erreur de générer un certificat (voir le script /scripts/generate-dev-assetlinks.sh). Or, ce n'est pas la bonne méthode en mode développement.
Par défaut, Android met à disposition un certificat de développement dans ${HOME}/.android/debug.keystore.
La commande suivante me permet d'extraire la clé publique :
SHA256_FINGERPRINT=$(keytool -list -v \
  -keystore "${HOME}/.android/debug.keystore" \
  -alias "androiddebugkey" \ # password par défaut
  -storepass "android" 2>/dev/null | grep "SHA256:" | awk '{print $2}')
Configuration de AndroidManifest.xml
Comme indiqué ici, voici les lignes que j'ai ajoutées dans /android/app/src/main/AndroidManifest.xml.tmpl :
<intent-filter android:autoVerify="true">
   <action android:name="android.intent.action.VIEW" />
   <category android:name="android.intent.category.DEFAULT" />
   <category android:name="android.intent.category.BROWSABLE" />
   <data android:scheme="https" />
   <data android:host="{{ .Env.ALLOW_NAVIGATION }}" />
</intent-filter>
Petite digression sur mon usage des templates dans ce projet.
J'utilise gomplate pour générer des fichiers dynamiquement à partir de 4 templates (.tmpl) et des variables d'environnement configurées entre autres dans .envrc.
La génération des fichiers se trouve ici :
gomplate -f capacitor.config.json.tmpl -o capacitor.config.json
gomplate -f android/app/build.gradle.tmpl -o android/app/build.gradle
gomplate -f android/app/src/main/AndroidManifest.xml.tmpl -o android/app/src/main/AndroidManifest.xml
gomplate -f android/app/src/main/strings.xml.tmpl -o android/app/src/main/res/values/strings.xml
Les principaux éléments dynamiques sont :
export APP_NAME=myapp
export PACKAGE_NAME="xyz.sklein.myapp"
export START_URL=$(cat .cloudflared_tunnel_url)
export ALLOW_NAVIGATION=$(echo "$START_URL" | sed -E 's#https://([^/]+).*#\1#')
START_URL contient l'URL publique générée par cloudflared tunnel qui change à chaque lancement du tunnel.
Support deep links via l'interception de l'événement appUrlOpen
Troisième étape de la configuration de App links.
let timeoutId = setTimeout(() => {
	openInWebView(process.env.START_URL);
}, 200);

window.Capacitor.Plugins.App.addListener('appUrlOpen', (event) => {
	clearTimeout(timeoutId);
	openInWebView(event.url);
});
Cela permet d'implémenter la fonction deep links. Exemple : si l'utilisateur du smartphone clique sur l'URL https://dummysite/deep/ alors l'application va directement s'ouvrir sur la page /deep/ du dummy website.
Commandes utiles
La commande suivante permet de demander à l'OS Android de lancer une nouvelle "vérification" du fichier dummy-website/.well-known/assetlinks.json :
$ adb shell pm verify-app-links --re-verify ${PACKAGE_NAME}
Note : le fichier .cloudflared_tunnel_url contient l'URL du tunnel cloudflare qui expose le dummy website.
La commande suivante permet d'afficher la configuration actuelle App Link d'une application :
$ adb shell pm get-app-links ${PACKAGE_NAME}
  xyz.sklein.myapp:
    ID: 100ba7e3-b978-49ac-926c-8e6ec6810f5c
    Signatures: [AF:AE:25:7F:ED:98:49:A3:E0:23:B3:BE:92:08:84:A5:82:D1:80:AA:E0:A4:A3:D3:A0:E2:18:D6:70:05:67:ED]
    Domain verification state:
      association-pending-belt-acute.trycloudflare.com: verified
La commande suivante permet de tester le lancement de l'application à partir d'une URL passée en paramètre :
$ adb shell am start -W -a android.intent.action.VIEW -d "$(cat .cloudflared_tunnel_url)"
Starting: Intent { act=android.intent.action.VIEW dat=https://sc-lo-welsh-injury.trycloudflare.com/... }
Status: ok
LaunchState: COLD
Activity: xyz.sklein.myapp/.MainActivity
TotalTime: 1258
WaitTime: 1266
Complete
Cela fonctionne aussi avec une sous-page, par exemple : "$(cat .cloudflared_tunnel_url)/deep/?query=foobar".
Dans l'émulateur, Chrome ne lance pas les App Link !
Je pense que ce piège m'a fait perdre 2 h (sur les 5 h passées sur cette implémentation) !
Si j'ouvre l'URL du dummy website dans Chrome, l'application n'est pas lancée.
Mais, si j'ouvre l'URL dans l'application qui se nomme "Google", celle accessible via la barre de recherche en bas ce ce screenshot, l'App Link est bien pris en compte.
Problème : je testais mon application seulement dans Chrome. Et la fonctionnalité App Links ne fonctionnait pas. C'est seulement quand j'ai installé l'application sur mon smartphone physique personnel que j'ai constaté que App Links fonctionnait sous "Firefox Android".
J'ai constaté aussi que sur mon smartphone, Chrome n'ouvrait aucune application sur les URLs youtube.com, reddit.com, github.com…
D'après ce que je pense avoir compris, la liste des applications qui peuvent ouvrir les App Links est listée dans la section "Settings => Apps => Default apps" :
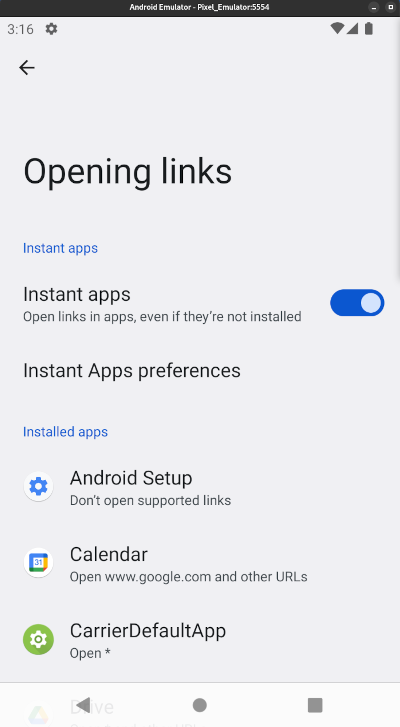
J'ai fait des expériences sur 3 différents smartphones Android d'amis et à ce jour, je n'ai pas encore compris comment cela fonctionne. J'ai l'impression que c'est lié au browser par défaut configuré, mais j'ai trouvé des exceptions.
En tout cas, ce piège m'a fait perdre beaucoup de temps !
Note finale
Pour le moment, je n'ai pas eu besoin de configurer @capacitor/app-launcher, mais je pense que cela sera utile pour permettre à l'application d'ouvrir d'autres applications à partir d'une URL.
J'ai scripté pratiquement toutes les actions de ce projet.
ChatGPT m'a bien servi tout au long de cette implémentation.
Journal du dimanche 08 septembre 2024 à 10:18
J'ai envie d'essayer de créer un "mini" service de session recording, basé sur rrweb, SvelteKit et KeyDB ou DragonflyDB.
Je pense que ce projet pourrait être minimaliste 🤔.-- from
J'ai publié https://github.com/stephane-klein/gibbon-replay (gibbon-replay).
J'ai passé 2h sur ce projet.
Idée d'un outil de session recoding web minimaliste basé sur rrweb
Plus le temps passe, et plus le nombre de services présents dans les docker-compose.yaml de OpenReplay et Posthog augmente.
Je trouve ces services de plus en plus pénible à self hosted pour de petits besoins de session recording.
J'ai envie d'essayer de créer un "mini" service de session recording, basé sur rrweb, SvelteKit et KeyDB ou DragonflyDB.
Je pense que ce projet pourrait être minimaliste 🤔.
2024-09-14 : j'ai nommé ce projet gibbon-replay.
Je me demande combien me coûterait l'hébergement de Lllama.cpp sur une GPU instance de Scaleway
#JeMeDemande combien me coûterait la réalisation du #POC suivant :
- Déploiement de llama.cpp sur une GPU Instances de Scaleway;
- 3h d'expérimentation;
- Shutdown de l'instance.
🤔.
Tarifs :
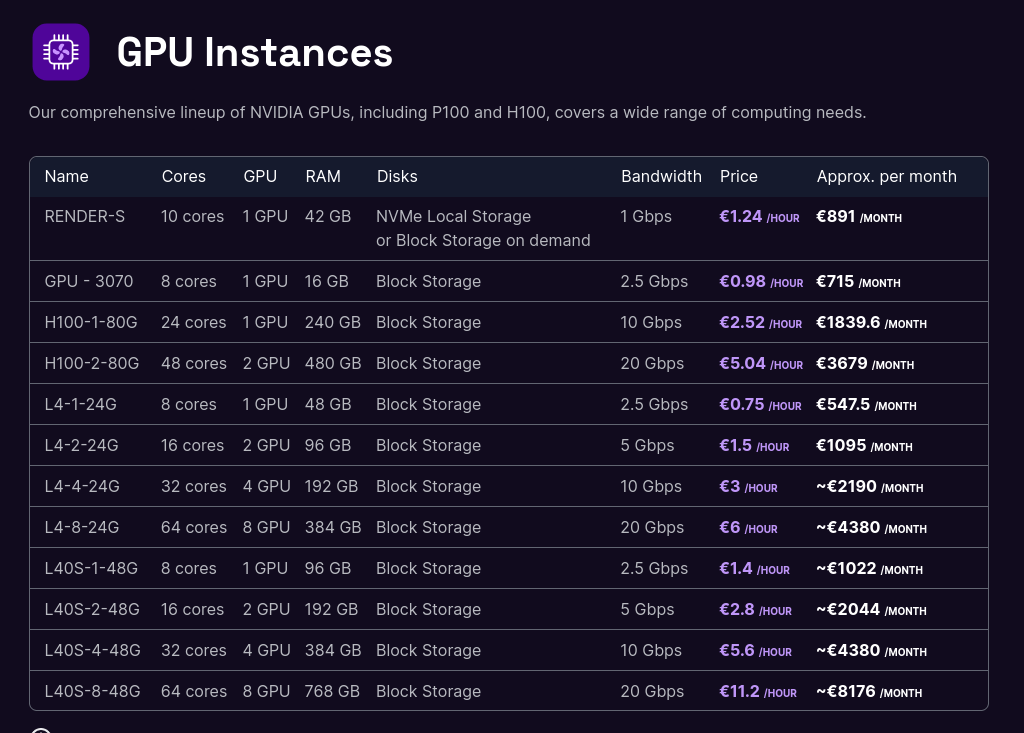
Dans un premier temps, j'aimerais me limiter aaux instances les moins chères :
- GPU-3070 à environ 1 € / heure
- L4-1-24G à 0.75 € / heure
- et peut-être RENDER-S à 1,24 € / heure
Tous ces prix sont hors taxe.
- L'instance GPU-3070 a seulement 16GB de Ram, #JeMeDemande si le résultat serait médiocre ou non.
- Je lis que l'instance L4-1-24G contient un GPU NVIDIA L4 Tensor Core GPU avec 24GB de Ram.
- Je lis que l'instance Render S contient un GPU Dedicated NVIDIA Tesla P100 16GB PCIe avec 42GB de Ram.
Au moment où j'écris ces lignes, Scaleway a du stock de ces trois types d'instances :
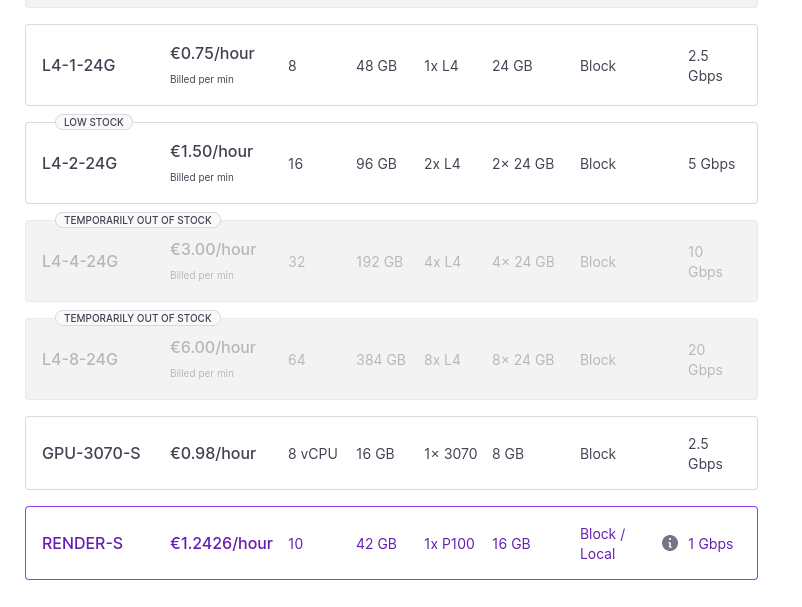
- #JeMeDemande comment je pourrais me préparer en amont pour installer rapidement sur le serveur un environnement pour faire mes tests.
- #JeMeDemande s'il existe des tutoriaux tout prêts pour faire ce type de tâches.
- #JeMeDemande combien de temps prendrait le déploiement.
Si je prends 2h pour l'installation + 3h pour faire des tests, cela ferait 5h au total.
J'ai cherché un peu partout, je n'ai pas trouvé de coût "caché" de setup de l'instance.
Le prix de cette expérience serait entre 4,5 € et 7,44 € TTC.
- #PremièreActionConcrète pour réaliser cette expérimentation : chercher s'il existe des tutoriaux d'installation de llama.cpp sur des instances GPU Scaleway.
- #JeMeDemande combien me coûterait l'achat de ce type de machine.
- #JeMeDemande à partir de combien d'heures d'utilisation l'achat serait plus rentable que la location.
- Si par exemple, j'utilise cette machine 3h par jour, je me demande à partir de quelle date cette machine serait rentabilisée et aussi, #JeMeDemande si cette machine ne serait totalement obsolète ou non à cette date 🤔.
Journal du jeudi 02 mai 2024 à 22:57
J'ai traité Projet 4 - "Je souhaite apprendre les bases d'utilisation de Apache Age".
Le résultat se trouve ici https://github.com/stephane-klein/apache-age-playground.
J'ai réussi à écrire plusieurs requêtes Cypher, mais je suis très loin de maitriser ce langage. Pour le moment, je me base principalement sur les exemples donnés dans la documentation.
Première itération d'un POC de CodeMirror avec l'autocomplétion
#JaiPublié https://github.com/stephane-klein/svelte-codemirror-autocomplete-poc qui contient mes 2 premières heures de travail sur le #POC Projet 1 - "CodeMirror, autocomplétion, Svelte".
J'ai réussi à setup le projet, mais pour le moment, je n'arrive pas à bien configurer la fonctionnalité autocomplete de CodeMirror. Par exemple, je n'arrive pas à ne pas afficher les caractères [[ dans le popup qui affiche la liste des suggestions.
Idéalement, pour expliquer, j'aimerais réaliser un screencast.
Je pense que ce POC va me prendre du temps. Je pense que je vais devoir étudier en profondeur l'API de @codemirror/autocomplete.
#SiJeDevaisParier, mon estimation de durée 🤔 serait de 8h à 20h de travail.
Journal du lundi 12 juin 2023 à 13:48
Voici le repository de la première version de mon POC qui avait pour objectif d'implémenter un système de tags en PostgreSQL, en me basant sur l'article "Tags and Postgres Arrays, a Purrrfect Combination" : https://github.com/stephane-klein/postgres-tags-model-poc.
Projet GH-360 - Implémenter un POC de Fuzzy Search en PostgreSQL
Ce projet a été initialement commencé dans une issue, le 10 janvier 2024.
Quel est l'objectif de ce projet ?
Je souhaite mettre en pratique l'extension PostgreSQL fuzzystrmatch pour implémenter une fonctionnaltié Fuzzy Search.
Je souhaite que cette implémentation permette :
- de trouver les éléments à partir d'erreurs d'insertion, de suppression et de substitution (voir paragraphe "Distances entre mots") ;
- de trouver les éléments même si des lettres ont été transposées, par exemple,
cout → toucest une transposition.
Repository de ce projet :
postgresql-fuzzysearch-poc(pas encore créé)
Ressources :
- fuzzystrmatch
- Articles Wikipedia :
- Résultat de la recherche "Fuzzy" sur Subreddit PostgreSQL
- Billet de blog : PostgreSQL Fuzzy Text Search: Not so fuzzy to fuzziest
Projet GH-339 - Implémenter un POC de Automerge
Ce projet a été initialement commencé dans une issue, le 16 novembre 2023.
Quel est l'objectif de ce projet ?
Je souhaite implémenter et publier un POC de https://automerge.org.
Ce que je souhaite réaliser dans ce POC :
- Une implémentation du serveur
- En Javascript
- Une autre implémentation en Golang
- Un client Javascript
- User story
- Sur le client A, un user saisie "item 1", celui-ci est ajouté dans une liste ordonné par timestamp
- "item 1" est affiché en temps réel sur client B
- Le client A passe offline
- Sur le client B, un user saisie "item 2"
- Sur le client A, un user saisie "item 3"
- Le client A passe online
- Le client A se synchronise automatiquement et contient la liste "item 1", "item 2", "item 3"
- User story
Repository de ce projet :
Ressources :
Projet 5 - "Importation d'un vault Obsidian vers Apache Age"
Date de la création de cette note : 2024-05-02.
Quel est l'objectif de ce projet ?
Je souhaite essayer d'implémenter un script d’importation d’un vault Obsidian vers la Base de données Graph Apache Age, avec importation des tags, alias.
Pourquoi je souhaite réaliser ce projet ?
Pour progresser en Cypher. À cause de 2024-04-30_1704.
Repository de ce projet :
https://github.com/stephane-klein/obsidian-vault-to-apache-age-poc/
Plus d'informations sur ce projet :
Projet 4 - "Je souhaite apprendre les bases d'utilisation de Apache Age"
Date de la création de cette note : 2024-05-02
J'ai commencé ce projet le 20 avril 2024
Quel est l'objectif de ce projet ?
Je souhaite dans un premier temps être capable de reproduire ce que j'avais fait dans le projet neo4j-playground et peut être même ensuite d'aller un peu plus loin dans mon apprentissage du langage de Query Cypher.
Pourquoi je souhaite réaliser ce projet ?
J'ai envie d'ajouter à ma stack de compétence, un moteur de base de données orienté Graph. Idéalement, j'aimerais que ça soit Apache Age parce que c'est un projet libre et basé sur PostgreSQL. Cela me permettrait de facilement coupler les avantages d'une base de données relationnel avec une base de données Graph.
Repository de ce projet :
https://github.com/stephane-klein/apache-age-playground
Idées après ce projet :
Si j'arrive à terminer ce projet, j'ai les idées suivantes :
- Écrire un script d'importation d'un vault Obsidian vers Apache Age, avec importation des tags, alias. => voir Projet 5
- Écrire des scripts de benchmark pour comparer PostgreSQL vs Apache Age sur les aspects suivants : vitesse de lecture, vitesse d'écriture et espace disque consommé.
Projet 2 - "Réaliser un petit projet basé sur NextJS pour le comparer avec SvelteKit"
Date de la création de cette note : mardi 30 avril 2024.
Quel est l'objectif de ce projet ?
Ce projet remplace l'issue Étudier la version 12 de NextJS que j'ai créé en mars 2023.
Contexte : J'utilise SvelteKit depuis avril 2022, j'apprécie très fortement l'élégence de toutes les fonctionnalités de routing de SvelteKit.
Mon objectif est de créer un projet de type #POC pour apprendre les bases de NextJS et de comparer ce framework avec SvelteKit.
Artefacts à produire :
- Un repository GitHub qui contient le projet de type POC que j'aurais réaliser pour apprendre à utiliser NextJS
- Une note d'opinion qui présente ma comparaison entre SvelteKit et NextJS
Objectif secondaire de ce projet:
Je pense pas dire de bétise, en déclarant qu'en 2024 ReactJS est plus populaire que VueJS et Svelte, par conséquent, je pense que maitriser Nuxt me sera utile à l'avenir, par exemple pour des projets en freelance.
Je souhaite ajouter Nuxt sur mon CV.
Repository de ce projet :
Aucun pour le moment.
Ressources :
- Voir les notes que j'ai prise dans l'issue Étudier la version 12 de NextJS
Projet 17 - Créer un POC de création d'une app smartphone avec Capacitor
Date de création de cette note : 2024-11-18.
Quel est l'objectif de ce projet ?
Je souhaite apprendre à créer une app smartphone avec Capacitor.
Idéalement, suivre la documentation "Using Capacitor in a Web Project" pour transformer l'app PWA créée dans Projet 16 - Créer un POC d'application PWA en application smartphone.
Capacitor fully supports traditional web and Progressive Web Apps. In fact, using Capacitor makes it easy to ship a PWA version of your iOS and Android app store apps with minimal work.
-- from
Todo :
- [x] Setup un projet Capacitor
- [x] Documenter comment configurer l'icône de l'application (voir 2024-12-27_1123)
- [x] Documenter comment configurer l'image de splash-screen (voir 2024-12-27_1123)
- [x] Étudier @capacitor/app-launcher
- [x] Setup une webview dans l'app, via
@capacitor/inappbrowser - [x] Documenter la configuration de Deep Linking with Universal and App Links
- [ ] Jouer du contenu audio en background (peut-être basé sur
capacitor-native-audio) - [ ] Étudier @capacitor/local-notifications
- [ ] Étudier @capacitor/push-notifications
- [ ] Tester l'envoi de notifications avec Firebase Cloud Messaging
- [ ] Tester l'envoi de notifications avec OneSignal
- [ ] Tester l'envoi de notifications avec Gotify
- [ ] Étudier
@capacitor/status-bar- [ ] Modifier la couleur de fond de la "status-bar"
- [x] Essayer d'utiliser l'offre Apple Mac mini M1 de Scaleway pour builder l'app pour iOS
- [ ] À la fin, rédiger une note de comparaison de Capacitor versus PWABuilder.
- [ ] Déployer une version de l'app sur Google Play Store en privé, pour tester
- [ ] Déployer une version de l'app sur iOS App Store en privé, pour tester
Repository de ce projet :
Projet 16 - Créer un POC d'application PWA
Date de création de cette note : 2024-11-18.
Quel est l'objectif de ce projet ?
Je souhaite apprendre à créer des applications web de type Progressive Web Apps (PWA).
J'ai déjà une certaine culture dans ce domaine, mais je n'ai jamais créé d'application de ce type.
Voici les éléments que je souhaite apprendre / tester dans ce POC :
- [ ] Accélérer le chargement d'une app web qui a déjà été visitée (configurer correctement la gestion du cache)
- [ ] Rendre l'app web installable
- [ ] Define your app icons
- [ ] Display a badge on the app icon
- [ ] Essayer de publier l'app sur (basé sur PWABuilder)
- [ ] Google Play Store
- [ ] iOS App Store
- [ ] Implémenter l'envoie de notification via un worker
- [ ] L'application doit être accessible même offline.
Si possible, j'aimerais implémenter ce POC avec SvelteKit.
Idéalement, j'aimerais intégrer le travail de "Projet GH-339 - Implémenter un POC de Automerge" dans un PWA.
Ressources :
Projet 27 - "Créer un POC de pg_back"
Date de la création de cette note : 2025-04-11.
Quel est l'objectif de ce projet ?
Réaliser un POC pour tester l'utilisation de pg_back pour sauvegarder une base de données complète PostgreSQL.
Contraintes :
- [x] Sauvegarder une base de données PostgreSQL déployée via Docker
- [x] pg_back doit être déployé dans un Docker sidecar
- [x] sauvegarde des archives dans Minio
- [x] Chiffrer les archives
- [x] Génération des archives au format
custom - [x] Vérifier que je peux sauvegarder les archives dans un sous-dossier du bucket Object Storage
- [x] Documenter une méthode pour télécharger une archive dans un dossier du workspace du développeur
- [x] Documenter une méthode pour restaurer l'archive dans un serveur PostgreSQL déployé via Docker
- [x] Tester le fonctionnement du système d'expiration des archives
Pourquoi je souhaite réaliser ce projet ?
Suite à cette réflexion je pense qu'il est préférable d'utiliser pg_back plutôt que restic-pg_dump-docker.
Je souhaite valider cette hypothèse.
Repository de ce projet :
https://github.com/stephane-klein/pg_back-docker-sidecar
Ressources :
Résultat du projet : J'ai publié le projet "pg_back-docker-sidecar".
Projet 3 - "Réaliser un petit projet basé sur Nuxt pour le comparer avec SvelteKit"
Date de la création de cette note : mardi 30 avril 2024 .
Quel est l'objectif de ce projet ?
Pour les mêmes raisons qui me motive à réaliser Projet - 2 "Réaliser un petit projet basé sur NextJS pour le comparer avec SvelteKit", je souhaite réaliser la même chose pour Nuxt.
Contexte : J'utilise SvelteKit depuis avril 2022, j'apprécie très fortement l'élégence de toutes les fonctionnalités de routing de SvelteKit.
Mon objectif est de créer un projet de type #POC pour apprendre les bases de Nuxt et de comparer ce framework avec SvelteKit.
Artefacts à produire :
Projet 33 - "POC serveur Git HTTP qui injecte du contenu dans OpenSearch"
Date de la création de cette note : 2025-08-29.
Quel est l'objectif de ce projet ?
Mon objectif est de développer un POC d'un serveur Git capable d'injecter du contenu dans une base de données OpenSearch. Cette base de données pourra ensuite être utilisée comme un content repository.
Ce projet aura comme base le résultat du projet 32 : poc-node-git-server-in-sveltekit
Quelques détails d'implémentation du projet :
- Un serveur Git HTTP supportant les opérations push et pull
- Après chaque git push, injection automatique des données reçues vers une base de données OpenSearch
- Intégration d'un système de job queue minimaliste qui permet de traiter les tâches d'importation des données Git vers OpenSearch de manière asynchrone. Cela permet entre autres de rendre l'opération git push non bloquante.
- Le modèle de données doit permettre l'accès au contenu de plusieurs branches.
- L'accès aux données via l'API de OpenSearch ne doit pas être perturbé pendant les phases d'importation de données depuis Git.
- Upload des fichiers binaires vers un serveur Minio tout concervant leurs metadata (chemin, branche, etc) dans OpenSearch.
- La suppression d'une branche ou d'un commit doit aussi supprimer les données présentes dans OpenSearch et Minio.
- Utilisation de la librairie nodegit.
Potentiels futurs projets basés sur ce POC :
- Implémentation d'un web frontend en SvelteKit qui s'occupe du rendu des données du content repository via des requêtes OpenSearch.
- Implémentation d'un web frontend en Astro qui s'occupe du rendu des données du content repository via des requêtes OpenSearch.
- Explorer comment TinaCMS pourrait s'intégrer dans ce système.
Pourquoi je souhaite réaliser ce projet ?
Je considère ce projet comme l'étape suivante du projet 32 et donc il a le même objectif, c'est-à-dire, intégrer les apprentissages de ce POC dans le projet sklein-pkm-engine pour éliminer la dépendance à import-to-es-database.js.
L'idée est de permettre la mise à jour de notes.sklein.xyz avec mes données locales uniquement par git push, sans rien avoir à installer sur ma workstation.
Je souhaite aussi utiliser à l'avenir la technique mise au point dans ce POC dans le Projet 24 - Prototyper le gestionnaire de projet de mes rêves.
Repository de ce projet :
Ressources :
Projet 1 - "CodeMirror, autocomplétion, Svelte"
Date de la création de cette note : lundi 29 avril 2024.
Quel est l'objectif de ce projet ?
Dans une application web frontend en Svelte, je souhaite essayer d'implémenter un éditeur texte markdown, avec un support d'autocomplétion. Je souhaite faire cela avec la librairie CodeMirror.
Pourquoi je souhaite réaliser ce projet ?
J'ai besoin d'implémenter une fonctionnalité d'autocomplétion dans l'application Value Props.
Repository de ce projet :
https://github.com/stephane-klein/svelte-codemirror-autocomplete-poc
Ressources :
- En août 2023, j'ai déjà setup CodeMirror dans un projet Svelte. Voici le code source de ce projet :
poc-svelte-prosemirror-markdownet son issue.
Voici un screencast du résultat : https://youtu.be/IwrV7U5kDhU. - Documentation de la fonctionnalité d'autocomplétion de CodeMirror : https://codemirror.net/examples/autocompletion/
- Concealing syntax - v6 - discuss.CodeMirror
30 avril 2024
J' 'aimerais aussi essayer d'implémenter dans ce POC une fonctionnalité conceal comme celle de Neovim.
Projet 38 - "POC champ de recherche enrichi avec CodeMirror et conceal"
Date de la création de cette note : 2026-07-19.
Projet terminé, résultat disponible dans ce repository : https://github.com/stephane-klein/svelte-codemirror-search-conceal-poc
Quel est l'objectif de ce projet ?
Créer un POC pour implémenter un champ de recherche avec filtre enrichi par le système de conceal. Deux librairies sont candidates : CodeMirror (déjà utilisé dans les Projet 1 et Projet 8) et ProseMirror. Je n'ai pas encore fait de choix définitif au moment de la rédaction de cette note — je vais commencer par explorer la piste CodeMirror (déjà maîtrisée via les Projets 1 et 8), puis évaluerai ProseMirror dans un second temps. L'objectif est de départager les deux sur le poids du code, la vitesse de rendu et la simplicité d'implémentation.
Ce champ sur une seule ligne, utilisé à la place d'un <input type="text"> classique, doit :
- Afficher une autocomplétion de tags dès la saisie de
#ou- - Utiliser le conceal pour basculer entre deux affichages : quand le curseur est suffisamment éloigné du tag (au-delà d'un seuil configurable en nombre de caractères), le tag est affiché sous forme de pastille. Quand le curseur s'approche en dessous de ce seuil, la pastille disparaît et laisse place au texte modifiable
- Permettre à l'utilisateur de copier/coller l'intégralité du champ de recherche au format texte
Second groupe de fonctionnalités, optionnel et vraisemblablement plus difficile à implémenter :
- Support des parenthèses et des mots-clés
or/and. Par défaut, sans mot-clé, les termes sont combinés avec AND - Si l'utilisateur saisit
(#tag1 and #tag2 and foo bar), alors la même logique de conceal s'applique :foo barest affiché sous la forme"foo bar" - Si la parenthèse n'est pas fermée, afficher un message d'erreur et, si possible, surligner la parenthèse ouvrante orpheline
Questions ouvertes :
- Est-il utile d'ajouter un élément UI de suppression sur les pastilles de tag ?
- ProseMirror apportera-t-il un bénéfice suffisant par rapport à CodeMirror pour justifier son exploration ? Je commence par CodeMirror et je jugerai ensuite
Pourquoi je souhaite réaliser ce projet ?
J'ai toujours eu une mauvaise expérience avec les champs de filtre / recherche de GitLab ou Linear.
Quand j'ai terminé en juillet 2024 le Projet 8 - "CodeMirror, conceal, Svelte", l'idée m'est venue d'essayer de créer un composant de champ recherche qui offrirait une meilleure expérience utilisateur en mettant en œuvre le système de conceal.
Ce projet s'inscrit dans la continuité des réflexions de Projet GH-360 (fuzzy search en PostgreSQL) et Projet GH-382 (conversion de filtres tags en SQL). Je compte l'utiliser dans le cadre du Projet 36 (toggl-pg-mirror).
Note de contexte : LLM et filtres
#JeMeDemande si l'essor des LLMs — capables de générer du SQL à partir de prose humaine sans formalisme — ne rend pas ce langage de filtre structuré obsolète. Mon intuition : les deux approches sont complémentaires. Le champ de saisie avec autocomplétion de tags offre une UI réactive et un contrôle fin à l'utilisateur, tandis qu'un LLM peut traduire l'expression filtrée en requête SQL en backend. On peut utiliser les deux en même temps.
Repository de ce projet :
https://github.com/stephane-klein/svelte-codemirror-search-conceal-poc
Ressources :
- conceal — note de référence sur le mécanisme de conceal (Vim/Neovim, équivalents)
- Projet 8 - "CodeMirror, conceal, Svelte" — l'exploration du conceal dans CodeMirror qui est à l'origine de ce projet
- Projet 1 - "CodeMirror, autocomplétion, Svelte" — première exploration du conceal et de l'autocomplétion dans un éditeur de texte
- Documentation CodeMirror
- Documentation ProseMirror
Date de la création de cette note : 9 septembre 2026.
Quel est l'objectif de ce projet ?
Je souhaite créer un POC pour tester et apprendre à construire un pipeline Retrieval-augmented generation (RAG) complet en NodeJS, avec des briques de base comme pgvector, pg_search (BM25), le reranking et AI SDK.
Je souhaite tester mon RAG avec les documents suivants :
- Système national d'économie politique (1841) de Friedrich List
- Sophismes économiques (1845-1848) de Frédéric Bastiat
Ces deux livres sont disponibles en Creative Commons sur Wikisource.
Ce projet sera découpé en 4 composants :
- la préparation des documents sources et la génération des résumés hiérarchiques
- le découpage en paragraphes, la génération des sidecars JSONL et des embeddings, et leur versionnement dans git
- le chargement en base et l'indexation (modèle de données PostgreSQL)
- le service de recherche MCP du RAG
Composant 1 : Préparation des documents et génération des résumés hiérarchiques
Je connaissais RAPTOR, mais en creusant le sujet avec Sonnet 5, j'ai compris que RAPTOR n'est pas une technique concurrente de la hierarchical summarization : c'est un type de hierarchical summarization, qui construit son arbre par clustering.
RAPTOR prépare les embeddings avant de les regrouper : avec Uniform Manifold Approximation and Projection (UMAP), il rapproche les contenus similaires dans un espace simplifié ; avec Gaussian Mixture Model (GMM), il identifie des groupes de contenus proches ; il fait résumer chaque groupe par un LLM, puis recommence récursivement. Cette approche est bien adaptée à un corpus dont on ignore la structure.
Or mes sources sont des livres : des documents dont la structure (livres, chapitres) est connue d'avance et reflète l'organisation des idées. Plutôt que de redécouvrir cette structure par clustering, je pense qu'il est plus simple, plus fiable, plus rapide et moins gourmand en ressources de s'appuyer directement dessus. J'ai découvert avec DeepSeek que cette technique se nomme hierarchical summarization structurel (structure-driven).
Une indexation de type hierarchical summarization structurel consistera à construire un arbre de nœuds : le niveau 0 est le contenu source découpé en paragraphes — il n'est pas résumé — et un LLM génère les résumés des niveaux 1 à 3 :
- Niveau 0 : le contenu source, tel qu'extrait des fichiers sources, découpé en paragraphes — ce sont les feuilles de l'arbre, pas des résumés (aucun LLM ici)
- Niveau 1 : un résumé par section de premier niveau — chapitre, ou pièce liminaire rattachée directement à l'ouvrage (préface, introduction) —, généré par défaut à partir des nœuds de niveau 0 de cette section
- Niveau 2 : un résumé par partie de l'ouvrage — nommée « livre » chez List, « série » chez Bastiat —, généré par défaut à partir des résumés de niveau 1
- Niveau 3 : un résumé de l'ouvrage entier, généré par défaut à partir des résumés de niveau 2 des parties et des résumés de niveau 1 des pièces liminaires
Le niveau d'un nœud décrit sa position dans l'arbre de résumés (son degré d'abstraction), pas l'origine de sa génération.
Par défaut, chaque résumé est donc construit à partir des résumés du niveau précédent. Je souhaite pouvoir configurer un algorithme alternatif, plus gourmand en ressources LLM, mais rendu techniquement possible par les modèles LLM qui supportent de très grandes context windows, où certains résumés sont construits à partir d'une source plus directe :
- le niveau 2 est construit à partir du contenu de tous les chapitres de la partie, sans passer par les résumés du niveau 1
- le niveau 3 est construit à partir des résumés de niveau 1, sans passer par les résumés du niveau 2
Je pense que l'un de mes défis sera de concevoir un bon prompt pour générer les résumés : le résumé doit être fidèle au contenu tout en servant mon angle d'analyse, et le prompt devra sans doute s'adapter à la thématique du livre et au niveau du résumé (section, partie, œuvre).
corpus/
├── list-systeme-national-economie-politique/
│   ├── summary.md                            # résumé de l'œuvre (niveau 3)
│   ├── preface/                              # préface de l'auteur (le paratexte du traducteur est exclu du corpus)
│   │   ├── source.md                         # texte de la préface
│   │   └── summary.md                        # résumé de la préface (niveau 1)
│   ├── introduction/
│   │   ├── source.md
│   │   └── summary.md                        # résumé de l'introduction (niveau 1)
│   ├── livre-1-l-histoire/
│   │   ├── summary.md                        # résumé du "Livre premier" (niveau 2)
│   │   ├── chapitre-01-les-italiens/
│   │   │   ├── source.md
│   │   │   └── summary.md                    # résumé du chapitre (niveau 1)
│   │   ├── chapitre-02-les-anseates/
│   │   │   ├── source.md
│   │   │   └── summary.md
│   │   └── ...
│   ├── livre-2-la-theorie/
│   │   ├── summary.md
│   │   ├── chapitre-01-l-economie-politique-et-l-economie-cosmopolite/
│   │   │   ├── source.md
│   │   │   └── summary.md
│   │   └── ...
│   ├── livre-3-les-systemes/
│   │   ├── summary.md
│   │   ├── chapitre-01-les-economistes-italiens/
│   │   │   ├── source.md
│   │   │   └── summary.md
│   │   └── ...
│   └── livre-4-la-politique/
│       ├── summary.md
│       ├── chapitre-01-la-suprematie-insulaire-et-les-puissances-continentales/
│       │   ├── source.md
│       │   └── summary.md
│       └── ...
└── bastiat-sophismes-economiques/
    ├── summary.md                            # résumé de l'œuvre (niveau 3)
    ├── premiere-serie/
    │   ├── summary.md                        # résumé de la première série (niveau 2)
    │   ├── chapitre-01-abondance-disette/
    │   │   ├── source.md
    │   │   └── summary.md                    # résumé du chapitre (niveau 1)
    │   └── ...
    └── deuxieme-serie/
        ├── summary.md                        # résumé de la deuxième série (niveau 2)
        ├── chapitre-01-physiologie-de-la-spoliation/
        │   ├── source.md
        │   └── summary.md
        └── ...
Je pense ajouter dans le frontmatter des documents sources Markdown un indicateur pour marquer explicitement les documents à vectoriser ou non.
Chaque fichier source.md ou summary.md du corpus porte aussi dans son frontmatter le champ parent_source_file : le chemin, relatif au corpus, du fichier du nœud parent dans l'arbre de résumés. Ce champ suit la règle de génération des résumés : un source.md a pour parent le summary.md de sa section (celui du même dossier) ; un summary.md de chapitre a pour parent le summary.md de la partie qui le contient ; un summary.md de pièce liminaire (préface, introduction) ou de partie a pour parent le summary.md de l'œuvre ; le summary.md de l'œuvre, racine de l'arbre, n'a pas de parent.
Composant 2 : Génération des sidecars et versionnement des embeddings
La fonction de ce composant est de découper en paragraphes le contenu des fichiers Markdown du composant 1, de vectoriser les fichiers que le frontmatter marque à vectoriser, et d'enregistrer le résultat dans des fichiers sidecar à côté des fichiers sources, pour les versionner dans git. Un sidecar est généré pour chaque fichier, qu'il soit vectorisé ou non ; le sidecar d'un fichier non vectorisé contient les paragraphes sans embeddings (voir l'exemple plus bas). Le composant 2 recopie aussi dans le manifest de chaque sidecar le champ parent_source_file lu dans le frontmatter du fichier .md (renseigné par le composant 1).
Voici l'équivalent de la précédente arborescence de fichiers avec en plus les fichiers sidecars :
# Sidecars *.md.jsonl : un sidecar est généré pour chaque fichier, vectorisé ou non.
# Chaque paragraphe du fichier donne une ligne ; les fichiers vectorisés contiennent des
# champs embeddings, les autres non (cas « tout vectorisé » illustré ici — voir exemple JSONL plus bas).
corpus/
├── list-systeme-national-economie-politique/
│   ├── summary.md                            # résumé de l'œuvre (niveau 3)
│   ├── summary.md.jsonl
│   ├── preface/                              # préface de l'auteur (le paratexte du traducteur est exclu du corpus)
│   │   ├── source.md
│   │   ├── source.md.jsonl
│   │   ├── summary.md
│   │   └── summary.md.jsonl
│   ├── introduction/
│   │   ├── source.md
│   │   ├── source.md.jsonl
│   │   ├── summary.md
│   │   └── summary.md.jsonl
│   ├── livre-1-l-histoire/
│   │   ├── summary.md                        # résumé du "Livre premier" (niveau 2)
│   │   ├── summary.md.jsonl
│   │   ├── chapitre-01-les-italiens/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md                    # résumé du chapitre (niveau 1)
│   │   │   └── summary.md.jsonl
│   │   ├── chapitre-02-les-anseates/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md
│   │   │   └── summary.md.jsonl
│   │   └── ...
│   ├── livre-2-la-theorie/
│   │   ├── summary.md
│   │   ├── summary.md.jsonl
│   │   ├── chapitre-01-l-economie-politique-et-l-economie-cosmopolite/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md
│   │   │   └── summary.md.jsonl
│   │   └── ...
│   ├── livre-3-les-systemes/
│   │   ├── summary.md
│   │   ├── summary.md.jsonl
│   │   ├── chapitre-01-les-economistes-italiens/
│   │   │   ├── source.md
│   │   │   ├── source.md.jsonl
│   │   │   ├── summary.md
│   │   │   └── summary.md.jsonl
│   │   └── ...
│   └── livre-4-la-politique/
│       ├── summary.md
│       ├── summary.md.jsonl
│       ├── chapitre-01-la-suprematie-insulaire-et-les-puissances-continentales/
│       │   ├── source.md
│       │   ├── source.md.jsonl
│       │   ├── summary.md
│       │   └── summary.md.jsonl
│       └── ...
└── bastiat-sophismes-economiques/
    ├── summary.md                            # résumé de l'œuvre (niveau 3)
    ├── summary.md.jsonl
    ├── premiere-serie/
    │   ├── summary.md                        # résumé de la première série (niveau 2)
    │   ├── summary.md.jsonl
    │   ├── chapitre-01-abondance-disette/
    │   │   ├── source.md
    │   │   ├── source.md.jsonl
    │   │   ├── summary.md                    # résumé du chapitre (niveau 1)
    │   │   └── summary.md.jsonl
    │   └── ...
    └── deuxieme-serie/
        ├── summary.md                        # résumé de la deuxième série (niveau 2)
        ├── summary.md.jsonl
        ├── chapitre-01-physiologie-de-la-spoliation/
        │   ├── source.md
        │   ├── source.md.jsonl
        │   ├── summary.md
        │   └── summary.md.jsonl
        └── ...
Voici ci-dessous un exemple de fichier sidecar JSONL pour un fichier Markdown source vectorisé. Le découpage s'effectue par paragraphes : chaque paragraphe devient un chunk, sauf si un paragraphe dépasse le seuil de tokens défini (voir composant 2), auquel cas il est subdivisé. Le champ source_file_hash est abrégé ici pour la lisibilité ; il porte en réalité le SHA-256 complet du fichier. Chaque manifest porte aussi parent_source_file, le chemin relatif au corpus du fichier du nœud parent ; ce champ est absent (NULL) pour la racine de l'arbre — le summary.md de l'œuvre.
{
  "type": "manifest",
  "source_file": "corpus/list-systeme-national-economie-politique/livre-1-l-histoire/chapitre-01-les-italiens/source.md",
  "source_file_hash": "sha256:2cf24d…",
  "parent_source_file": "corpus/list-systeme-national-economie-politique/livre-1-l-histoire/chapitre-01-les-italiens/summary.md",
  "heading_path": "Système national d'économie politique > Livre I > Chapitre I (Les Italiens)",
  "level": 0,
  "node_type": "source",
  "embedding_model": "text-embedding-3-small",
  "dimension": 1536,
  "chunk_count": 3
}
{
  "chunk_index": 0,
  "content_token_count": 782,
  "text": "…texte exact du premier chunk embeddé…",
  "embedding": [-0.013, 0.022, 0.107, -0.041, …]
}
{
  "chunk_index": 1,
  "content_token_count": 756,
  "text": "…texte exact du deuxième chunk embeddé…",
  "embedding": [0.041, -0.017, 0.094, 0.002, …]
}
{
  "chunk_index": 2,
  "content_token_count": 803,
  "text": "…texte exact du troisième chunk embeddé…",
  "embedding": [-0.007, 0.011, -0.052, 0.018, …]
}
Voici l'exemple d'un fichier non vectorisé : le sidecar est bien généré, avec le même découpage par paragraphes, mais le manifest ne porte ni embedding_model ni dimension et aucune ligne ne contient d'embedding. Ces paragraphes ne sont retrouvables qu'en BM25.
{
  "type": "manifest",
  "source_file": "corpus/bastiat-sophismes-economiques/premiere-serie/chapitre-01-abondance-disette/source.md",
  "source_file_hash": "sha256:f53b7d…",
  "parent_source_file": "corpus/bastiat-sophismes-economiques/premiere-serie/chapitre-01-abondance-disette/summary.md",
  "heading_path": "Sophismes économiques > Première série > Chapitre I (Abondance, disette)",
  "level": 0,
  "node_type": "source",
  "chunk_count": 2
}
{
  "chunk_index": 0,
  "content_token_count": 612,
  "text": "…texte exact du premier paragraphe…"
}
{
  "chunk_index": 1,
  "content_token_count": 538,
  "text": "…texte exact du deuxième paragraphe…"
}
Composant 3 : Chargement en base et indexation (pgvector + pg_search)
Je souhaite importer tout cela dans une base de données PostgreSQL configurée avec les extensions suivantes : pgvector pour la recherche sémantique vectorielle et pg_search pour la recherche BM25.
Exemple de schéma de modèle de données :
CREATE TABLE hierarchical_content_nodes (
  id SERIAL PRIMARY KEY,

  -- Profondeur dans la hiérarchie, du contenu source vers les résumés les plus abstraits.
  -- Convention générale (adaptable selon la profondeur réelle de chaque ouvrage) :
  --   0 = contenu source (un paragraphe extrait du fichier source)
  --   1 = résumé d'une section de premier niveau (chapitre, ou pièce liminaire comme
  --       la préface ou l'introduction), généré par défaut à partir des nœuds de niveau 0
  --       de cette section
  --   2 = résumé d'une partie de l'ouvrage (livre chez List, série chez Bastiat), généré
  --       par défaut à partir des résumés de niveau 1
  --   3 = résumé de l'ouvrage entier, généré par défaut à partir des résumés de niveau 2
  --       des parties et des résumés de niveau 1 des pièces liminaires
  level INT NOT NULL,

  -- Chemin relatif au corpus du fichier du nœud parent dans l'arbre de résumés
  -- (champ `parent_source_file` du manifest, recopié du frontmatter du .md).
  -- Un nœud = un fichier : toutes les lignes d'un même `source_file` (les
  -- paragraphes d'un résumé éventuellement multi-paragraphes) forment un seul
  -- nœud, et les lignes d'un même nœud partagent donc le même parent. NULL pour
  -- la racine (summary.md de l'œuvre, niveau 3). Pas de contrainte de clé
  -- étrangère possible : `source_file` n'est pas unique dans cette table ;
  -- l'intégrité (existence du sidecar du fichier parent) est vérifiée à l'import.
  parent_source_file TEXT,

  node_type TEXT NOT NULL CHECK (node_type IN ('source', 'summary')),

  -- Fichier Markdown (source.md ou summary.md) dont est issu ce nœud (sortie du
  -- composant 1), chemin relatif au corpus. Identique au champ `source_file` du manifest
  -- du sidecar JSONL du composant 2.
  source_file TEXT NOT NULL,

  -- Hash SHA-256 du fichier Markdown au moment de la génération du sidecar
  -- (champ `source_file_hash` du manifest). Détecte un .md modifié
  -- depuis sa dernière indexation → re-génération des lignes correspondantes.
  source_file_hash TEXT NOT NULL,

  -- Index du paragraphe dans son fichier source (champ `chunk_index` du JSONL),
  -- de 0 à chunk_count-1. Un paragraphe est un chunk ; un paragraphe trop long
  -- est subdivisé en plusieurs chunks successifs.
  chunk_index INT NOT NULL,

  -- Chemin hiérarchique lisible du nœud (champ `heading_path` du manifest),
  -- constant pour toutes les lignes issues d'un même fichier.
  -- Exemples (conformes à la convention de niveau ci-dessus) :
  --   'Sophismes économiques > Première série > Chapitre I'                      (level 0, source)
  --   'Sophismes économiques > Première série > Chapitre I (résumé)'             (level 1, summary)
  --   'Sophismes économiques > Première série (résumé)'                          (level 2, summary)
  --   'Sophismes économiques (résumé)'                                           (level 3, summary)
  --   'Système national d'économie politique > Préface'                          (level 0, source)
  --   'Système national d'économie politique > Préface (résumé)'                 (level 1, summary)
  heading_path TEXT,

  -- Contenu du nœud = champ `text` de la ligne JSONL correspondante :
  --   - nœud `summary` → un paragraphe du résumé généré par le LLM ;
  --   - nœud `source` → un paragraphe du fichier source (ou un fragment si le
  --     paragraphe a dû être subdivisé).
  content TEXT NOT NULL,

  -- Nombre de tokens de `content` (champ `content_token_count` du JSONL),
  -- calculé une fois à l'ingestion pour éviter de re-tokenizer à chaque requête.
  -- Sert de garde-fou au moment du retrieval : décider si un nœud peut être
  -- chargé tel quel dans le prompt, ou s'il faut charger ses enfants à la place
  -- (limite de contexte du LLM, limite de tokens par document du reranker).
  -- Un nœud pouvant couvrir plusieurs lignes (résumé multi-paragraphes), son
  -- total se calcule en sommant `content_token_count` sur les lignes de son
  -- `source_file`. « Charger les enfants » d'un nœud = lire les lignes dont
  -- `parent_source_file` pointe vers ce fichier.
  content_token_count INT,

  -- Nom du modèle d'embedding utilisé (champ `embedding_model` du manifest).
  -- Modèle unique pour tout le corpus à un instant donné (cf. dimension 1536) ;
  -- la politique par fichier porte sur le choix de vectoriser ou non, pas sur le modèle.
  -- Un changement de modèle global invalide tous les vecteurs : le source_file_hash ne
  -- changeant pas dans ce cas, l'import doit comparer le modèle lu dans le sidecar à
  -- celui stocké pour déclencher la re-génération par le composant 2.
  embedding_model TEXT,

  -- Embedding du paragraphe, NULL si le fichier n'est pas vectorisé
  -- (politique d'embedding par fichier, exprimée dans le frontmatter du .md).
  -- Un nœud sans embedding n'est retrouvable qu'en BM25 (pg_search) sur `content`.
  embedding vector(1536),

  created_at TIMESTAMPTZ DEFAULT now(),

  -- Import = lecture d'un sidecar JSONL (sortie du composant 2), un sidecar par fichier,
  -- vectorisé ou non. Le manifest (1re ligne) porte les champs communs au fichier
  -- (source_file, source_file_hash, parent_source_file, heading_path, level, node_type ; embedding_model et
  -- dimension si le fichier est vectorisé) ; chaque ligne suivante (un paragraphe) devient
  -- une ligne de cette table, héritant des champs de son manifest.
  -- L'import est rejouable : à la re-génération d'un fichier, ses lignes sont d'abord
  -- supprimées (DELETE WHERE source_file = …) puis réinsérées, car la contrainte UNIQUE
  -- (source_file, chunk_index) ne suffit pas si le découpage change le nombre de chunks.
  UNIQUE (source_file, chunk_index)
);
Par défaut, je vectorise l'ensemble des documents — contenus sources et résumés — pour permettre la recherche sémantique vectorielle, tout en les indexant aussi en BM25 (pg_search) pour la recherche lexicale. Un fichier .md.jsonl est généré pour chaque fichier ; le sidecar d'un fichier non vectorisé contient les paragraphes sans embeddings, retrouvables uniquement en BM25.
Pour réduire le coût de génération des embeddings et accélérer le traitement, une variante économique consiste à ne pas vectoriser certains niveaux et à ne laisser sur ceux-ci que la recherche BM25. Par exemple : pas d'embedding sur le contenu brut des chapitres, recherche BM25 au niveau des paragraphes, recherche vectorielle réservée aux résumés (sections, parties, œuvre), quitte à charger ensuite les enfants d'un nœud retenu plutôt que le nœud entier.
Composant 4 : Service de recherche MCP du RAG
Après cela, je compte m'inspirer de mes projets sveltekit-ssr-ai-sdk-poc et toggl-pg-mirror pour implémenter le service MCP de recherche d'information dans le RAG.
Contrairement à ces deux exemples de service MCP, cette fois, je pense que je ne pourrai pas laisser l'agent IA générer en autonomie le code SQL pour faire ses recherches étant donné que la recherche devra vectoriser des chaînes de recherche et effectuer optionnellement du reranking en sortie.
La recherche s'effectue sur les paragraphes (lignes de la table, BM25 et/ou vectorielle selon la politique). Quand un paragraphe est retenu, je prévois de remonter à son nœud parent pour fournir au LLM un contexte élargi plutôt qu'un paragraphe isolé : le nœud parent est le fichier parent_source_file de la ligne retenue — résumé de section, de partie ou de l'œuvre selon la position — et la remontée consiste à charger toutes les lignes dont le source_file correspond à ce chemin. Un paragraphe du nœud racine (résumé de l'œuvre, niveau 3) n'a pas de parent.
Le choix du modèle de reranking (et sa limite de tokens par document) reste à définir.
Pourquoi je souhaite réaliser ce projet ?
Tout d'abord, je veux grok ce sujet.
Ensuite, je souhaite intégrer un RAG à mon projet sklein-convarchive.
Enfin, je souhaite l'utiliser pour générer des RAG pour divers livres pour permettre à mes agent IA de m'assister avec davantage de rigueur quand je travaille sur des sujets de science sociale.
Repository de ce projet
Dernière page.